Материалы выпуска: как инженер учится договариваться — Сергей Киселёв (Рубрика #Leadership) Собрал материалы нашего разговора с Сергеем Киселёвым, руководителем Development Platform в MWS Cloud Platform. Эфир Code of Leadership №83 прошёл 2 октября 2026 года. Говорили о том, как сделать полезную техническую систему, которой другие команды действительно будут пользоваться: даже хороший инструмент ещё нужно встроить в их работу. У Сергея за плечами студенческая компания в Иркутске, Яндекс, Yandex Cloud и создание платформы разработки нового облака. По дороге он несколько раз менял инженерную и управленческую роли — и навык организовывать людей каждый раз оставался с ним. Обсудили: 🔸 Рост инженера и самостоятельность команды Как управленческий опыт помогает после возвращения к коду и почему Сергей считает результатом руководителя команду, которая умеет работать без его постоянного участия. 🔸 Платформу через совместную разработку Инженеры платформы приходили в продуктовые команды, помогали писать сервисы и на этих задачах проверяли общие инструменты. Go, Kotlin, развёртывание и единый API требуют договорённостей с людьми, которые тебе зачастую не подчиняются. 🔸 Найм как общую инфраструктуру Задания, первые интервью, обучение интервьюеров и внутреннее сообщество. Сергей рассказывает, как процесс, начавшийся с его команды, стал помогать соседним направлениям. 🔸 Что происходит после восстановления сервиса Кто сообщает пользователям о сбое и кто возвращается к задачам из разбора. Обещание «быть внимательнее» плохо помогает, а записанное исправление может месяцами лежать в планах. 🔸 AI-агентов внутри платформы Сергей описывает доступ к документации через MCP и перенос командных правил в инструкции для агентов. При этом ограничения на передачу пользовательских данных и вопросы дальнейшей поддержки кода остаются. Материалы выпуска 📌 Страница выпуска 🎬 YouTube, VK Видео 🎧 Podster, Яндекс Музыка, Apple Podcasts 📝 Текстовый конспект Поделитесь, что у вас оказалось сложнее при развитии внутренней платформы: сделать инструмент или договориться о его использовании? #CodeOfLeadership #Leadership #Management #PlatformEngineering #DevOps #AI

Книжный куб
Канал Александра Поломодова (@apolomodov), cto & technical fellow. https://polomodov.tech - сайт со всеми материалами youtube.com/@tellmeabouttech - канал со всеми видео
-
-
SWE-agent: как интерфейс помогает модели работать с кодом (Рубрика #AI4SDLC) В Research Insights Made Simple №33 разобрал SWE-agent — работу команды Princeton с NeurIPS 2024. Интересно читать её вместе с продолжением этой истории: авторы сначала создали специальный интерфейс для модели, а позже в mini-swe-agent вернулись к минимальной конструкции с bash. Чтобы исправить ошибку в реальном проекте, нужно найти нужные файлы, разобраться в связях, внести изменения и проверить результат. Человеку помогают IDE, поиск и подсветка ошибок. Авторы предложили спроектировать рабочее место и для языковой модели — Agent-Computer Interface, или ACI. Веса модели при этом не меняли. В SWE-agent поиск помогает постепенно сузить область работы. Просмотр файла показывает номера строк и положение внутри документа. Команда edit заменяет диапазон строк и сразу возвращает обновлённый фрагмент. Если правка создаёт определённые ошибки линтера, система отклоняет её и показывает, что пошло не так. Старые ответы инструментов сокращаются, чтобы контекст не заполнялся предыдущими версиями файлов. Эти решения проверяли экспериментально. На 300 задачах SWE-bench Lite GPT-4 Turbo с полным SWE-agent решал 18% задач, а агент только с shell и демонстрацией решения — 11%. Без специального редактора результат снижался до 10,3%, с редактором без линтера составлял 15%. Это результаты конкретных конфигураций 2024 года; переносить проценты на сегодняшние модели нельзя. При чтении я отдельно отмечал цену ограничений. Линтер помогает не увязнуть в собственных ошибках, но может запрещать промежуточное состояние, необходимое для большой правки. Ограничение поисковой выдачи экономит контекст, зато заставляет делать дополнительные запросы. Каждое такое решение меняет возможную последовательность действий агента. А дальше модели стали лучше работать с shell. В mini-swe-agent та же команда оставила bash, линейную историю сообщений и независимые запуски команд. Авторы связывают упрощение с ростом возможностей моделей. Это продолжение истории, а не контрольный эксперимент исходной статьи. Мне кажется, четыре принципа SWE-agent сохраняют смысл: простые и компактные действия, содержательная краткая обратная связь и помощь в восстановлении после ошибок. Но реализацию стоит перепроверять. Окно в 100 строк и последние пять наблюдений — настройки конкретной системы, не универсальный рецепт. Полезно забрать и сам способ работы авторов: читать траектории, находить повторяющийся сбой, менять компонент и измерять результат. После смены модели стоит снова проверить, какую пользу приносит каждый элемент обвязки. Вчерашнее улучшение вполне может стать сегодняшним ограничением. P.S. Приложил whitepaper с моими заметками. Интересно, что он 100+ страниц, но основная часть укладывается в 10 страниц, а еще 10 добавляет расширенную версию про сам ACI. Дальше уже идут тексты программ, промты и так далее #AI4SDLC #Research #Agents #Evals #Engineering
-
edited SWE-agent или как интерфейс меняет результат / Research Insights Made Simple #33 (Рубрика #AI4SDLC) Через полчаса проведу прямой эфир Research Insights, где поговорю про статью из 2024 года «SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering» с NeurIPS 2024. В ней рассказывается про то, а что меняется, если дать той же языковой модели более удобный интерфейс для работы с репозиторием? Вместо разговора только о моделях и промптах посмотрим на действия агента и обратную связь, которую он получает. В программе будет - Поиск по коду и чтение файлов: как агент находит нужное и сохраняет ориентиры. - Многострочные правки и проверка синтаксиса: как предотвращать ошибки и восстанавливаться после них. - Управление контекстом: что показывать модели, что сокращать и что сохранять. - Результаты SWE-bench и SWE-bench Lite: с чем сравнивают SWE-agent и что показывают абляции. - Выводы для современных агентов: какие принципы стоит перенести в свою систему, а какие настройки остались частью эксперимента 2024 года. #Engineering #AI4SDLC #AI #SystemDesign #Research
-
Factory и HumanLayer: сколько самостоятельности отдавать агентам (Рубрика #AI4SDLC) Посмотрел интересное видео доклада Tereza Tížková, которая занимается развитием Factory. Она выступала на AI Engineer World’s Fair 30 июня, а отдельная запись вышла 27 сентября. Здесь разговор уже про то, как вокруг агентов организовать разработку целиком. Это видео продолжает линию, когда в мае я уже разбирал доклад Luke Alvoeiro из Factory про их агента Droid и режим Missions. Там работа поделена между агентами: одни планируют, другие пишут код, третьи проверяют результат. Причём условия готовности записываются до реализации, а проверяющий не должен быть автором кода. Если возвращаться к свежему докладу Терезы, то по ее мысли software factory должна собирать обратную связь, выбирать задачи, выполнять их, проверять результат и запускать следующий круг. Для этого нужны три вещи: возможность менять модели и инструменты, долгая самостоятельная работа агентов и накопление знаний о проекте. Человек задаёт направление и решает, что стоит строить. К знакомой схеме здесь добавляются несколько полезных деталей. 🔸 Деньги В Factory модель подбирают под задачу: выбирают самую дешёвую из тех, которые, по оценке системы, должны справиться. При необходимости можно перейти на более сильную. Для длинной работы важно понимать, сколько стоит весь путь до принятого результата, включая проверки и повторные попытки. 🔸 Контекст Описания всех подключённых инструментов могут забить агенту память ещё до начала работы. Factory сначала показывает короткий каталог, а подробности подгружает по необходимости. По данным компании, в исследованных сессиях с использованием MCP это сократило входные токены в среднем примерно на 15%. В группе со 100+ инструментами, чьи описания загружались по мере надобности, средняя экономия была около 51%. Так что эффект сильно зависит от того, сколько всего подключено. 🔸 Подготовка команды Документация, тесты, понятный способ запустить проект и записанные правила работы нужны и агентам. Если сборку умеет запускать только один человек, а важные договорённости живут в переписке, агенту придётся разбираться с этим заново. У Factory такая проверка готовности называется Agent Readiness. И здесь интересно вспомнить Dex Horthy и его Why Software Factories Fail. Dex тоже делает инструменты для агентной разработки. Его HumanLayer — среда, где команда обсуждает планы агентов и проверяет изменения кода. У него другой акцент: проходящие тесты ещё не говорят, насколько легко будет менять систему через полгода. Поэтому Dex предлагает заранее обсуждать требования, архитектуру и устройство кода, а затем двигаться небольшими проверяемыми частями. При этом Dex признаёт: убедительно доказать, что агенты со временем делают код сложнее для сопровождения, он пока не может. Factory показывает, как организовать самостоятельную работу агентов и проверку результата. Dex подробнее разбирает то, что сложнее проверить тестами: устройство кода и способность команды дальше его менять. У обоих есть свой продукт и свой интерес в этом разговоре. Я бы совмещал эти подходы: автоматизировать исполнение, а важные решения об устройстве системы обсуждать до того, как агент напишет код. Я бы забрал отсюда три практические вещи: 1️⃣ Инженеру Перед запуском агента записать, что должно работать и как это проверить. После — убедиться, что можешь объяснить ключевые решения в полученном коде. 2️⃣ Платформенной команде Взять один репозиторий и проверить, может ли агент сам поднять окружение, найти правила проекта и запустить тесты. Каждую ручную подсказку стоит разобрать: чего не хватает в документации или инструментах? 3️⃣ Руководителю На небольшой задаче посчитать стоимость готового изменения: модели, проверки, переделки и время людей. Сравнить с прежним процессом и отдельно посмотреть, что произошло с качеством. #AI4SDLC #AI #Agents #Engineering #Management
-
edited Один дизайнер и сотни материалов (Рубрика #AI) В этом видео «One Designer + AI. Hundreds of Deliverables» меня зацепило, как дизайнер самой компании, что делает конфу AI Engineer, реагирует на большой объём работы. Он не кривит нос «фу, это не как в Figma» (это моя интерпретация возможного отношения ко всем этим AI инструментам:)), а меняет процессы и создаёт инструменты, которые помогают этот объём вывезти. Vincent Wendy, дизайнер из AI Engineer, рассказывает, как готовит материалы для конференции. По его словам, на 7000 участников и более 300 спикеров у них один дизайнер. Карточки, расписания, навигация — всё это нужно собрать, проверить и вовремя обновить. Он начинает с правил: шрифты, цвета, компоненты. Дальше вместе с Devin делает генератор карточек спикеров и инструмент для сборки расписаний из актуальных данных. Повторяющаяся работа превращается в выбор нужных данных и экспорт готового изображения. Мне нравится сам ход мысли. Если приходится снова и снова собирать похожие материалы, можно потратить часть усилий на инструмент, который поможет делать это дальше. Дизайнер знает, где именно у него уходит время и какие детали легко упустить. Из этого знания и вырастает задача для агента. А ещё в докладе есть хороший эпизод: понадобилось срочно исправить расписание, а кнопки редактирования в инструменте нет. Wendy просит Devin её добавить, меняет данные и выгружает новый PNG. Процесс продолжает меняться по мере того, как появляются реальные рабочие ситуации. Вот эта готовность пересобирать свою работу мне и интересна. Привычный инструмент остаётся полезным, но круг возможных решений расширяется. И создание небольшого приложения под собственную задачу становится частью работы дизайнера. P.S. Я упоминал этот кейс в выпуске 3 AImigo про AI-native организацию. #AI #Agents #Engineering #Product #Conference
-
3 AImigo S1E8: AI-native компания — материалы выпуска (Рубрика #AI4SDLC) Собрал материалы восьмого выпуска 3 AImigo «AI-native: что это значит для компании?». Эфир прошёл 2 октября 2026 года, запись опубликована 3 октября. С Алексеем Литвиновым и Евгением Сергеевым обсуждали, что должно измениться в компании, когда у каждого уже есть AI-помощник, а результат всё ещё ждёт согласования в соседнем отделе. Обсудили: 🔸 Как агенты становятся частью общей работы Алексей предлагает смотреть на взаимодействие агентов разных сотрудников, Евгений — на весь путь от намерения до результата, я — на перестройку процессов и организации. Это наши рабочие определения, а не единый стандарт AI-native. 🔸 Общий контекст и внимание человека Знания нужно поддерживать в актуальном состоянии, принятые решения — сохранять, а вопросы к человеку — ставить в очередь. Иначе ускорение агентов довольно быстро превращается в очередь к одному руководителю. 🔸 Эволюцию или революцию Я защищаю постепенные проверяемые изменения в большой компании; Алексей опасается, что так мы не успеваем за технологией. Пилоты, поддержка руководства и измерение всего пути продукта помогают проверить эффект: команда может ускориться и всё равно ждать соседние. 🔸 Готовый сервис или собственный инструмент Алексей рассказывает, как с агентом собрал систему подбора обучения за несколько часов. Евгений напоминает о готовых платёжных сервисах, а я — о поддержке и интеграциях. Несколько часов на прототип могут обернуться годами обязательств. 🔸 Куда деть освободившееся время Переобучить людей, найти новые продукты или сократить расходы? Тут мы тоже спорили: дополнительные возможности сами по себе не создают спрос на результат. Материалы выпуска: 📌 Страница выпуска 📖 Лонгрид об AI-native организации — отдельный разбор, подготовленный мной к эфиру: процессы, ответственность, проверка эффекта и первые 90 дней перехода 🎬 YouTube, VK Video 🎧 Podster, Яндекс Музыка, Apple Podcasts 📝 Текстовый конспект разговора Если уже перестраиваете работу вокруг агентов, расскажите, где сейчас упираетесь: в контекст, согласования, поддержку своих инструментов или поиск полезных задач? #AI4SDLC #AI #Management #Architecture #Podcast
-
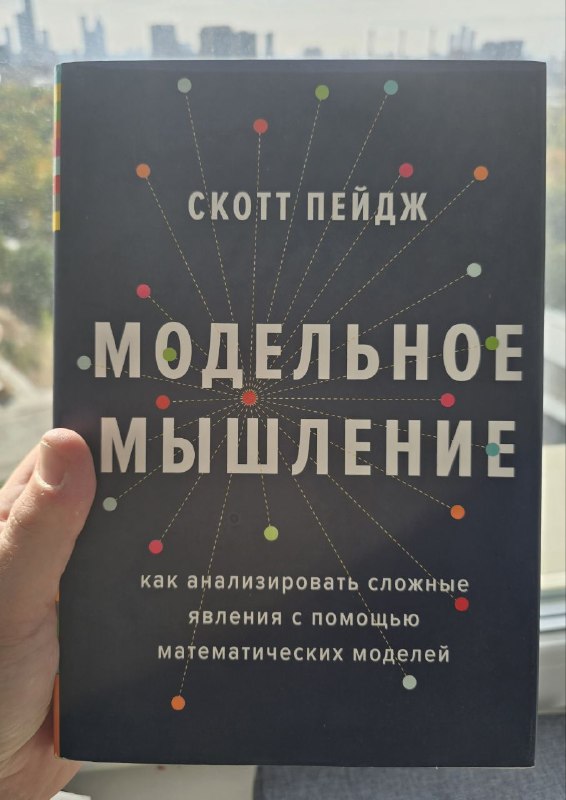
В процессе подготовки к переезду начал разбирать книжки и освобождать свою библиотеку. Наткнулся на кучу уже прочитанных книг, но задержался на этой книге Скотта Пейджа "Модельное мышление" (я делал ее обзор в своем блоге). Помню, что его одноименный курс на Coursera был для меня первым году так в 2013-2014 - я прошел его и дальше на волне восторга за следующие полтора года прошел 100+ семестровых курсов на Edx и Coursera. Книга в этом плане тоже превосходна - она учит применять разные математические модели для решения задач реального мира. И автор просто мастер в том, чтобы сделать такое обучение простым и увлекательным - я всегда хотел сам уметь объяснять сложные вещи простым языком, а у меня в лучшем случае получается их объяснять сложным:) В общем, рекомендую эту книгу всем, особенно тем, кто считает математику слишком абстрактной:)
-
Stanford CME295, лекция 1: как текст становится вычислениями (Рубрика #AI) Первая лекция курса Stanford CME295, о котором я уже рассказывал раньше, вышла интересной - за 1 час 44 минуты Афшин и Шервин Амиди объясняют, как превратить текст в числа, связать эти числа с контекстом и собрать из этого работающую модель перевода. Сильная сторона записи — каждая новая деталь появляется как ответ на конкретную проблему. Поэтому даже у довольно внушительной схемы Transformer постепенно становится понятно назначение отдельных блоков. Дальше я расскажу про основные моменты этой лекции 1️⃣ Токены: на какие кусочки нарезать текст? Можно брать целые слова, но тогда словарь разрастается, а незнакомые слова создают проблемы. Можно брать отдельные символы, но последовательности становятся длинными и дорогими в обработке. Часто используют промежуточный вариант — части слов. BPE собирает словарь, последовательно объединяя часто встречающиеся пары. Поэтому токен не обязан совпадать со словом, а способ разбиения зависит от данных, на которых обучали токенизатор. 2️⃣ Embeddings: как придать этим кусочкам полезное числовое представление? Номера в словаре лишь различают токены. Для работы модели каждому нужен вектор — набор чисел, который обучается вместе с ней. На примере Word2vec преподаватели показывают, как обучение на текстах позволяет получить полезные связи между словами. Но фиксированного вектора недостаточно: английское bank может означать банк или берег. Контекст меняется, а исходное представление слова остаётся тем же. 3️⃣ Attention: как учитывать окружающий текст? RNN и LSTM обрабатывают последовательность шаг за шагом, обновляя внутреннее состояние. Примерно как пересказывать книгу по одной постоянно обновляемой заметке: далёкие детали удерживать сложно, а вычисления зависят от предыдущего шага. Attention даёт прямые связи между представлениями токенов. Модель вычисляет веса этих связей и смешивает информацию с учётом полученных весов. Q, K и V удобно понимать как «что ищем», «по чему сопоставляем» и «какую информацию берём». Это поясняющая метафора: внутри всё происходит через обучаемые преобразования векторов. Self-attention позволяет обновить представление токена с учётом других токенов той же последовательности. 4️⃣ Transformer: как собрать детали вместе? В исходной архитектуре encoder строит представления входного текста с учётом контекста, а decoder по одному генерирует токены перевода, обращаясь к этим представлениям и уже полученному тексту. Информация о позиции помогает учитывать порядок. Маска запрещает подсматривать будущие токены при обучении. Слои нейросети преобразуют собранную информацию, а дополнительные связи и нормализация помогают обучать глубокую модель. В конце всё это проходят на одном предложении про плюшевого медвежонка: от токенизации до вероятностей следующего токена и готового перевода. Здесь особенно удобно сверить, как отдельные механизмы работают вместе. Разбирают именно Transformer из статьи 2017 года; другие семейства моделей заявлены в следующей лекции. Сама лекция будет полезна тем, кто уже пользуется LLM и хочет понимать их устройство, разработчикам AI-приложений и всем, кто начинает системно изучать тему. Подача доступная, но векторы, умножение матриц и базовые понятия обучения нейросетей пригодятся: преподаватели доходят до формул и размерностей. Я бы смотрел с паузами, а после сквозного примера попробовал нарисовать весь путь от текста до следующего токена самостоятельно. #AI #LLM #Learning #Engineering #Architecture
-


Камил видит руками (Рубрика #ForKids) Читаю своему пятилетнему сыну Кириллу перед сном эту книгу и она мне нравится. Книга написана легко и с юмором и дает пищу для размышлений и обсуждений с малышом. Сама книга про пятилетного мальчика Камила, его сестренку 6 лет и маму и папу. И все вроде как обычно, но Камил - незрячий, но это не мешает ему учиться и играть, бегать и кататься на велосипеде, шутить и веселиться. Каждая история в книге выглядит как маленький эпизод из жизни маленького Камила и мы видим как папа, мама и его сестра любят Камила и именно эта любовь позволяет ему расти без жалости к самому себе. Но не все окружающие так относятся к Камилу и мы видим, что иногда это особое отношение мешает. Именно поэтому в название вынесена фраза из истории про посещение музея, о том, что Камил видел экспонаты по своему - руками. В общем, это очень хорошая книга, рекомендую. #ForKids #ForParents
-
Где деньги в своих данных: цены, клиенты, ассортимент — материалы второго выпуска (Рубрика #Data) Собрал материалы второго выпуска «Где профит от данных, Лебовски?». Выпуск вышел 30 сентября 2026 года: мы с Андреем Цыбиным и Николаем Головым обсуждали, как заработать на данных внутри компании. В первом разговоре разбирались с продажей данных наружу. Теперь смотрим на то, что уже лежит в CRM, ERP, бухгалтерии и таблицах: можно пересмотреть цены, понять прибыльность клиентов или поменять ассортимент. Только после расчёта кому-то ещё придётся изменить свою работу — и разобраться, помогло ли это бизнесу. Обсудили: 1️⃣ Цены На истории Motor City Industrial разобрали, что происходит, когда подразделения назначают цены каждое по-своему, и как сведение продаж и цен помогает договориться об общем подходе. 2️⃣ Клиентов Большая выручка может скрывать большие расходы на поддержку, возвраты и время сотрудников. При этом убыточность клиента сама по себе не повод от него избавляться: есть связи между продуктами и сетевые эффекты. 3️⃣ Ассортимент Товар с небольшой собственной прибылью может приводить людей за всей остальной корзиной. Поэтому считать приходится ещё хранение, доставку, совместные покупки и заменители. 4️⃣ Разовый проект и регулярный процесс Николай предлагает начать с ограниченной задачи на доступных данных. Я возвращаю разговор к тому, какие правила останутся после проекта: цены и товары продолжат меняться, а люди — принимать решения. 5️⃣ Проверку эффекта Андрей ставит неудобный вопрос: если после изменения денег стало больше, точно ли помогло именно оно? Поговорили о наблюдении за покупателями, экспериментах и границе между корреляцией и причинностью. Кейсы взяли из публичных материалов поставщиков и консультантов. Они помогают разобрать механизм, но не раскрывают всех затрат на внедрение; наши оценки в разговоре не стоит принимать за готовую смету. Материалы выпуска: 📌 Страница с таймкодами 🎬 YouTube, VK Видео 🎧 Podster, Яндекс Музыка, Apple Podcasts 📝 Конспект на 7 минут чтения Где у вас обычно застревает работа с данными: в расчёте, в изменении процесса или в проверке результата? #Data #Product #Analytics #Management #Metrics
-
edited Как AI меняет роль техлида: запись круглого стола (Рубрика #AI4SDLC) Если агент пишет код, что остаётся техлиду — и как не превратиться в человека, который в одиночку проверяет все изменения команды? 30 сентября на Podlodka Techlead Crew мы с Рафаелом Тонаканяном из Сбера поговорили об этом. Разговор вели Игорь Антонов и Андрей Кулешов. Собрал материалы выступления у себя на сайте. Обсудили несколько вопросов, с которыми приходится разбираться, когда агенты становятся частью команды: - Как считать пользу AI с учётом времени на проверку и принятие результата? Количество токенов и сгенерированного кода само по себе мало что объясняет. - Где начинающему инженеру брать опыт, если первый вариант решения за него готовит агент? - Что проверять: сам код, постановку задачи, ход работы агента? Здесь поспорили — общего решения об отмене проверки кода у нас нет. - Что делать с очередью готовых правок и старыми задачами, которые теперь можно выполнить быстрее, но нужнее от этого они не стали? Можно посмотреть запись на YouTube или прочитать конспект. А ещё к разговору я подготовил лонгрид со своей позицией: про архитектуру, полномочия агентов, развитие команды и проверку эффекта. Он написан до круглого стола, поэтому это моя исходная рамка для дискуссии. #AI4SDLC #Agents #Engineering #Leadership #Management
-
Stanford CME295: погружение в основы LLM (Рубрика #AI) Начал изучать курс Stanford CME295 — Transformers & Large Language Models, который хочется порекомендовать всем. Это отличный способ погрузиться в основы: преподаватели буквально на пальцах объясняют сложные концепции. Сначала показывают, какую проблему нужно решить, разбирают её на простом примере, а дальше уже переходят к формулам. Так гораздо легче понять, зачем в модели вообще появилась та или иная деталь. Ведут курс братья-близнецы Афшин и Шервин Амиди — преподаватели Stanford ICME в статусе Adjunct Professor. Оба учились в École Centrale Paris, затем Афшин — в MIT, а Шервин — в Stanford. В первой лекции они рассказывают и про свой индустриальный путь: Uber, Google, сейчас — Netflix. На сайте уже есть все девять лекций 2025 года, поэтому можно сразу пройти весь курс. А буквально неделю назад, 25 сентября, стартовал поток 2026 года. По словам преподавателей, содержание заметно изменится: за год появились новые подходы к обучению моделей, агентам и самой генерации текста. Программа уже показывает, куда пойдут эти изменения. Всего запланировано девять лекций, и маршрут получается довольно последовательный: 🔸 Устройство модели: токены, векторные представления, attention и Transformer. Затем — семейства LLM, контекст и способы выбирать следующий токен при генерации. 🔸 Обучение: от предварительного обучения до SFT и RLHF, LoRA, обучения с подкреплением и дистилляции. 🔸 Системы и агенты: как ускорять работу моделей, хранить промежуточные вычисления, подключать инструменты, организовывать память и управлять контекстом. 🔸 Оценка и новые направления: как проверять качество моделей и агентов, где ошибается LLM-as-a-judge, что происходит с диффузионными языковыми моделями и мультимодальностью. Кстати, в версии 2026 года системам LLM и обучению с подкреплением выделили отдельные занятия, добавили лекцию про диффузионные LLM, а в программе про агентов появились MCP, сжатие контекста, skills и plugins. Так что даже после прошлогодних записей здесь будет за чем следить. Подача доступная, хотя знакомство с линейной алгеброй, математическим анализом и базовыми понятиями машинного обучения пригодится. Формулы здесь есть, и в них стоит разбираться. На сайте доступны слайды и краткий конспект; домашних заданий у курса нет, зато есть два экзамена. В следующем посте разберу первую лекцию нового потока, запись которой вышла на этой неделе, 28 сентября. Там как раз собирают фундамент: от разбиения текста на токены до Transformer и сквозного примера перевода предложения. #AI #LLM #Learning #Engineering #Agents
-
Заходите на прямой эфир с Сергеем Киселевым, head of devplatform в MWS, где мы обсудим тему "Как инженер учится договариваться"
-
Anthropic: кто будет делать следующий ИИ (Рубрика #AI) Если ИИ помогает создавать следующую, более сильную модель, он может ускорять и собственное развитие. Для нас это означает возможное сокращение времени между появлением новых инструментов и очередной перестройкой работы под них. В перспективе человеку придётся управлять исследовательскими агентами, которые выполняют всё больше работы самостоятельно. И понимать, когда пора вмешаться. В материале Anthropic есть график, глядя на который я задумался и записал вопрос про сходимость тренда к 2027 году. По данным компании, в марте 2026-го Claude вёл 1% исследовательских и инженерных работ, а в августе — уже 26%. ИИ как минимум сотрудничал с человеком более чем в 90% работ. Проценты относятся к взвешенной корзине категорий задач внутри Anthropic. Слово «вёл» здесь означает определённый уровень самостоятельности. 17 июня 2026 года Jean-Stanislas Denain, Joe Kwon и Anson Ho предложили шкалу от 0 до 5 в публикации Epoch AI. В начале шкалы ИИ либо не используется, либо помогает с отдельными частями работы. Дальше меняется распределение инициативы: - AL3: агент делает большие куски, человек постоянно направляет и собирает результат. - AL4: агент получает общую задачу и выполняет большую часть работы; человек наблюдает, корректирует и утверждает. - AL5: задача выполняется целиком при минимальном участии человека или без него. Например, на AL4 можно поручить агенту починить сломавшийся конвейер данных: он найдёт причину, внесёт изменения, проверит их и принесёт отчёт. Решение о внедрении останется за инженером. В августовском срезе Anthropic нет измеренных категорий R&D уровня AL5. Теперь понятно, откуда взялся 2027 год. Между мартом и августом доля AL4 росла примерно на пять процентных пунктов в месяц. Если продолжить этот темп, к лету 2027-го получится около 76% работ как минимум уровня AL4, а к концу года линейный расчёт упрётся в 100%. Это моя условная экстраполяция. Она предполагает, что темп сохранится и оставшиеся задачи окажутся сопоставимы с уже переданными агентам. Но среди них могут быть выбор исследовательского направления, оценка неожиданного результата и решение, куда потратить огромный вычислительный бюджет. Агент, который реализует эксперимент, ещё может зависеть от человека, который придумал, что проверять. А дальше в статье появляются примерно 30 тысяч одновременно работающих агентов — на одной внутренней платформе Anthropic. Тут человеческое «я всё посмотрю» требует довольно серьёзного уточнения :) Компания измеряет охват мониторингом, задержку проверки и долю блокировок или эскалаций. У неё заявлен 100% охват действий на этой платформе. Охват показывает, что проверка встроена в процесс; чтобы судить о её качестве, нужно знать, сколько опасных действий она пропускает. Мне понравилась деталь с постоянной идентичностью агентов: история сохраняется при смене модели, сообщения связаны с авторами и исходными данными. Можно восстановить, кто предложил решение и откуда оно взялось. При этом общий канал связи способен распространять и общую ошибку — возможность проверить источник ещё надо использовать. С вычислениями похожая история. Расход удобно учитывать, но доля ресурсов «на безопасность» зависит от классификации работ и их эффективности. Она может снизиться из-за экономии вычислений при том же объёме работы над безопасностью. Сведения об автоматизации собирает Claude, оценивает их тоже Claude. Для доверия к таким числам важны общая методология и внешняя проверка. Похоже, нас ждёт всё больше процессов, где человек выбирает направление, агенты выполняют работу, а другие агенты помогают её проверять. Если этот цикл начнёт устойчиво улучшать следующие модели, ускорение может стать гораздо заметнее. Тогда способность вовремя обнаружить ошибку, восстановить ход решений и остановить процесс станет такой же важной, как способность его запустить. P.S. Я часто веб-версии таких статей превращаю в PDF, чтобы спокойно почитать их на планшете и параллельно писать заметки прямо поверх них - так мне лучше думается #AI #Agents #Research #Engineering #Metrics #Security
-
3 AImigo S1E8: AI-native: что это значит для компании? (Рубрика #Management) Раздать сотрудникам AI-инструменты — и компания стала AI-native? Или придётся заново продумать, как устроены её продукт, процессы и команды? В пятницу, 2 октября, в прямом эфире 3 AImigo поговорим об AI-native компаниях. Попробуем разобраться, что стоит за этим понятием и как оно меняет подход к созданию и развитию бизнеса. Обсуждать будем втроём: Евгений Сергеев, Алексей Литвинов и я. У нас разная оптика: управление большой инженерной организацией, практическое внедрение AI-Assisted Engineering и архитектура AI4SDLC. Не будем искать одну «правильную» картину - сравним наши взгляды. Подискутируем на темы: - Чем AI-native компания отличается от компании, в которой активно используют AI. - Что стоит строить иначе, если сегодня запускаешь бизнес с нуля. - Как подступиться к такой трансформации в уже работающей организации. - Где AI даёт бизнесу новые возможности и что для этого должно измениться в работе людей и агентов. Три ведущих, три взгляда: Евгений Сергеев, Алексей Литвинов и Александр Поломодов. Подключайтесь к эфиру. А пока напишите в комментариях: какой признак убедил бы вас, что компания действительно стала AI-native? #AI #Management #Leadership #Processes #Engineering #Software
-
edited 
AMD договорилась купить World Labs за $8,2 млрд (Рубрика #AI) Я уже разбирал доклад Фей-Фей Ли о пространственном интеллекте и возвращался к этой идее в обзоре AI Trends 2026, в части про Physical AI. Теперь её World Labs должна войти в AMD — и здесь интереснее всего то, как меняется роль производителя ускорителей. Компания получит лабораторию, которая создаёт модели трёхмерного мира и технологии обучения роботов, а значит, сможет участвовать в разработке самих задач, под которые проектирует железо. Сначала про статус: соглашение подписано 26 сентября 2026 года, анонс AMD и форма 8-K опубликованы 28 сентября. Цена — примерно $8,2 млрд с оплатой акциями. Закрытие ожидается до конца года и зависит от согласований. После него Фей-Фей Ли должна стать главным научным сотрудником AMD с подчинением Лизе Су. Что именно получает AMD? 1️⃣ Marble — инструмент генерации трёхмерных сцен из текста и изображений. Эти сцены можно исследовать и экспортировать, в том числе для робототехнических симуляторов. 2️⃣ Atlas — представленную 1 сентября модель, которая объединяет текст, изображения, видео и 3D в общий пространственный контекст. По описанию World Labs, она восстанавливает сцены, генерирует новые ракурсы и наблюдения виртуальных камер робота. Доступ пока ранний; неизвестные части мира модель может достраивать по предположению. 3️⃣ SceniX, которую World Labs приобрела в июле, — технологии переноса реальных робототехнических задач в симуляцию. Здесь уже важны поведение объектов, контакты и возможность проверять модели управления. Последний пункт объясняет практический смысл. На настоящем роботе каждая попытка стоит времени: вернуть предметы на место, восстановиться после ошибки, повторить эксперимент. В симуляции можно варьировать расположение вещей, освещение и физические параметры, искать неудачные сценарии и выбирать, что проверять на оборудовании. World Labs показывает такой цикл real-to-sim-to-real на манипуляциях с кабелями, упаковке и передаче объектов. Это демонстрации самой компании. Они ещё не доказывают, что подход одинаково хорошо работает на любых роботах и задачах. Красивая 3D-комната тоже сама по себе не гарантирует правильного трения или деформации кабеля. Зачем это AMD и что дальше? AMD прямо связывает покупку с разработкой будущих вычислительных систем. Моё прочтение: внутри компании появится постоянная обратная связь между исследователями моделей и инженерами, что создают hardware. Генерация среды, обучение робота и массовое тестирование создают разные нагрузки; команда сможет раньше обнаруживать ограничения вычислений, памяти и обмена данными. Основа уже есть: по сообщению World Labs, с 2025 года она работала с AMD над обучением и оптимизацией инференса на её GPU. Дальше я бы следил за тремя вещами: - Eскорением существующих моделей на AMD - Независимыми проверками переноса из симуляции в реальность - Влиянием этих задач на будущие вычислительные системы Это возможное развитие, а не объявленный roadmap. Отдельный вопрос — открытость. Marble уже используют вместе с NVIDIA Isaac Sim. Пока неясны лицензии будущих моделей и условия поддержки стороннего оборудования. Оценить успех покупки можно будет по стоимости полного цикла: создать среду, обучить робота, найти слабые места и подтвердить улучшение в реальности. Если этот цикл станет заметно дешевле и быстрее, у AMD появится сильный аргумент за свою платформу. #AI #Robotics #Engineering #Infrastructure #Bigtech
-
Заходите на прямой эфир с Никитой Белокопытовым, где мы с ним поговорим про его карьеру и обсуддим вопрос "А зачем руководителю возвращаться к коду"
-
edited Материалы выпуска: как руководить тем, в чём пока не разбираешься — Леонид Черный (Рубрика #Leadership) Можно сделать поиск лучше конкурента — и всё равно услышать от пользователя: «А зачем мне переходить?» В разговоре с Леонидом Черным эта история про Яндекс в Турции хорошо объясняет, почему при смене области нельзя просто перенести знакомые решения на новое место. Собрал запись и конспект нашего Code of Leadership S2E23 от 29 сентября. Леонид — автор канала Irregular CDO; за плечами Cybiko, Nival, Яндекс, Rambler, «МегаФон», oneFactor и Uzum. Прошлись по его карьере и поговорили о ситуации, когда руководить уже надо, а команда понимает предмет лучше тебя. Что есть в выпуске: 🔸 Тестирование с нуля Как подработка за найденные баги привела к управлению тестировщиками, а потом к построению процессов качества в Nival. И почему умение объяснить ожидаемый результат пригодилось не только в тестировании, но и в работе с издателями. 🔸 Другой рынок — другие ограничения «Аллоды Онлайн» в Японии и Корее, культурная адаптация игры и поиск в Турции. В истории Леонида посетители кофейни выбирали выдачу Яндекса без указания бренда, но не собирались менять привычный Google. Хорошие внутренние метрики ещё не дают человеку причины переключиться. 🔸 Право спорить с начальником Придя в «МегаФон», Леонид начал с отношений, собственной учёбы и попытки убедить команду: если видишь, что руководитель неправ, скажи до решения. Поговорили и про пределы защиты команды — людям всё равно придётся учиться работать с организацией вокруг. 🔸 CDO без полномочий За одной должностью могут стоять регламенты, хранилище или коммерческие задачи машинного обучения. Поэтому вопрос «за что отвечаю?» стоит задавать вместе с вопросом «на какие решения могу влиять?». Материалы выпуска: 📌 Страница выпуска 🎬 YouTube, VK Видео 🎧 Podster, Яндекс Музыка, Apple Podcasts 📝 Конспект на 7 минут чтения Если вы переходили руководить в незнакомую область, что оказалось труднее: освоить предмет или перестать решать всё привычным способом? #CodeOfLeadership #Leadership #Management #Product #Data
-
edited Как обычно превосходный юмор и очень точное попадание во всех топ-менеджеров AI компаний. Не знаю как Kai Lentit это делает, но он просто феерически хорош.
-
Как инженер учится договариваться (Рубрика #Leadership) 2 октября в 10:30 по МСК в прямом эфире поговорим с Сергеем Киселевым о том, как меняется инженер, когда от его решений начинает зависеть всё больше людей. У Сергея больше десяти лет работы с инфраструктурой Яндекса и Yandex Cloud, а с 2023 года он строит Development Platform в MWS Cloud Platform. Ещё он входит в программный комитет DevOops и ведёт канал «Буду погроммистом!» (https://t.me/intr13_riot). Мне интересно это сочетание ролей: Сергей делает инструменты для коллег, нанимает инженеров и помогает выбирать, о чём говорит сообщество со сцены. Хочется проверить, как инженерные убеждения выдерживают встречу с людьми, сроками и последствиями собственных решений. Обсудим: - Что пришлось пересмотреть при переходе из Яндекса в MWS и что сильному инженеру труднее всего перестать делать самому, когда он становится руководителем? - Как появляются общие правила платформы: кто вправе отказаться от стандарта и кто платит за отсрочку миграции, если команда уже пообещала клиенту срок? - Как в найме отличить совместимость с командой от желания нанимать похожих на себя — и как через полгода заметить собственную ошибку отбора? - Что делает руководитель в аварии: когда самому разбираться с техникой, а когда взять на себя коммуникацию? Вспомним доклад Сергея на HighLoad++ о большом инциденте. - Что сегодня стоит за словом DevOps и чему начинающему инфраструктурному инженеру учиться самому, если часть рутины забирает AI? Попросим Сергея отделить случившиеся примеры от прогнозов и назвать позицию, которую он готов оспорить у самого себя. А под конец — про прикладную аудиофилию из описания его канала. Приходите, если растёте из инженера в руководителя, строите платформу для других команд или участвуете в найме. И приносите свои вопросы. #Management #Leadership #Engineering #PlatformEngineering #Software #Processes
- Older posts