Залетайте в прямой эфир про профит от данных, который начнется через 5 минут. Там наше творческое трио: Андрей Цыбин, Николая Голов и я, будет разбирать конкретные примеры монетизации своих данных компаниями внутри. Точно будет интересно и полезно, особенно, если вы придете со своими вопросами и зададите их нам

Книжный куб
Канал Александра Поломодова (@apolomodov), cto & technical fellow. https://polomodov.tech - сайт со всеми материалами youtube.com/@tellmeabouttech - канал со всеми видео
Subscribers
15.8K
tracking since 24 Oct
Reach per post (ERR)
14.1%2.2K avg views
Posting
3.5/day
last 22 hours ago
Reactions per 1K views
5.7
❤ 🔥 👍
-
-
edited 
Начал вчера вечером читать книгу "Человек из будущего" про Джона фон Неймана. Треть книги уже прочел и она просто превосходная - я люблю биографии ученых, мне нравится математика и квантовая физика, а еще история ... В этой книге всего это с избытком. Думаю, что сегодня-завтра ее дочитаю и расскажу про нее подробнее, но уже могу рекомендовать всем желающим. P.S. Архитектура обычного компьютера с CPU называется архитектурой фон Неймана - Джон был очень разносторонней личностью и повлиял и на computer science / software engineering:)
-
Материалы выпуска Research Insights #32: vLLM и PagedAttention (Рубрика #AI) Собрал материалы сольного выпуска Research Insights Made Simple от 28 сентября 2026 года — про vLLM и PagedAttention. История о том, как идея страничной памяти из операционных систем помогла эффективнее обслуживать запросы к LLM. Это был разбор сентябрьской статьи 2023 года "Efficient Memory Management for Large Language Model Serving with PagedAttention" Модель уже поместилась на GPU, но рядом с её весами нужно хранить ещё и KV-кеш — ключи и значения обработанных токенов для каждого активного запроса. Ответ растёт, кеш растёт вместе с ним, а будущая длина ответа заранее неизвестна. Если резервировать память с запасом, места для соседних запросов остаётся всё меньше. Вот тут и пригодился учебник по операционным системам. В выпуске разобрал: 🔸 Куда уходит память Резерв под будущие токены, незаполненные участки и фрагментацию — и почему даже знание длины ответа не решает все проблемы размещения. 🔸 Как устроен PagedAttention Таблица связывает логические блоки запроса с физическими блоками GPU, а новые блоки выделяются по мере необходимости. 🔸 Как делить общий префикс Несколько вариантов ответа используют одни KV-данные, а при изменении общего блока включается копирование при записи. 🔸 Что делать, когда память всё-таки закончилась Перенести состояние в память CPU или удалить и потом вычислить заново: у каждого варианта своя цена. 🔸 Почему более медленное ядро может ускорить весь сервис Экономия памяти позволяет обрабатывать больше запросов одновременно; результат нужно измерять вместе с задержкой. В статье 2023 года авторы получили рост пропускной способности в 2–4 раза относительно FasterTransformer и Orca при сопоставимой задержке. Это результат их экспериментов с конкретными моделями и нагрузками. Для сегодняшнего сервера выигрыш придётся измерять заново. Материалы выпуска: 📌 Страница выпуска с таймкодами 📊 Слайды 🎬 YouTube, VK Видео 🎧 Podster, Яндекс Музыка, Apple Podcasts 📝 Текстовый конспект Если уже настраивали vLLM под свою нагрузку, расскажите в комментариях, во что упёрлись и что дало заметный выигрыш. #AI #LLM #Inference #Architecture #ResearchInsights #Engineering
-
edited Интересно смотреть в прямом эфире, а что Сэм расскажет про планы и результаты OpenAI Ниже интересные моменты, что мне понравились - Dots - аля Jarvis (под капотом Astra + все те же коннекторы, что вы уже подключили) - Chat GPT Space - место для взаимодействия Dots и людей - Dots для ChatGPT Pro будут доступны и общение с ними не тратит usage - Dots для Enterprise будут еще и типизированными, которые смогут работать над некоторыми доменами (маркетинг, ...) - Sol 6.1 почти как Astra, но в 5 раз дешевле - Ultrafast - в 8 раз быстрее за 6х стоимость - Pro 500$, Pro 200$, Pro 100$ (и одновременный shrink лимитов для Pro 200) - Decision API для быстрых решений:) - AI Research Intern - Codex Harness in the cloud (и Codex Security Cloud) - Agents API (+ Computer Use) - OpenAI Private Intelligence (ZDR, zero data retention) - Partner Apps - токены из подписки, что можно использовать и в других приложениях - Plugins extensions - можно делать приложения прямо в ChatGPT - OpenAI marketplace Интересно, что часть из этого анонсили раньше и мы даже разбирали это в выпуске 3 амиго в пятницу
-
Где деньги в своих данных: цены, клиенты, ассортимент | Где профит от данных, Лебовски #002 (Рубрика #Data) Как найти прибыль в данных, которые уже есть у компании, и довести находку до результата? 30 сентября в 12:00 по мск во втором выпуске подкаста «Где профит от данных, Лебовски?» обсуждаем в прямом эфире монетизацию данных внутри бизнеса: решения по ассортименту, условиям обслуживания клиентов и ценам. Берём три публичных кейса из материалов Николая Голова и разбираем, что должно произойти между анализом и прибылью. - Начнём с ассортимента и пройдём всю цепочку: заметить проблему, собрать данные, предложить изменение, оценить затраты, внедрить и проверить эффект - Затем посмотрим на стоимость обслуживания клиентов — cost-to-serve. - Третий кейсом будет ценообразование в B2B-дистрибуции. Как обнаружить точку роста в привычном процессе? В финале сравним офлайн-кейсы с онлайн-бизнесом: как отличаются поиск возможностей, эксперименты и проверка результата. Как обычно, нас будет трое и все со своим strong opinion:) - Андрей Цыбин - взгляд со стороны продуктовой аналитики и онлайн-экспериментов - Николай Голов - взгляд со стороны дата-архитектуры и продуктовой разработки платформы данных - Александр Поломодов - взгляд со стороны software архитектуры, AI4SDLC и инженерного лидерства #Data #Product #Analytics #Architecture #Management
-
repost 
Мы проводим Heisenbug уже 10 лет и каждый раз задумываемся: какие темы волнуют людей в этом году? Год назад мы выясняли, чем занимаются тестировщики: какие инструменты используют, в каком окружении тестируют. Сейчас решили сосредоточиться на другом — что мешает развивать инженерную культуру: автоматизацию, внедрение инструментов, практики тест-дизайна. А еще хотим узнать, как вы используете ИИ на проекте: что получается хорошо, а что мешает. Нам важны ответы тестировщиков, разработчиков, аналитиков и руководителей — всех, кто причастен к обеспечению качества. Поделитесь ссылкой с коллегами, которые тоже связаны с тестированием. Среди участников разыграем 3 офлайн- и 6 онлайн-билетов на Heisenbug 2026 Autumn. На открытии конференции покажем первые результаты, а немного позже — всем, кто примет участие и оставит свой email в опросе, пришлем отчет о результатах исследования вместе с графиками. Принять участие в опросе P.S. Вопросов много — пожалуйста, постарайтесь ответить на все. Если времени мало, ответьте хотя бы на вопросы про препятствия.
-
Друзья из JUG.RU проводят исследование по поводу состояния дела в тестировании. Возможно, аудитории канала будет интересно в нем поучаствовать
-
Приходите на прямой эфир с Леонидом Черным на тему "Как руководить тем, в чём пока не разбираешься"
-
Every: когда AI-эксперимент пора превращать в продукт (Рубрика #Management) После выхода новой AI-модели легко набрать идей на пересборку всего продукта. При этом у команды остаются клиенты, обязательства и план. Дэн Шиппер, сооснователь и CEO Every, предлагает выделить маленькую лабораторию, которая исследует новые возможности, пока продуктовая команда развивает то, что уже работает. Я уже разбирал его доклад об устройстве Every. В этом новом 18-минутном выступлении на Lenny and Friends Summit интересен следующий шаг: как понять, что эксперимент заслуживает дальнейших вложений. Кстати, масштаб компании здесь стоит держать в голове. По словам Шиппера, на момент записи 10 сентября 2026 года в Every около 30 человек. Его предложение о лаборатории из одного-двух сотрудников опирается на опыт небольшой организации. Шиппер разделяет два режима работы 1) Исследование требует пробовать разные подходы, допускать дублирующие эксперименты и спокойно выбрасывать результат. 2) Развитие продукта требует фокуса, надёжности и понятного опыта для клиентов. Когда каждый постоянно занимается обоими, команда тянет себя в разные стороны. Для лаборатории он предлагает пару «пират + архитектор» - Пират быстро собирает грубые прототипы и ищет полезное - Архитектор превращает перспективную находку в систему, которую можно поддерживать и развивать Шиппер предлагает заранее смириться с тем, что около 90% экспериментов отправятся в корзину. Это его установка для поиска, а не измеренный норматив успешности. Дальше начинается самая содержательная часть: люди должны возвращаться к инструменту для своей работы. Сначала его пробуют внутри команды или с несколькими ранними клиентами. Затем проверяют, сохраняется ли польза, когда первый восторг прошёл. Шиппер прямо предлагает посмотреть на результат через месяц. Он называет три критерия продвижения эксперимента: - Пользуются ли им люди и возвращаются ли к нему? - Насколько он лучше существующего решения? Его ориентир — «в 10 раз», без строгой методики измерения в докладе. - Можно ли обслуживать клиентов по приемлемой стоимости, если использование вырастет? Хороший пример — Kate Bench, помощник для редакторской правки. Шиппер рассказывает, что несколько лет экспериментировал с AI на основе правок главреда Кейт. Когда Кейт начала пользоваться результатом и инструмент стал распространяться среди коллег, появился повод подключить архитектора. Тот добавил учёт принятых предложений и правок, которые Кейт приходится делать после агента. По словам Шиппера, объём её работы над такими правками сократился на 12% относительно предыдущего месяца. Это внутренний результат Every; методику расчёта он подробно не раскрывает. Но сама последовательность полезна: рабочий прототип → регулярное использование → вложения в систему и измерение результата → проверка с клиентами. Здесь есть граница, которую легко пропустить. Шиппер не задаёт порога: сколько пользователей должно вернуться, с какой частотой и за какой срок. Регулярное использование у него даёт основание продолжить разработку. Коммерческую состоятельность ещё предстоит проверить. И переносить опыт Every стоит с учётом их бизнеса. Они превращают даже неудачные эксперименты в публикации, привлекающие читателей и потенциальных клиентов. В другой компании такой способ окупать поиск может не сработать. Из этого подхода я бы забрал в еженедельный разбор экспериментов один вопрос: кто продолжает пользоваться результатом в своей работе через месяц и что именно ему это даёт? Ответ помогает решить, куда направить следующую неделю разработки. #Management #AI #Product #Engineering #Metrics
-
edited What Makes a Good Productivity Metric? (Рубрика #Management) В «All Models Are Wrong» я разбирал, почему продуктивность инженеров требует нескольких измерений. Теперь прочитал «What Makes a Good Productivity Metric?» Коллина Грина, Сьеры Джаспан и Маджеда Самада из Google — про то, как проверить отдельную метрику. На полях отметил вывод: регулярность рабочего графика может быть важнее частоты посещения офиса. Но именно здесь захотелось поспорить. 1️⃣ Сначала начнем с того, а что авторы вообще измеряют Руководителям нужно было понять, учитывать ли в политике гибридной работы и частоту посещений, и регулярность расписания. Это разные свойства: два офисных дня каждую неделю могут быть заранее известны, а могут каждый раз выпадать неожиданно. Авторы рассмотрели 13 метрик и выбрали Weekly Markov Consistency. Она оценивает, насколько предсказуем статус человека (офис, дом, не работает) по статусу в тот же день предыдущей недели. В основе марковская энтропия, результат нормирован от 0 до 1. 2️⃣ Хорошую метрику они предлагают проверять по четырём признакам 1) Её смысл можно объяснить людям, принимающим решения. 2) Она отражает ожидаемые закономерности. 3) У неё нет свойств, искажающих важные случаи. 4) Она полезна для принятия решений. Дальше начинается самая полезная часть: проверка на примерах. Исследователи добавляли случайные изменения в регулярные расписания, сравнивали разные виды гибрида, смотрели сезонность. Восемь участников оценили 50 расписаний; оценки людей положительно коррелировали с метрикой. Проверили и то, что она слабо коррелирует с частотой посещения офиса. На полях я назвал понятное объяснение «shortcut для мозга». Сложная формула вполне может иметь ясный смысл. Только лёгкость объяснения ещё не гарантирует, что мы правильно поняли число:) 3️⃣ Вот пример уже из моего разбора формулы Человек чередует целую рабочую неделю в офисе с целой неделей дома, выходные неизменны. Метрика даст 1: переходы полностью предсказуемы. Хотя статус каждого рабочего дня меняется относительно прошлой недели! При сравнении через 28 дней он уже повторяется, но результат остаётся тем же. Метрика улавливает предсказуемость переходов, которая не требует еженедельного повторения графика. Для планирования такое чередование может быть совершенно удобным. И здесь вспоминается разбор про скорость и предсказуемость сборок из той же серии: человеку нужно понимать, как организовать следующую часть работы. 4️⃣ А что со связью с продуктивностью? Авторы сообщают: у инженеров с регулярным гибридным графиком на 1–3 офисных дня в неделю CL throughput — поток изменений кода — был неотличим от показателя регулярно работавших из офиса всю неделю. Данные охватывают десятки тысяч инженеров, но в короткой статье нет размеров эффектов и подробностей анализа, достаточных для проверки причинного вывода. Возможно, сама организация работы позволяет и поддерживать график, и выпускать изменения. К тому же один throughput не охватывает качество, обучение и помощь коллегам. В разборе про исчезновение техдолга я уже обсуждал, почему счётчики изменений могут пропустить полезный эффект. Меня здесь интересует гипотеза: регулярность помогает через планирование и координацию. Но тогда нужно знать, было ли расписание заранее известно коллегам и совпадало ли у них время для совместной работы. У двух людей могут быть идеально регулярные офисные дни, которые никогда не пересекаются. Я бы проверял всю цепочку: график известен заранее → нужное взаимодействие состоялось → стало меньше ожидания и сорванных договорённостей. Это уже предложение к исследованию, а не результат статьи. Если заранее согласованный, но меняющийся график помогает не хуже постоянного, что именно стоит закреплять в политике компании? #Management #Engineering #Productivity #Research #Metrics
-
Заходите на прямой эфир с разбором статьи про vLLM, где v означало вирутальную память - ключевую идею статьи еще 2023 года, чьи идеи теперь стали стандартом де-факто в мире инференса LLM.
-
edited Зачем руководитель возвращается к коду (Рубрика #Leadership) 1 октября в 11:00 по МСК в прямом эфире поговорим с Никитой Белокопытовым (@WhiteNightNiki, linkedin) о том, что происходит с инженерным руководителем, когда он снова может многое сделать сам. У Никиты опыт мобильной разработки и руководства инженерными командами — в том числе в Nepos, AutoScout24 и Playrix, а недавно он перешёл в Bluefish и занимается там Applied AI. Повод для разговора — его собственные посты. В одном Никита пишет, что часть управленческих слоёв станет не нужна, и рассказывает, как сам вернулся к практической разработке. В другом — что люди продолжают отвечать за системы, которые проектируют и проверяют машины. С такими тезисами интересно спорить предметно, на конкретных историях. Обсудим: - Когда инженер впервые отвечает за результат продукта целиком, а не только за свой код? - Какое управленческое решение за других людей Никита пересмотрел бы сегодня? - Зачем руководителю снова садиться за разработку и как понять, когда задачу лучше сделать самому, а когда отдать команде? - Как устроен один реальный AI-процесс: кто ставит задачу агенту, где нужен человек и как проверяют результат? - Какие задачи менеджера действительно исчезают — и что инженер должен уметь объяснить без AI, прежде чем взять ответственность за изменение? Попросим Никиту отделить личные наблюдения от прогноза и назвать условия, при которых его тезис про менеджмент не работает. Приходите, если руководите командой и снова тянетесь к коду или решаете, куда расти дальше — в управление или обратно в инженерию. И приносите свои вопросы. #CodeOfLeadership #AI4SDLC #Management #Leadership #Engineering #Product
-
edited Материалы 3 AImigo S1E7: генерация дешевеет, проверка дорожает (Рубрика #AI) Готовы материалы седьмого выпуска 3 AImigo — дайджеста за сентябрь, который вышел 25 сентября 2026 года. Вместе с Евгением Сергеевым и Алексеем Литвиновым собирали новости месяца, а я подключался прямо с DotNext. К эфиру подготовили шесть блоков и 24 факт-карточки, но разговор быстро ушёл от заготовок, так что карточки и дека живут отдельно, а конспект следует записи. Сквозная мысль всё равно сохранилась: генерация дешевеет, а преимущество смещается от самой модели к системе вокруг неё — обвязке, наблюдаемости, ограничениям для агентов и юнит-экономике. Обсудили 1️⃣ Обвязка агента как продукт OpenAI 10 сентября открыла публичную бету Agents API — ту же обвязку, что работает в Codex. Евгений сравнил лабораторию, которая делает и модель, и обвязку, с Apple, а универсальные инструменты — с Windows. Мой довод корпоративный: свою обвязку дорого сделать и согласовать, а за купленную отвечает поставщик. 2️⃣ Токены, тарифы и облачные агенты По расчёту Алексея, для полной оркестрации агентов с GPT-6 Astra ему понадобилось бы около 600 подписок по $200 в месяц. Я вижу в новых тарифах и облачных агентах путь от оплаты токенов к оплате работы агентов — это наша интерпретация, а не заявление провайдеров. 3️⃣ Безопасность Сильные модели всё чаще обходят выставленные ограничения, а сгенерированный код нередко работает, но не проходит проверку безопасности: в бенчмарке, который привёл Алексей, Fable 5.1 правильно решает 87% задач, а требованиям безопасности отвечают 37%. Отсюда предложение не ждать от одной модели всех ролей сразу и разделить автора и критика. 4️⃣ Агент как продакшн-сервис Аналитика Codex показывает результаты работы, а не только расход, GitHub Copilot отдаёт трейсы агентов по OpenTelemetry, AWS ограничивает действия инструментов. Провайдер обвязки видит весь путь изменения вплоть до ревью — и сможет продать самый точный отчёт, если компания отдаст ему ещё и данные о людях. 5️⃣ Фронтир дорожает, продакшн дешевеет Обсудили заявленное OpenAI решение варианта задачи Навье — Стокса (доказательство ещё проверяют) и то, почему перебор тысяч агентов хуже работает в науках с медленной проверкой гипотез. А на прикладной стороне — модель Jev для калиброванного выбора: в эксперименте команды Евгения генерация экрана ускорилась примерно на порядок. Вывод: прототип на фронтирной модели, продакшн — на дешёвой и дообученной. Материалы выпуска: - Страница выпуска с таймкодами - Видео: YouTube, VK Видео - Аудио: Podster, Яндекс Музыка, Apple Podcasts - Текст: конспект разговора А где у вас сейчас узкое место — в генерации или уже в проверке того, что сгенерировали агенты? И присылайте новости, которые стоит разобрать в октябрьском дайджесте. #AI #AI4SDLC #Agents #Engineering #Security #Podcast
-
edited 
«Зверский детектив»: читаем с детьми Сегодня дочитали с пятилетним сыном Кириллом «Щипача» из серии «Зверский детектив» Анны Старобинец. Последнюю неделю я читал ему эту книгу перед сном и не только - самому было очень интересно, что же будет дальше. Захватывающая история получилась. У серии есть и экранизация — мультсериал «Барсукот. Очень зверский детектив», который мы с удовольствием смотрели с детьми. Так что про книжки и мультфильм хочется отдельно напомнить тем, кто ищет что-нибудь для совместного чтения и просмотра. Но с «Щипачом» не все так просто - в какой-то момент Кириллу стало страшно от того, как развивается история. Для меня это был увлекательный детектив, а для пятилетнего ребёнка некоторые повороты оказались слишком тревожными, а закончилось все слезами, так как "птичку жалко". В общем, книга — топ, читать её мне было в удовольствие. Но именно «Щипача» я бы советовал читать с детьми постарше. P.S. Щипач - это 4 книга из серии и она еще не экранизирована, а предыдущие уже есть в виде мультиков. #Books #ForKids #Detective #Family
-
edited Материалы выпуска: команда с ИИ — разговор с Димой Твердохлебовым (Рубрика #Leadership) Собрал материалы разговора с Димой Твердохлебовым — основателем Omnius.team (@dimatverdai), в прошлом продуктовым руководителем в VK и руководителем AI-направления МТС. Эфир Code of Leadership прошёл 24 сентября 2026 года. В анонсе я обещал разговор о переходе из больших компаний к собственному делу, но больше всего времени в итоге ушло на практику: как агентство из девяти человек внедряет генеративный ИИ у крупных заказчиков и при этом не превращает основателя в единственную точку координации. Сам Дима оценивает свою организацию на три-четыре балла из десяти относительно того, какой хочет её видеть. Так что это рассказ о работе в процессе, а не готовый рецепт. Обсудили: 1️⃣ Пилот на внешних данных По опыту Димы, у крупных заказчиков внедрение чаще тормозит желание держать всё во внутреннем контуре и повторить там возможности облачных моделей, чем техническая сложность. Omnius.team начинает с задач, где данные идут снаружи внутрь: результат показывают тем, кто принимает решения, и уже потом обсуждают интеграцию, документацию и интерфейсы. Отдельно проговорили, что удачный пилот — ещё не изменение основного бизнеса. 2️⃣ Три кейса Мониторинг налогового законодательства для нефтяной компании, помощник для рекламы в Telegram и поиск замен строительных материалов, где шестнадцать агентов смотрят на разные ограничения, а отдельные критики оспаривают их выводы. Сравнение «30–40 минут вместо месяца работы двух-трёх аналитиков» — оценка гостя, независимого замера нет. 3️⃣ Общая память команды Девять самостоятельных специалистов связывает внутренний помощник: он видит встречи, почту и календари, напоминает о договорённостях, а задачи в Linear появляются как отражение обсуждений. Правила помощника уточняют на реальных ошибках — например, разговор один на один о зарплате не должен уехать в общий чат. 4️⃣ Знания вне пересоздаваемого кода Если реализацию можно сгенерировать заново, требования, причины решений и проверки стоит держать отдельно от неё. А при ошибке агента исправлять не только код, но и условия, которые к ней привели. Читать код всё равно придётся: кто-то должен проверить результат. 5️⃣ Найм и talant.club Дима ищет людей, которые уже пробовали решать свои задачи с ИИ, умеют ясно формулировать мысль и хотят делать полезные вещи. В talant.club несколько проверенных команд предлагают готовые решения под одну спецификацию, заказчик выбирает вариант, а победитель получает половину бюджета. На момент разговора в сообществе пять человек, так что это ранний эксперимент. Материалы выпуска: 📌 Страница выпуска с таймкодами 🎬 YouTube, VK Видео 🎧 Podster, Яндекс Музыка, Apple Podcasts 📝 Текстовый конспект разговора Финальный совет Димы руководителям — самому решить одну небольшую задачу с ИИ, чтобы дальнейшие решения опирались на собственный опыт. Если уже пробовали, расскажите: какую задачу выбрали первой — и что после этого поменяли в работе команды? #CodeOfLeadership #AI4SDLC #Management #Leadership #Engineering #Product
-
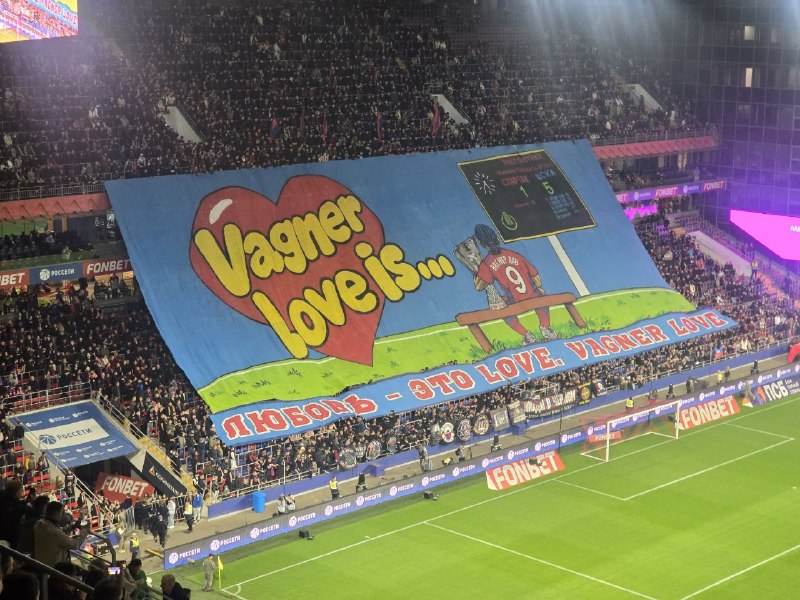
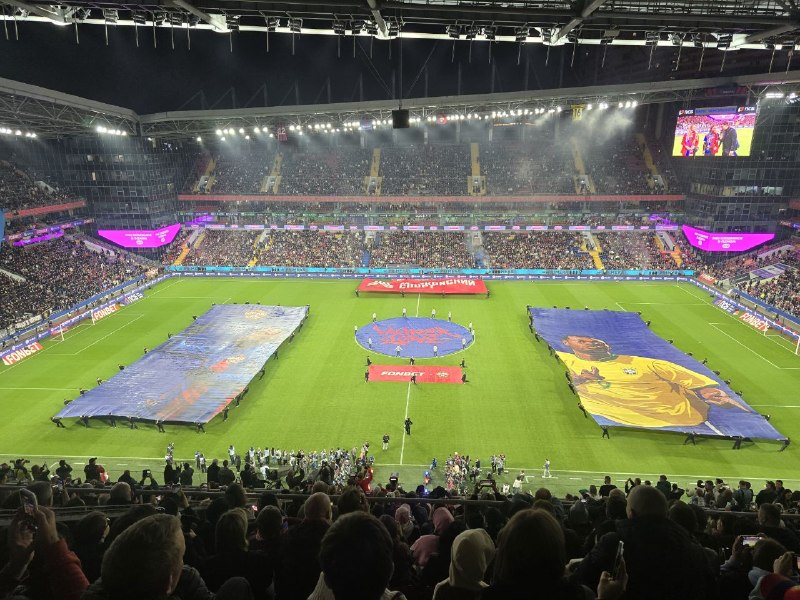

Добрались с сыном на прощальный матч Вагнера Лава. Так много давно знакомых имен, элемент шоу, ... В общем, очень красиво провожают легенду клуба
-
edited System Design Space: задачи, эксперименты и проверка знаний (Рубрика #SystemDesign) В июле я рассказывал про русский язык материалов, новые ML/AI-темы и черновик книги. С июля у system-design.space появился большой практический блок: можно самому спроектировать систему, устроить ей отказ и проверить, насколько хорошо понял прочитанное. Из того, что стоит попробовать: 1️⃣ 45 задач для самостоятельного проектирования В разделе практики — задачи от TinyURL и чата до RAG-системы и платформы AI-агентов. Каждая ведёт по семи шагам фреймворка интервью: требования, границы системы, потоки данных, модель данных, технологии, масштабирование и эксплуатация. Сначала собираете своё решение, потом сравниваете с эталонным разбором. Есть короткие задачи на 40 минут и более длинные на час. 2️⃣ 8 лабораторных, где можно что-нибудь сломать Они работают прямо в браузере: например, можно устроить массовое истечение кэша, изолировать реплику, проверить миграцию схемы под нагрузкой или переключение между регионами. У лабораторных общий ритм: предсказать поведение, внести отказ, проверить результат и разобрать, почему получилось именно так. Хороший способ обнаружить, в каком месте знакомая схема перестаёт быть понятной :) 3️⃣ Отдельный каталог из 20 интерактивных моделей В playgrounds можно покрутить алгоритмы консенсуса и балансировки, репликацию, B-tree и LSM, MVCC, TCP и другие механизмы. Сначала фиксируете прогноз, затем запускаете модель и сравниваете с наблюдением. Настройки эксперимента можно передать ссылкой, результат — экспортировать. 4️⃣ Проверка знаний и повторение На странице треков появились входная диагностика, учёт освоенных навыков и интервальное повторение с экспортом карточек в Anki. Освоение навыка учитывается по проверочным заданиям, практикам и лабораториям; одной отметки о прочтении главы для этого недостаточно. Прогресс хранится в браузере. Чтобы продолжить на другом устройстве, можно выгрузить и импортировать учебный архив — вместе с закладками, треком и результатами практики. 5️⃣ Ещё 19 глав — теперь в библиотеке 327 Добавились разборы горячих ключей и перебалансировки, распределённых блокировок, аномалий транзакций, Outbox/Inbox/CDC, миграций без простоя и изоляции арендаторов. Есть стенограмма пробного интервью по RAG-платформе, материалы про offline-first и выбор технологий, обзоры Agentic Design Patterns и ранней версии Regenerative Software. Всё — в каталоге материалов. 6️⃣ Редизайн и более спокойная цветовая схема Заодно переделал оформление сайта: у страниц теперь общий синий акцент, а разноцветные подложки, менявшиеся от главы к главе, уступили место более спокойной палитре. Цветовые выделения помогают различать предупреждения, риски и полезные выводы. Привёл к единому виду карточки, заголовки и основной текст, доработал контраст в светлой и тёмной темах — чтобы при чтении длинных материалов меньше отвлекаться на оформление. Если давно не были на сайте, то теперь есть повод зайти и глянуть на изменения, а если что-то не работает, то теперь в главах внизу есть кнопка "Предложить исправление", которое приводит к заведению Issue в репо https://github.com/polomodov/system-design-space-community #SystemDesign #Architecture #DistributedSystems #Engineering #Interview
-
Материалы выпуска: чему заново учится CTO в новой отрасли — разговор с Фёдором Сухаревым (Рубрика #Leadership) Собрал материалы разговора с Фёдором Сухаревым, бывшим Head of Solutions в Arrival и Head of Technology в QIC Digital Hub. Эфир Code of Leadership прошёл 23 сентября 2026 года. За плечами у Фёдора биллинг в CBOSS и Orange, электронная торговая площадка OTC.ru, электромобили и страхование. В анонсе я писал, что меня больше всего интересует, как при таких переходах меняется само понимание «продукт готов». Ответ вышел конкретным: с собой переносится способ разбираться в задаче, а решение каждый раз приходится выбирать заново. Мы обсудил много интересных тем и вот, что рассказал Федор 1️⃣ Знакомое решение против экономики В Orange первым порывом было купить уже знакомый биллинг, но расчёт стоимости склонил к перестройке собственной системы. Заодно появились контроль версий, Jira и ограничения на прямую работу разработчиков в продакшене. 2️⃣ Альфу, бету и гамму для автомобиля В Arrival единицей планирования стала функция, которая затрагивает несколько систем. Альфа — рабочий прототип: разработчик с ноутбуком идёт к машине и не уходит, пока новая железка не заработает. На бете подключается тестирование с мягкими порогами по багам, гамма — готовность к эксплуатации. Так интеграция начинается с первой итерации, а не тогда, когда все команды закончат свои части. 3️⃣ Требования, которые не расходятся с тестами. Четыре уровня — бизнес, функция, система, компонент, — а Polarion после изменения требования подсвечивает связи, где нужно перепроверить тесты. Отделение драйверов от общей управляющей логики помогло, когда приоритет сместился с автобуса на фургон. 4️⃣ Что вообще считать продуктом В QIC подход ужали до трёх уровней, но несколько месяцев ушло на словарь: «продуктом» называли и мониторинг, и переезд в Google Cloud, и мобильное приложение. Зато всплыли системы без владельцев — безопасность находила в них уязвимости, а чинить было некому. 5️⃣ Микросервисы по конкретной причине Расчёт цены полиса, формирование документа и проверки вынесли в сервисы на Go из монолита, который развивала другая компания группы. Фёдор подчёркивает: выбор оправдала зависимость от чужого темпа изменений, универсальным рецептом он его не считает. Ещё Фёдор устроил мини-викторину про происхождение инженерных практик. На code review я угадал не совсем :) Я предположил второе мнение врача, а Фёдор напомнил про производственные корни — формальные инспекции Майкла Фагана в IBM в 1976 году. Дальше обсудили, что у ревью бывают разные цели: найти ошибки, познакомить с системой, держать код единообразным. Если команда не может назвать свою, ревью легко превращается в карго-культ. И честная часть про пределы инженерного влияния. По словам Фёдора, Arrival не хватило финансирования до выхода в производство, а в QIC сокращение бюджета остановило часть проектов. Слаженная инженерия сама по себе не гарантирует, что бизнес выживет. Материалы выпуска 📌 Страница выпуска с таймкодами 🎬 YouTube, VK Видео 🎧 Podster, Яндекс Музыка, Apple Podcasts 📝 Текстовый конспект Если переходили в новую отрасль, расскажите: что из прошлого опыта пригодилось сразу, а от какого привычного решения пришлось отказаться? #CodeOfLeadership #Leadership #Management #Career #Architecture #Engineering
-
edited 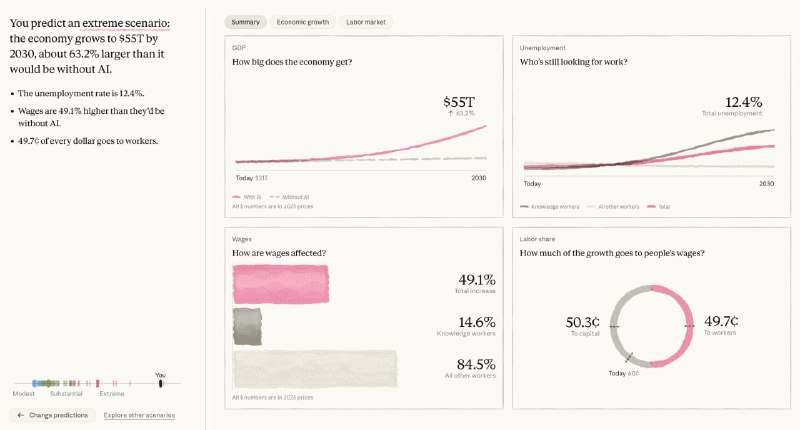
Anthropic: три сценария экономики с AI до 2030 года (Рубрика #AI) Прогнозы влияния AI на экономику расходятся на порядок: от «плюс процент к ВВП» до «ВВП удваивается за пять лет». Спорить о них тяжело, потому что каждый считает по своей модели. Экономисты Anthropic Institute (Антон Коринек, Чарльз Джонс и соавторы) в сентябре 2026 года выпустили работу «Economic Scenarios for Transformative AI» на 50+ страниц и интерактивный Economic Scenario Explorer (я осилил именно его). Мне в них интересна сама идея: спор о будущем превращается в спор о нескольких числах, которые можно измерять. Стартовую точку на середину 2026 года модель берёт из данных об использовании Claude, в том числе из "Anthropic Economic Index", про который я уже рассказывал. 1️⃣ Как устроена модель Экономика здесь — набор задач. AI затрагивает только «когнитивные» профессии: менеджмент, профессионалов, продажи и офис, это 62,4% занятых в США. Стройку, ремонт, уход и транспорт модель не трогает, роботов в ней нет. Сценарий задают пять ручек: - какую долю задач AI умеет делать; - где им реально пользуются; - во сколько раз он ускоряет задачу; - заменяет он человека или усиливает; - сколько вытесненный человек ищет работу в другой профессии. 2️⃣ Три сценария к 2030 году (относительно траектории без AI) - Скромный, «как интернет»: ВВП +1,6%, безработица 3,9% против 3,8%. - Существенный: ВВП +8,3%, рост 5,4% в год (пик доткомов — 4,7% в 1999-м), доля труда в доходе падает с 60% до 56%, безработица когнитивных работников растёт с 2,9% до 4,5%. - Экстремальный: ВВП +32%, рост 15% в год, доля труда 45%, зарплаты когнитивных работников на 11,5% ниже траектории без AI, их безработица 17,9%, общая 11,9%. 3️⃣ Что мне кажется главным Механика во всех сценариях одна: выпуск растёт, когнитивная занятость сжимается, остальные профессии выигрывают (в экстремальном сценарии их зарплаты на 34% выше траектории без AI). Сценарии спорят только о масштабе и скорости. Прирост в модели уходит прежде всего владельцам капитала: в экстремальном сценарии трудовой доход остаётся примерно на уровне «без AI», а доход на капитал вырастает на 81%. По оценке авторов, проигравших можно компенсировать переводом около 9% ВВП, но сами по себе такие переводы исторически не происходили. И неприятная деталь: сценарии расходятся в основном после 2027 года, поэтому по сегодняшним данным не понять, в каком из них мы живём. Авторы прямо пишут, что это не прогноз и вероятностей у сценариев нет. Упрощения серьёзные: только США, нет роботов, финансовых шоков и реакции политиков, а вытесненный работник сразу получает зарплату новой профессии без потерь за стаж. 4️⃣ Попробуйте на себе В Explorer можно ответить на пять вопросов и получить свой 2030 год. Для сравнения: в августе 2026 года авторы опросили 10 980 американцев, и медианный ответ дал примерно существенный сценарий. Кстати, оказался в своих предсказаниях еще более экстремальным, чем самый экстремальный вариант авторов (именно мое предсказание на картинке, что приложена к посту) Но помимо просто получения предсказания полезнее перенести рамку на свою профессию. Выпишите задачи обычной недели с долей времени и для каждой ответьте: - может ли AI сделать её сейчас, к 2027-му, к 2030-му; - пользуетесь ли вы им там уже; - работает он вместо вас или вместе с вами; - какие новые задачи появились у вас благодаря AI. Доля «вместо вас» — ваш личный уровень автономии AI, новые задачи — то, что модель называет reinstatement. Отдельно честно оцените, сколько месяцев займёт переход в соседнюю роль. Подсказка из отчёта: из безработных менеджеров и профессионалов, нашедших работу, вне когнитивных профессий оказываются лишь 10%, в продажах и офисе — 28%. Прогоните свой вариант и напишите в комментариях, какой сценарий получился для вашей профессии и какая ручка сдвинула его сильнее всего. #AI #Research #Management #Metrics
-
Материалы выпуска Research Insights Made Simple #31: AI4SDLC — что бы я делал по-другому (Рубрика #AI4SDLC) Собрал материалы сольного выпуска Research Insights Made Simple от 22 сентября 2026 года. Это режиссёрская версия моего lightning talk с Deep Tech Night: на конференции было 15 минут, а в эфире — почти полтора часа. Помощник для управления проектами хорошо работает на задачах своей команды, но теряется на проектах, разнесённых по нескольким трекерам. Часть пользователей просто молча перестаёт его открывать. Взять модель посильнее? Сначала нужен набор реальных задач, на котором такую замену можно проверить. В выпуске разобрал cледующие моменты 1️⃣ Граница владения и build/buy решения Модели и базовый агентный цикл арендовать, контекст и адаптеры к внутренним системам дорабатывать, а права, идентичность агента и доказательства качества держать у себя. 2️⃣ Полномочия и инструменты Умение агента спланировать исправление ещё не даёт права его выполнить, а механическая обёртка OpenAPI в MCP не делает инструмент удобным для агента. 3️⃣ Проверка качества Демонстрация, трассировка и проверочный набор отвечают на разные вопросы. Удачные и неудачные задачи стоит сохранять и прогонять при каждой смене модели, контекста или обвязки. 4️⃣ Экономика Когда работа разбита на проверяемые инженерные эпизоды, можно пробовать меньшие модели и отделять планирование от исполнения. А собственные доработки придётся регулярно перепроверять: следующая модель может справиться с той же задачей без накопленных обходных решений. Материалы выпуска: 📌 Страница выпуска с таймкодами 📊 Слайды доклада 🎬 YouTube, VK Видео 🎧 Podster, Яндекс Музыка, Apple Podcasts 📝 Текстовый конспект Какую часть AI-стека вы уже сделали своей? И когда последний раз проверяли, что она всё ещё лучше готового решения? #AI4SDLC #AI #Agents #Architecture #PlatformEngineering #Evals
- Older posts