AI меняет разработку. Что теперь важно инженеру? (Рубрика #Engineering) Выступил сегодня на DotNext с keynote докладом, где взял идею Чада Фаулера и книгу "Regenerative Software" (рассказывал о ней раньше) и рассказал как меняется индустрия, если код уже не то место, где находится ground truth о системе. Конечно начал я с трех слайдов про состояние индустрии, и трех слайдов про большой финтех, но дальше было много интересного с кучей историй из практики - с большим удовольствием потом пошарю видео, но пока можно полистать сам доклад, краткое саммари которого представлено ниже. 1️⃣ Ускорить написание кода — ещё не значит быстрее доставить результат. AI уже стал повседневным инструментом, но системный эффект не приходит автоматически. Больше кода и PR — больше нагрузки на проверку. Узкие места смещаются в постановку задач, ревью и приёмку. Особенно важным становится решение: что вообще стоит делать, а от чего отказаться. 2️⃣ Эффект требует перестройки всего цикла. На примере финтеха с 10 000+ инженеров: агентам нужна общая платформа с доступом к моделям и инструментам, политиками, песочницами и наблюдаемостью. Они работают с тестами, безопасностью, инцидентами и миграциями. Результат измеряется принятыми изменениями, временем ожидания, переделками и надёжностью поставки. 3️⃣ Знание о системе должно переживать её код. Ядро доклада — Regenerative Software Чада Фаулера. Реализацию можно заменять, если вне неё сохранены семь вещей: намерение, архитектурные границы, проверки поведения, причины решений, правила скорости изменений, безопасного удаления и сокращения сложности. Простой мысленный тест: если код исчезнет, сможете ли вы восстановить систему и доказать, что она работает правильно? Ответ показывает, где на самом деле хранится ваше понимание. 4️⃣ Перед заменой нужно извлечь то, что знает только старая система. В зрелом коде спрятаны бизнес-правила, последствия инцидентов и неочевидные зависимости — включая ручную работу людей. Сначала нужно выявить эти требования и защитить проверками. Затем менять систему по частям, сохраняя возможность отката и убирая накопленную сложность. 5️⃣ Работа инженера смещается к ответственности за систему. Формулировать намерение, задавать ограничения, собирать контекст, управлять агентами и независимо проверять результат. Не делегировать целиком то, ошибочность чего пока не умеешь распознать. Чем дешевле становится код, тем ценнее инженерное суждение. #Engineering #Software #AI #Leadership #AI4SDLC #Agents #SystemDesign

Книжный куб
Канал Александра Поломодова (@apolomodov), cto & technical fellow. https://polomodov.tech - сайт со всеми материалами youtube.com/@tellmeabouttech - канал со всеми видео
-
-
Забегайте на прямой эфир 3 AImigo, где мы поговорим про новости сентбяря
-
Фелинне Херманс: доступность программирования и цена понимания (Рубрика #AI4SDLC) Если ИИ снимает синтаксические барьеры, а человек сохраняет понимание задачи и контроль над решением, разве это не продолжение той же идеи доступности, которую Фелинне Херманс защищает через Hedy? С этого противоречия хочется начать разбор её доклада «AI made me doubt everything about programming» на DDD Europe 2026. Про Hedy и её книгу "The Programmer’s Brain" я уже рассказывал. Херманс занимается обучением программированию, и её претензия к профессии вполне конкретна: мы слишком часто принимаем сложность за ценность, а техническую возможность — за достаточную причину что-то делать. 1️⃣ Сложность как знак качества По словам Херманс, исследования электронных таблиц встречали возражения: разве это настоящее программирование? С Hedy возник похожий вопрос: что исследовать в языке, который делает программирование проще? Между тем Hedy позволяет учиться на родном языке и вводит синтаксис постепенно. Для начинающего это вполне ощутимая польза. Объяснение она находит в неожиданном месте — статье о феминистской гляциологии. Авторы разбирают, как образ героического покорителя ледников влияет на признание исследователей и чьё знание остаётся за кадром. Херманс видит похожий механизм в нашей профессии: трудное и эффектное получает больше уважения, чем доступное и полезное. С таким снобизмом стоит спорить, но аналогия ещё не доказывает, что так устроено всё программирование. Сложность бывает и ценой простоты для пользователя. Хороший компилятор внутри тоже устроен непросто. 2️⃣ Понимание программы Здесь она обращается к Питеру Науру и Programming as Theory Building. В его представлении разработчик строит связную модель того, как программа решает задачу. Может объяснить решения, их ограничения и то, как систему менять. На мой взгляд, это самая сильная часть доклада. Работающий результат ещё не гарантирует, что кто-то понимает, почему он работает. Но отсюда не следует, что использование ИИ обязательно разрушает понимание. Модель можно просить сравнить варианты, найти контрпример, помочь проверить предположение. Получилось ли разобраться — отдельный вопрос, который нельзя закрыть красивым объяснением самой модели. 3️⃣ Инструменты можно выбирать Через работу Натана Энсменгера Херманс обсуждает шахматы как модельную задачу ИИ. Удобная проверяемая цель формирует представление о прогрессе, но переносить его на человеческие задачи нужно осторожно. А превосходство шахматного движка не обязывает разрешать его помощь в турнире. С правом выбора согласен. Только в шахматном турнире самостоятельность игрока входит в условия задачи. В разработке автоматизация вполне может помогать получить нужный результат. Одной аналогии для выбора здесь недостаточно. Человек сохраняет понимание И вот теперь вернёмся к вопросу в начале. В нём спрятано самое трудное условие: «человек сохраняет понимание». Hedy специально выстраивает путь обучения. ИИ позволяет получить готовое решение, этот путь пропустив. Поэтому считать их равнозначными инструментами тоже было бы слишком удобно. Но если работа с ИИ помогает человеку сформулировать задачу, разобраться в ограничениях и проверить решение, она вполне совместима с идеей доступности Херманс. Её аргументы дают основания требовать такого процесса. Чтобы отвергнуть его, нужно показать, где именно он перестаёт работать. Я бы проверял это следующим изменением требований: сможет ли человек объяснить, что теперь придётся поменять и почему? Особенно интересно задать этот вопрос тому, кто весь код написал сам:) #AI4SDLC #AI #Engineering #Learning #Conference
-
edited 
Завтра у меня интересный день, где будет сразу 3 активности, на которых вы можете поймать меня 1️⃣ В 10:30 буду в оффлайне открывать DotNext с keynote докладом о том, как меняется индустрия разработки под влиянием AI - тут я устал рассказывать старую историю и поэтому поговорю про будущее, спасибо Чаду Фаулеру и его книге "Regenerative Software", а также метафоре феникса и морской звезды (подробнее про книгу в моем разборе) 2️⃣ В 13:00 прямо с конфы DotNext проведу прямой эфир с друзьями из 3 AImigo, где мы будем обсуждать AI-дайджест за август - приходите послушать и позадавать вопросы на трансляцию 3️⃣ В 17:00 продолжу на DotNext участием в дискусии "IDE vNext: кто построит дом для ИИ-агентов?" 4️⃣ А закончу день участием в афтепати - если есть желание меня поймать и пообщаться за чашечкой пива, то это можено будет сделать вечером пятницы на DotNext:) В общем, если будете на DotNext, то можем развиартуализироваться, а если нет, то можете в онлайне позадавать вопросы Жене Сергееву, Леше Литвинову и мне в рамках подкаста 3 AImigo.
-
Разбор whitepaper о vLLM: KV-кеш, PagedAttention и быстрый инференс | Research Insights #32 (Рубрика #Inference) Модель поместилась в GPU, тестовый запрос отработал быстро. Что произойдёт, когда одновременно придут сотни запросов с разной длиной контекста и ответа? 28 сентября 2026 года в 11:00 по мск в прямом эфире Research Insights Made Simple #32 разберу whitepaper 2023 года про vLLM и устройство инференса LLM: как управление памятью, планирование запросов и передача состояния между узлами влияют на скорость сервиса. Начнём с KV-кеша — ключей и значений уже обработанных токенов, которые модель сохраняет для следующих шагов генерации. Посмотрим, как PagedAttention применяет идеи виртуальной памяти к этому кешу и позволяет эффективнее размещать активные запросы на GPU. А дальше разберём, какие задачи приходится решать вокруг движка. Выпуск для инженеров, архитекторов и платформенных команд, которые разворачивают LLM, выбирают движок инференса или хотят понять, что происходит за API модели. Исследование PagedAttention, SOSP 2023: "Efficient Memory Management for Large Language Model Serving with PagedAttention" Все выпуски Research Insights Made Simple доступны на сайте Напишите в комментариях, во что упирается ваш инференс: память, ожидание первого токена, паузы при генерации или стоимость обслуживания. #vLLM #LLM #ResearchInsights #RnD #Infrastructure #DistributedSystems #OpenSource
-
edited Команда с ИИ: что меняется в работе руководителя | Code of Leadership S2E22 с Димой Твердохлебовым (Рубрика #Management) Сегодня в 11 утра будет прямой эфир Code of Leadership с Димой Твердохлебовым — основателем Omnius.team, в прошлом продуктовым руководителем в VK и руководителем AI-направления МТС (@dimatverdai) Поговорим о том, как меняется руководитель, когда после больших компаний начинает строить собственную. Здесь интересен сам переход: какие навыки помогают, от каких привычек приходится отказываться и что происходит с управленческими убеждениями, когда правила теперь устанавливаешь ты. Начнём с карьеры Димы: геймдев, YouDo, Яндекс, Эвотор, VK, МТС. Как он переходил от работы над продуктом к ответственности за людей, какие решения оказались трудными и почему в какой-то момент решил выйти из найма. А дальше — собственная команда, люди и AI-агенты. Обсудим вопросы - Где заканчивается возможность делать всё самому, даже если под рукой несколько агентов? - Что можно делегировать модели, кто проверяет результат и как работа продолжается без постоянного участия основателя? - Кого нанимать в такую команду: какие инженерные и продуктовые навыки действительно нужны, как их проверить на собеседовании? - Какие корпоративные процессы хочется вернуть, когда сам начинаешь отвечать за сроки, качество и чужую работу? Отдельно разберём talant.club. Проект предлагает собирать несколько независимых команд под одну задачу бизнеса. Тут сразу хочется понять, как выбирают решение, оплачивают работу участников и совмещают конкуренцию с обменом знаниями. И кто потом поддерживает то, что получилось. Ещё поговорим о границе между быстрым пилотом и работающим сервисом у заказчика: что остаётся после демо, кто занимается интеграцией и по чему судить о результате. Попросим Диму разобрать конкретные решения и рассказать, что сегодня он сделал бы иначе. Приходите, если руководите командой, развиваете продукт или думаете о собственном деле с ИИ. И приносите вопросы — оставим время для чата. #Management #Leadership #Engineering #Software #Product #Processes #Data
-
SWE-bench: как выбирать агента, когда рейтинг не различает лидеров (Рубрика #AI4SDLC) У одного агента 79,2%, у другого 78,8%. Можно покупать победителя? На 500 задачах разница — всего два дополнительных решения. Мне здесь интересен момент, когда точные цифры начинают обещать больше, чем мы действительно измерили. В "Coding Agents Have Converged" Fengshuo Liu из Imperial College London и соавторы разобрали 254 опубликованных результата SWE-bench. Статья вышла 15 сентября 2026 года (версия v1 статьи); авторы открыли код анализа. Новых агентов они не запускали: проверяли, какие выводы позволяют сделать уже собранные данные с агентами из 2023 - 2025 годов. SWE-bench Verified — 500 задач из GitHub: агент готовит исправление, проверочная система запускает тесты. У первой десятки в изученной выборке 285 общих успехов и 51 общий провал. Различаются результаты только на 164 задачах. Представьте двух кандидатов, которым дали одинаковую контрольную. Оба решили по 396 заданий: 378 общих, ещё по 18 каждый решил самостоятельно. Это реальные числа двух лидеров. Общий балл одинаковый, но на конкретной задаче они могут помочь по-разному. Чтобы сравнить кандидатов, нужно посмотреть на их взаимные победы. На задачах, где справился только один, кто выигрывает чаще? Достаточно ли убедителен перевес? Примерно это проверяет парный тест Макнемара, которым пользуются авторы. Ни одна из 29 соседних пар в первой тридцатке не показала статистически значимого различия. Это ещё не делает всю тридцатку одинаковой: между некоторыми далёкими друг от друга участниками различия обнаруживаются. Но порядковые номера создают слишком уверенную картину, которая не особо обоснована. Дальше важна обвязка агента: как он ищет контекст, вызывает инструменты, проверяет себя и повторяет попытки. У одной модели в разных обвязках наблюдался разброс до 29,8 процентного пункта. Но команды, версии и условия запусков различались. Это аргумент проверять всю связку, а обещать такой прирост от замены обвязки было бы перебором. И заголовок про «агенты сошлись» я бы читал осторожно. В работе — результаты 2023–2025 годов, по одному запуску на опубликованный результат и одно семейство бенчмарков. Для соседей по рейтингу не хватило доказательств превосходства. Равенство способностей от этого доказанным не стало. С авторами есть о чём поспорить. Они считают взаимодополняемость небольшой: два лидера вместе покрывают 414 задач вместо 396. Но дополнительные 18 — это примерно 17% провалов первого! Для дорогих задач вполне интересно. Правда, надо уметь выбрать правильный патч и сравнить второй агент с ещё одной попыткой первого. Само объединение ответов этого не решает. Как тогда выбирать? Я бы использовал такую процедуру, которая не описана в самой статье, но выглядит практично - Взять 2–3 кандидата, подходящих по доступам, интеграциям и бюджету. Зафиксировать модели, версии обвязки, лимиты времени и попыток. - Дать им одинаковые реальные задачи: баги, изменения API, тесты, работу с незнакомым кодом. Начать с нескольких десятков для пилота. Такой объём поможет увидеть крупные различия, но не обещает доказать преимущество в пару процентов. - Проверять патчи собственными тестами и ревью. Повторить хотя бы часть запусков: одна удачная попытка ещё не означает надёжность. - Считать стоимость принятого решения: вызовы модели, время ожидания, минуты человека на проверку и переделки. Отдельно учитывать регрессии. Смотреть по типам задач — среднее может спрятать полезную специализацию. Если преимущество по качеству пока неясно, можно выбрать более дешёвого и удобного кандидата, сохранив неопределённость в оценке. А второму дать отдельную роль: проверить, сколько провалов первого он исправляет за сопоставимый бюджет. Это уже проверяемое основание держать двух агентов в работе. #AI4SDLC #Agents #Research #Evals #Engineering
-
Как руководить тем, в чём пока не разбираешься | Леонид Черный | Code of Leadership S2E23 (Рубрика #Management) 29 сентября во вторник в 10 утра по МСК в прямом эфире поговорим с Леонидом Черным, автором канала Irregular CDO (@irregular_cdo), о ситуации, в которой должность уже новая, ответственность уже твоя, а в предмете команда разбирается лучше тебя. У Леонида за плечами тестирование и продюсирование игр в Nival, запуск Яндекса в Турции, Rambler, работа с данными в «МегаФоне» и Uzum, операционное управление в oneFactor. Интересно пройти этот путь и понять, что помогало ему при каждой смене области, а чему приходилось учиться заново. Обсудим: - Как быстро стать полезным команде, когда сам ещё разбираешься, что здесь вообще происходит? - Какие решения оставлять экспертам и как добиться, чтобы они не ждали разрешения начальника? - Как управлять через языковой и культурный барьер — на примере запуска «Аллодов» в Японии и работы Яндекса в Турции? - Как учиться делегировать, спорить с начальством и вовремя просить помощи? - Что на практике означают два правила руководителя: «помогать» и «не мешать»? В плане есть и истории из его канала: переводчица, превращавшая отказы в обещания, премия сотруднику из собственного кармана и испытательный срок, пройденный с 23% выполненных целей. Попросим Леонида рассказать, как так получилось и что сегодня он сделал бы иначе. Приходите, если руководите людьми, меняете область или только присматриваетесь к управлению. И приносите свои вопросы — особенно те, которые неловко задавать, когда ты уже начальник. #Management #Leadership #Engineering #Software #Product #Processes #Data
-
Прямой эфир с Фёдором Сухаревым стартует, подключайтесь и задавайте вопросы.
-
Материалы выпуска #30: Developer Productivity for Humans (Рубрика #Management) Собрал материалы сольного выпуска Research Insights Made Simple от 21 сентября 2026 года. Разобрал серию исследований Google о продуктивности разработки и связал её с практикой управления командами. Инженер нашёл готовую библиотеку и сэкономил неделю работы. Кода написал мало. Как сделать так, чтобы система измерений заметила пользу такого решения? И куда смотреть, когда с AI кода стало больше, а проверять его приходится всё тем же людям? В выпуске разобрал: - Цели и метрики. Как связать логи, опросы и интервью с конкретным решением, которое мы готовы поменять по результатам измерений. - Скорость сборки и адаптацию новичков. Почему важны предсказуемость ожидания, самостоятельность инженера и время наставника. - Качество и командную работу. Как ускорение платформенной команды может обернуться дополнительной работой для потребителей её библиотек. - Противоречия AI. Перенос нагрузки на проверяющего, технический долг, путь от прототипа до эксплуатации и потерю понимания готового решения. В конце предложил план на месяц: выбрать одну болезненную цель, собрать исходные наблюдения, попробовать изменение и обсудить результат с командой. С готовностью остановиться, если идея не помогает. Материалы выпуска: 📌 Страница выпуска с таймкодами 📊 Слайды, Лонгрид 🎬 YouTube, VK Видео 🎧 Podster, Яндекс Музыка, Apple Podcasts 📝 Текстовый конспект А какая полезная работа в вашей команде остаётся невидимой для метрик? Приносите примеры в комментарии. #Management #Engineering #Metrics #DevEx #AI #Research
-
Mixedbread: как устроить агенту работу со знаниями (Рубрика #AI) Найти в договоре «30 дней» несложно. Понять, что это за срок, к кому он относится и какие условия его меняют, — уже отдельная работа. В докладе Бенжамена Клавье из Mixedbread этот пример хорошо объясняет, почему успешный поиск по коду ещё не означает, что агент готов исследовать произвольный архив документов. Его тезис: агентов для работы со знаниями стоит проектировать с учётом того, как устроена сама исследовательская работа. В коде есть имена функций, пути и явные связи. А ещё разработчик часто заранее превращает проблему в конкретный тикет. В юридическом или аналитическом исследовании агенту приходится самому выяснять, какие вопросы вообще нужно задать. Клавье предлагает посмотреть на юридическую фирму. Партнёр разбирается в ситуации клиента, выделяет направления исследования и поручает поиск помощникам. Те возвращают короткие записки, на основании которых он собирает решение и запрашивает уточнения. Для агентов получается похожая схема: постановка задачи → поиск по отдельным вопросам → записки с результатами → общий ответ. И здесь сходятся две темы доклада. Хороший инструмент делает поиск доступнее по времени и стоимости. Разделение работы помогает использовать найденное, не сваливая весь архив в контекст одного агента. По мысли Клавье, инструменты и организация работы должны развиваться вместе. Кстати, у этого рассуждения есть вполне конкретная продуктовая сторона. Mixedbread строит инфраструктуру поиска для агентов, включая обработку PDF, изображений, аудио и видео. Компания разрабатывает собственную модель Wholembed v3 и поисковый движок Silo. В их техническом разборе интересна деталь: содержимое представляется несколькими векторами, которые сохраняют информацию о его отдельных частях. Такой подход, late interaction, должен лучше различать близкие по теме документы с разными существенными деталями. Страницы PDF индексируются как изображения, чтобы сохранить таблицы и вёрстку; параллельно извлекается текст для чтения. За точность приходится платить хранением и вычислениями — отсюда и собственный движок. А Toast 1 — уже специализированный поисковый агент. Он разбивает вопрос на подзапросы, ищет, читает источники и собирает контекст для основной модели. Получается тот самый помощник из юридической фирмы, только с API. У компании есть показательный тест на Harvey LAB. На выборке из 33 задач один и тот же агент с GPT-5.6 Sol потратил 80,6 млн токенов с файловым поиском, 47 млн с Mixedbread Search и 23 млн с Toast 1 поверх этого поиска. Оценка качества ответов во всех трёх вариантах осталась одинаковой. Это собственное измерение Mixedbread на небольшой выборке, но оно хорошо иллюстрирует экономику разделения труда: сопоставимый результат примерно в 3,5 раза меньшим числом токенов. Эти цифры — из материалов компании, отдельно от доклада. С жёстким разделением программирования и остальной интеллектуальной работы я бы поспорил. В разработке тоже хватает задач, где сначала нужно выяснить, что мы вообще строим. Здесь существенна степень неопределённости постановки. А вот к исследовательским запискам стоит присмотреться. Я бы требовал от такого помощника конкретные источники, условия применимости вывода и список оставшихся противоречий. Иначе основному агенту придётся доверять чужому пересказу — вполне знакомая проблема при делегировании работы людям. #AI #Agents #Architecture #Engineering #Evals
-
edited Код, автомобиль, страховой продукт: чему заново учится CTO | Фёдор Сухарев | Code of Leadership S2E21 (Рубрика #Management) 23 сентября в 13:00 мск в прямом эфире поговорим с Фёдором Сухаревым и обсудим, а что из опыта технического руководителя можно забрать с собой в новую отрасль? А что придётся пересмотреть, когда после торговой платформы берёшься за автомобиль, а затем за страховой продукт? Федор расскажет про свой путь от первых задач в CBOSS и работы в Orange — к OTC.ru, Arrival и QIC digital hub. Меня здесь особенно интересует, как меняется само понимание «продукт готов», допустимой ошибки и ответственности за результат. - В Arrival разберём путь одной функции от требований и кода до работы их в автомобиле. Где возникают зависимости между софтом, электроникой и физическим устройством? Что делать, если каждая команда закончила свою часть, а целиком всё ещё не работает? И как руководить, когда планы и ресурсы компании меняются? - В QIC поговорим о цифровых страховых продуктах: зачем им общая платформа, как развивать её рядом со старыми системами и договариваться о приоритетах между командами. Попробуем на конкретном изменении понять, что ускоряет выпуск — архитектура, организация работы или их сочетание. - Отдельно обсудим AI в разработке: что уже можно поручить агентам, что проверяет инженер и как оценивать пользу с учётом переделок. - И вернёмся к карьере: как заслужить доверие команды в незнакомой отрасли и какие вопросы задать себе и компании перед следующим переходом. Приходите, если руководите разработкой, растёте в эту роль или присматриваетесь к другой отрасли. Приносите вопросы — обсудим их в прямом эфире. #Management #Leadership #Engineering #AI #Software #Processes
-
Прямой эфир про AI4SDLC и мои lessons learned начинается, подключайтесь и задавайте вопросы
-
Modern Computer Architecture and Organization — от процессора до AI-дата-центра (Рубрика #Books) У меня на столе лежит первое издание Modern Computer Architecture and Organization Джима Ледина — решил с его помощью освежить знания про архитектуру компьютера. А тут выяснилось, что уже вышло третье, с отдельными главами про GPU и LLM. В GOTO Book Club есть разговор с автором, который хорошо объясняет, как AI-бум добрался до этой книги. Сама книга — последовательный проход по устройству компьютера снизу вверх. Сначала транзисторы, цифровая логика и элементы процессора, дальше память, ввод-вывод и аппаратно-программный интерфейс. Затем кэши, конвейер, параллельное выполнение, x86/x64, ARM и RISC-V. Есть и выход на уровень систем: виртуализация, специализированные вычисления, устройство смартфонов, ПК и облачных серверов. Первое издание вышло в 2020 году. Для разработчика здесь полезна сама связность: от того, какие команды умеет процессор, до того, как он получает данные и исполняет программу. Можно восстановить картину под привычными абстракциями и разобраться, почему производительность зависит от гораздо большего числа вещей, чем частота CPU. Для повторения базы такая последовательность удобна. Когда я искал отзывы на книгу, то заметил, что уже вышло третье издание вышло 31 марта 2026 года. И хотя уже в первом были GPU, нейросети и вычисления масштаба дата-центра, то в третьем GPU и вычислительные архитектуры LLM получили собственные главы. В интервью Ледин объясняет, как писал про область, которая меняется быстрее издательского цикла: выделял устойчивые принципы — параллелизм, пропускную способность памяти, тензорные операции и связи между вычислительными узлами. Для разбора LLM он выбрал GPT-2. По словам автора, открытый код и сравнительно небольшой размер помогают проследить устройство трансформера: какие матрицы перемножаются, как устроены слои и что происходит с данными. Такой учебный пример можно разобрать и покрутить самому. Ледин считает, что понимание GPT-2 даёт хорошую основу для знакомства с более крупными моделями. Это разумный способ учить архитектуре: сначала разобраться с механизмом, потом наращивать сложность. Дальше разговор доходит до того, как эта конструкция вырастает из одного чипа в сервер, стойку и целый дата-центр. Ледин выделяет memory bandwidth как одно из ключевых ограничений: вычислительные блоки могут ждать, пока данные прочитаются из памяти или запишутся обратно. На большом масштабе к этому добавляются обмен между устройствами, питание и охлаждение. Автор предлагает смотреть на весь дата-центр как на один большой компьютер — с собственной архитектурой и ограничениями. Кстати, в конце интервью его спрашивают, какую одну главу посоветовать разработчику без аппаратного бэкграунда. Ледин выбирает главу про повышение производительности: конвейер и иерархию кэшей. На разных стадиях конвейера одновременно обрабатываются разные инструкции, а кэши позволяют держать нужные данные ближе к ядру. По мысли автора, понимание этих механизмов помогает организовать код и данные так, чтобы железо меньше простаивало. До AI добрались, а повторять всё равно приходится базу :) Для повторения процессоров, памяти и исполнения программ уже имеющееся первое издание остаётся полезным. Если хочется продолжить этот маршрут до устройства GPU и систем для LLM, стоит присмотреться к третьему. А интервью — хороший способ понять замысел обновления перед тем, как браться за новые главы. #Books #Engineering #Architecture #Hardware #AI #SoftwareDesign
-
Прямой эфир про Developer Productivity начинается, подключайтесь и задавайте вопросы
-
Research Insights Made Simple #30: Developer Productivity for Humans (Рубрика #Management) 21 сентября в 17:00 МСК в сольном выпуске соберу серию исследований Google и мои разборы о продуктивности разработки в одну картину. Представим, что сборки ускорили, AI пишет больше кода, а графики активности растут. Как понять, что команде стало легче доводить работу до полезного результата? И не переехала ли сэкономленная работа к тому, кто теперь всё это проверяет? В этой серии мне интересна связка технических условий с человеческим опытом: скорость, удобство работы и качество результата рассматриваются вместе. На выпуске разберу: - Как выбирать метрики под конкретную инженерную цель и сопоставлять логи с опросами разработчиков; - Что ожидание сборок, переключения и адаптация новичков говорят об условиях работы; - Как учитывать качество, технический долг и вклад коллег, который плохо виден в количестве нового кода; - Что AI меняет в распределении работы: генерация, проверка, понимание решения и обучение. В конце предложу план первого месяца для вашей команды: выбрать одну цель, разобраться с исходной ситуацией, попробовать одно изменение и проверить его последствия. С понятным вопросом, на который мы хотим получить ответ. Приходите, если отвечаете за разработку, строите внутренние платформы или пытаетесь понять, помогают ли команде новые инструменты. В комментарии можно принести свои примеры: что вы измеряете и на какой вопрос эти цифры пока не отвечают. #Management #Engineering #Metrics #DevEx #AI #Research
-
Y Combinator: железо, агенты и основатели (Рубрика #AI) В свежем выпуске The Lightcone «The State of Startups in 2026» команда YC связывает несколько изменений одной идеей: AI позволяет маленьким командам браться за более сложные задачи. В этой картине меня интересуют две вещи: откуда берётся экономика новых производств и зачем каждому софтверному продукту заводить собственного агента. Со вторым тезисом я бы поспорил. По данным, которые ведущие приводят в выпуске от 17 сентября 2026 года: - Доля hard tech среди принятых в YC компаний выросла с 8% до 20%; - Робототехники — примерно с 1% до 6–7%; - Компаний с одним основателем — примерно с 5% до 18–19%. Это статистика отбора YC. На неё влияют и предложения основателей, и предпочтения инвесторов; переносить проценты на весь рынок я бы не стал. 1️⃣ Железо и спрос на производство Под hard tech здесь понимают роботов, чипы, энергетику, космос и оборонные системы. Аргумент YC: генерация кода позволяет меньшей команде справляться с программной частью сложного физического продукта. Звучит разумно, хотя расчёта экономии на всём цикле разработки в выпуске нет. Ребята еще приводят в пример Nox Metals, который интересен другим. По словам ведущих, новые оборонные стартапы в США нуждаются в металле, а существующие поставщики не успевают за их темпом. Nox развивает автоматизированную обработку и поставку металла. Здесь локальное производство создаёт рынок для следующего звена цепочки. Автоматизация помогает обслужить этот спрос. Объяснять весь рост удешевлением разработки благодаря AI было бы слишком смело. 2️⃣ Свой харнесс в каждом продукте Дальше YC предлагает системам, где хранятся рабочие данные, становиться средой исполнения задач агентов — харнессом. Иначе работу с их данными организует внешний агент, к которому может перейти и взаимодействие с пользователем. В пример они приводят успехи Salesforce и их обвязку для Slack. Вот в массовый успех такого подхода я не верю. Разработка собственного харнесса может съесть много денег, а пользователь продолжит работать в привычном Claude или Codex. Через MCP и API внешний агент потенциально охватит больше систем: одна задача легко проходит через CRM, почту, документы и финансы. Я бы скорее вкладывался в понятные агенту действия продукта: проверить условия договора, согласовать скидку, оформить заказ. С правами доступа, проверками и возможностью разобраться в ошибке. Собственному агенту ещё придётся доказать, что внутри продукта он даёт заметно лучший результат. 3️⃣ Опытные основатели снова в центре внимания Ведущие отдельно отмечают сильных основателей, которым под 40, за 40 и даже за 50. Их объяснение: AI помогает быстрее реализовывать идеи, а опыт подсказывает, что вообще стоит строить. Они также предполагают, что управление инженерами помогает ставить задачи агентам и оценивать их работу. Здесь я вижу правдоподобный механизм: знание отрасли и её проблем становится полезнее, когда можно быстрее проверить решение. Но в выпуске это наблюдения и примеры; статистики успешности по возрастам там нет. 4️⃣ Стартовать одному стало проще Рост с 5% до 18–19% относится к solo founders — основателям, которые приходят в YC без сооснователя. Численность сотрудников эта цифра не описывает. Сами ведущие ожидают, что многие успешные одиночки добавят сооснователей позже. По их логике, AI позволяет одному человеку закрыть больше задач на старте. Мне здесь интересна возможность сначала проверить идею и спрос, а уже затем собирать команду под понятную работу. Для человека с отраслевым опытом это вполне конкретное расширение возможностей: до первого эксперимента теперь потенциально меньше организационных препятствий. #AI #Robotics #Agents #Product #Management #Software #Engineering
-
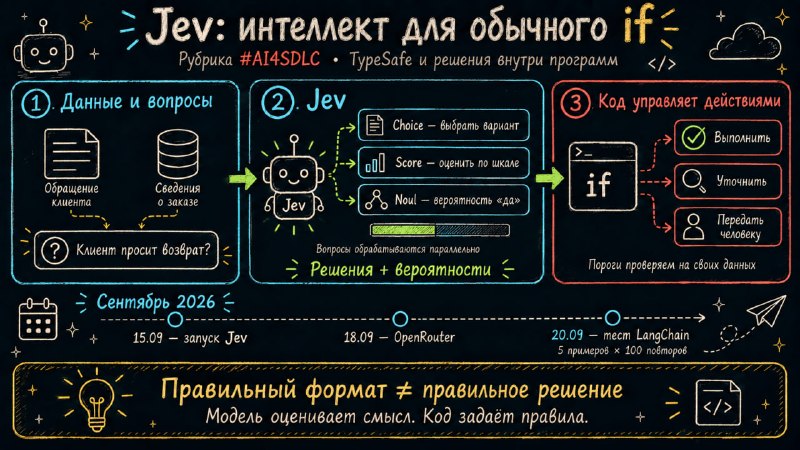
Jev: интеллект для обычного if (Рубрика #AI4SDLC) В предыдущем посте Диогу Алмейда предлагал учить AI принимать решения, которые можно встроить в обычную программу. У этой идеи уже появилось вполне осязаемое продолжение: модель Jev от его компании TypeSafe. Любопытно здесь то, сколько возможностей разработчики согласились отдать ради одного полезного свойства — быстро отвечать на маленькие вопросы. 15 сентября 2026 года TypeSafe открыла ранний доступ к Jev и объявила о раунде на $40 млн под руководством DCVC. Модель вообще не пишет свободный текст. Ей передают состояние — например, обращение клиента и сведения о заказе — и набор вопросов с заранее заданной формой ответа: - Choice выбирает вариант из списка: в какую очередь отправить обращение; - Score оценивает по описанной шкале: насколько срочно нужна помощь; - Noul возвращает вероятность ответа «да»: просит ли клиент вернуть деньги. Вопросы обрабатываются параллельно; Choice и Score тоже возвращают вероятности возможных ответов. Дальше обычный код решает, что делать: направить заявку нужной команде, запросить недостающие данные, передать человеку. Модель можно поставить внутрь знакомого if, а правила перехода между шагами оставить в программе. Именно из таких деталей и собирается автоматизация. Метод обучения TypeSafe назвала RLCD — Reinforcement Learning for Calibrated Decisions. Его заявленная цель — согласовать вероятности с реальной частотой событий. Если модель много раз говорит «вероятность 80%», примерно в 80% этих случаев событие должно происходить. Тогда можно подобрать порог для автоматического действия, а сомнительные случаи отправлять на разбор. Разумеется, такую калибровку еще нужно проверить на своих данных. За отказ от генерации обещают щедро заплатить скоростью. В собственных тестах рабочих процессов TypeSafe получила ускорение до 193,6 раза и снижение стоимости до 444,6 раза относительно сравниваемых LLM. Сама компания считает такой выигрыш оптимистичным ориентиром для реальных задач. Есть и методическая тонкость: эталоном служило усреднение ответов сильных моделей, так что тест измерял согласие с ними, а не независимо установленную правильность. Появились и внешние эксперименты. 20 сентября LangChain опубликовала проверку, в которой Jev оценивал пять ответов погодного агента, каждый по 100 раз. Все 500 бинарных оценок совпали с разметкой человека, средний вызов занимал 0,44 секунды. Звучит бодро, но пять разных примеров остаются пятью: повторы хорошо показывают устойчивость, а широту возможностей придется проверять отдельно. Самая скользкая фраза в анонсе — «не может галлюцинировать». Здесь гарантируется форма ответа: Jev не придумает шестую категорию, если разработчик разрешил пять. Ошибочно выбрать одну из пяти он вполне может. И документация довольно прямо перечисляет проблемы: арифметика, сравнение дат, длинные цепочки рассуждений, лишний контекст. Содержащиеся в данных вредоносные инструкции тоже могут влиять на решение. Поэтому интересный эксперимент с Jev — выделить небольшой участок существующего процесса, где постоянно нужен смысловой выбор. Например, проверять, подтверждает ли источник вывод агента, или выбирать маршрут обработки заявки. Посчитать ошибки, подобрать порог, оставить возможность передать задачу человеку. Если такая деталь работает дешево и предсказуемо, ее можно вызывать на каждом шаге — и вокруг нее уже строить более сложную систему. Попробовать можно через OpenRouter: модель typesafe/jev-1.13, на 20 сентября — $0,042 за миллион входных токенов, выход бесплатный. Хороший повод взять одну повторяющуюся развилку в своем коде и проверить, как изменятся задержка и число ошибок. #AI4SDLC #AI #Architecture #Evals #Engineering
-
Диогу Алмейда: AI, за которым можно не присматривать (Рубрика #AI4SDLC) Почему AI впечатляет решением сложных задач, а обычный возврат денег клиенту всё ещё страшно поручить ему без проверки? В 18-минутном июльском выступлении на AI Engineer Диогу Алмейда предлагает искать ответ в цели обучения. По его мнению, индустрия научилась делать отличных помощников, а надёжная автоматизация требует другого набора свойств. Алмейда — один из основных авторов InstructGPT, работы 2022 года, которая помогла превратить языковую модель в исполнителя инструкций. Теперь он разбирает ограничения этого подхода. Получается интересная исследовательская петля: сначала научить AI работать с человеком, затем понять, что мешает убрать постоянный присмотр. RLHF учит модель получать хорошие человеческие оценки. В классической схеме люди сравнивают ответы, на этих предпочтениях обучают модель вознаграждения, а затем оптимизируют поведение языковой модели под её оценки. Правильность может входить в критерии, но сама оценка остаётся приближением к тому, чего мы хотим от системы. Представим ответ службы поддержки. Он вежливый, подробный, выглядит убедительно. А возврат оформлен по неверному правилу. Если результат проверяет человек, он ещё может заметить ошибку. Если ответ стал условием в программе, дальше уже поехали деньги. Здесь качество формулировки и качество решения приходится измерять отдельно. Отсюда провокация Алмейды: ChatGPT и Claude Code принадлежат одной эпохе — эпохе ассистентов. По его логике, агент может выполнять всё больше действий, но это ещё не означает, что ему можно доверить процесс целиком. В идеале автоматизация должна стать настолько обыденной, что о ней вспоминают примерно как о фоновом задании на сервере. У этой критики есть предметная опора. В отчёте GPT-4 показано, что после постобучения модель хуже оценивала вероятность правильности своих ответов на подмножестве MMLU. При этом результаты на TruthfulQA улучшились. То есть можно чаще отвечать правильно, но хуже соотносить уверенность с реальной точностью. Два разных свойства, которые легко склеить в одно слово «качество». Для автоматизации Алмейда предлагает отдельную цель — калиброванные решения. Если система выдаёт вероятность 90%, то на большой группе таких прогнозов доля верных должна быть около 90%. Тогда можно настраивать границы: где программа действует сама, где запрашивает дополнительные данные, где передаёт случай человеку. Эти границы всё равно придётся проверять на своих задачах, так как ваше распределение решений может отличаться. Сильная часть аргумента — требование сделать неопределённость пригодной для программирования. А вот необходимость человека при каждом запуске из RLHF автоматически не следует. Человек участвует в обучении; сколько проверки потребуется при эксплуатации, зависит от реальных ошибок и цены их последствий. Поэтому объяснять все проблемы автоматизации одним методом обучения было бы слишком удобно. Ещё у Алмейды есть хороший поворот про программное обеспечение. AI уже помогает быстрее писать код, а он хочет изменить сами возможности готовой программы: добавить в неё смысловые суждения, которые можно проверять и соединять с обычной логикой. Условие «клиент действительно просит возврат» гораздо труднее выразить кодом, чем проверку суммы или даты. На момент выступления его TypeSafe ещё готовилась к релизу, который состоялся 15 сентября. Собственно, у этой идеи появился API и модель Jev, про которую мы поговорим в следующем посте. #AI #AI4SDLC #Engineering #Automation #Research
-
Материалы 3 AImigo S1E6: как не утонуть в потоке AI-изменений и сохранить силы (Рубрика #AI) Готовы материалы шестого выпуска 3 AImigo, который вышел 18 сентября 2026 года. Вместе с Евгением Сергеевым и Алексеем Литвиновым обсудили, как оставаться в контексте AI, когда на чтение всех новостей, проверку новых моделей и собственно жизнь претендуют одни и те же часы. Агенты умеют собрать подборку, составить учебный план и напомнить о занятии. А вот сил на его прохождение у человека от этого автоматически не прибавляется. На этом разрыве и сошлись три довольно разных подхода к обучению и работе с информацией. Обсудили - Как выбирать, за чем следить. Евгений начинает с личных целей и планирования недели. Я использую технологический радар: читать сейчас, наблюдать или перестать отслеживать. И прошу подбирать материалы, которые расширяют картину мира, а не только подтверждают то, что уже думаю. - Когда подборку полезнее отключить. Алексей перестал читать автоматическую ленту и отказался от неё. Темы для изучения ему дают задачи компаний, профессиональное окружение и собственные эксперименты. Это его способ отбора; общего рецепта для всех здесь нет. - Где заканчивается помощь агента-тьютора. На моём примере разобрали программу от инфраструктуры дата-центров до моделей и платформ. Подготовить теорию и упражнения можно быстро, а дальше приходится задавать вопросы, пробовать руками и подстраивать нагрузку под свои силы. - Зачем оставлять время без входящей информации. Схема от руки, заметка своими словами, подготовка выступления — способы переработать материал. В опыте ведущих прогулка или бег без подкаста тоже помогают освободить голову. Не каждую свободную минуту обязательно заполнять ещё одной лекцией :) - Как отличать прогресс от занятости. Евгений ведёт вечерний дневник: приблизил ли день к выбранной цели? При этом он признаёт, что агенты позволяют запустить больше параллельных процессов, чем хватает сил сопровождать. Уметь запускать ещё одну задачу и иметь на неё внимание — разные вещи. В выпуске сравнили личные практики и их ограничения. Страх отстать не исчезает по команде, но понятное направление помогает решать, чему учиться сейчас и что спокойно пропустить. Материалы выпуска: - Страница выпуска с содержанием и таймкодами - Видео: YouTube, VK Видео - Аудио: Podster, Яндекс Музыка, Apple Podcasts - Текст: конспект разговора Как вы выбираете, что изучать, а что пропускать? И как понимаете, что действительно чему-то научились, а не просто разгребли очередную подборку? #AI #AI4SDLC #Agents #Education #Engineering #Podcast
- Older posts