И Google тоже! Выпустил Gemini 3.8 Flash – третий Flash за шесть недель
3.7 Flash вышел три недели назад. Просто чуть пропатчили и видимо баги пофиксили.
Цена та же: $0.75 за 1M входных и $3.75 за 1M выходных токенов. Модель в 6–7 раз дешевле Opus, немного обгоняет его в финансовых, юридических задачах, графиках, видео, длинных задачах. Общие агентные способности, офисные задачи, понимание PDF пока уровня простенькой быстрой модели. Чуть хуже по безопасности, особенно на неанглийском языке. И стало больше токенов жрать. База знаний – март 2026, контекст 1M, выход 64K.
Короче, противоречивенько. Но если попадает в ваши задачи - стоит переключиться. Тестируйте на своих данных, как обычно.
https://deepmind.google/models/model-cards/gemini-3-8-flash/
edited
Ну что ж, теперь можно проверить, создавался ли файл (графика, видео) c помощью Anthropic. Можно проверять коллег. Текстовых форматов пока нет, типа только доверенным партнерам дали.
https://claude.com/check-content
edited
Ну что ж, с 1 сентября
Anthropic выпустила Claude Fable 5.1 и Mythos 5.1
Fable 5.1 – новая старшая модель, доступна всем. Mythos 5.1 – та же самая модель, но с ослабленными фильтрами по кибербезу и биологии, только для проверенных организаций (пока – американских).
Что интересного:
– Terminal-Bench 4.0: 55,8% (Mythos – 60,9%) против 42% у Fable 5 и 52,3% у Opus 5. GPT-5.6 Sol – 37,3%. Разрыв между Fable и Mythos – это ровно те задачи, где срабатывали старые cyber-фильтры
– Terminal-Bench-Science: 52,6% против 24,7% у предыдущей версии. Удвоение за релиз – давно такого не видел
– Humanity's Last Exam – 60,9% без инструментов, 65% с ними
– OSWorld 2.0 – 77,9%, но в строгом режиме всё ещё 41,7%. Компьютер агентам по-прежнему даётся тяжело
– Цена: $10/$50 за миллион токенов – как у Fable 5. Но cache reads подешевели на 75% – до $0,25 за миллион. Anthropic говорит про ~25% экономии на типичных задачах и до ~45% на агентных, где кэш – основная статья расходов. Для тех, кто держал Opus из-за цены, Cognition уже переезжает на Fable на первом дне
– На Low/Medium effort 5.1 даёт результат уровня Fable 5 заметно дешевле. По умолчанию в Claude Code – High, в Cowork и claude.ai – Medium
Из безопасности главное для бизнеса – Enterprise Frontier Safeguards: данные лежат в облаке клиента, а не у Anthropic, ревью делает сам клиент. Фактически zero data retention, но с работающими фильтрами. Раскатывают осенью поэтапно, до этого eligible-клиентам дают обычный ZDR. Для наших финтех-заказчиков это ровно тот аргумент, которого не хватало на встречах с безопасниками. Но скорее всего будет только в энтерпрайз подписке задорого.
Ещё два момента: кибер-фильтры срабатывают на 60% реже, и модель теперь можно использовать для поиска уязвимостей (но не для написания эксплойтов – это по-прежнему уводят в Opus). И тихо закрыли лазейку для дистилляции: новые API-аккаунты больше не могут редактировать прошлый контекст, сохраняя thinking модели.
Из науки – белковые биндеры с hit rate под 50% при обычных 10–15%, карта Венеры по данным Magellan 30-летней давности и ускорение биоинформатических моделей до 2,5× за счёт кастомных GPU-ядер. Красиво.
Из-за EU AI Act во все модели после 2 августа зашит текстовый водяной знак. Пользователю его не видно, детектор дают пока только регуляторам и медиа. Скоро проверим, как это будет жить на практике. И кто пишет нейрослоп :)
Короче, если основная модель – Opus, надо пересчитывать: Fable 5.1 на Medium может оказаться и лучше, и дешевле.
Картинки их уродскую с бенчмарками постить не буду, просто все лучше всех у них.
https://www.anthropic.com/claude-fable-and-mythos-5-1
edited
Промпты старые можно выкинуть на помойку
Вспоминаю разные хаки, "особые слова" и структуры промптов, чтобы модели нормально работали, особенно в автоматическом режиме, много где эти промпты уже забиты в коде. В итоге с текущими моделями все эти советы делают только хуже! Вот что Anthropic пишет в новой статье:
Раньше модели были глупее, и их приходилось обкладывать жёсткими правилами со всех сторон – «никогда не делай так», «всегда делай эдак». Правила спасали от худших сценариев, но в куче ситуаций были просто неверными. Новые модели достаточно умные, чтобы самим понять по контексту, что от них хотят.
Что конкретно поменялось:
– Вместо жёстких запретов – здравый смысл. Было: «НИКОГДА не пиши длинные комментарии к коду». Стало: «пиши в том же стиле, что и остальной код в проекте». Модель сама смотрит и подстраивается
– Примеры больше не помогают, а мешают. Раньше считалось: покажи модели 2–3 примера, как пользоваться инструментом – и она поймёт. Теперь примеры наоборот сужают мышление: модель копирует показанное вместо того, чтобы найти лучший вариант. Лучше использовать богатые файлы-референсы.
– Не грузить всё сразу. Раньше все инструкции запихивали в один огромный документ «на всякий случай». Теперь их раскладывают по отдельным файлам, и модель подтягивает нужный, только когда он реально понадобился. Соответственно лучше просить сохранить/обновить память/файлы с описаниями после сессии работы.
– Не повторяться. Старым моделям одно и то же писали по три раза в разных местах, иначе забывали. Новым достаточно сказать один раз
В Claude Code даже добавили команду /doctor – она сама вычищает ваши раздутые инструкции под новые модели.
Мой вывод из этого очень практический: почти всё, что мы понаписали в промптах за последний год, устарело! Немедленно посмотрите на промпты в своих системах и проекта и поменяйте на более современные стандарты (с проверками конечно же). Я регулярно вижу простыни инструкций, где половина правил противоречит другой половине – и модель тратит силы на распутывание этого клубка, а не на задачу. Новый рефлекс должен быть не «что бы ещё дописать», а «что можно выкинуть».
https://claude.com/blog/the-new-rules-of-context-engineering-for-claude-5-generation-models
repost
Gemini Omni 1.1 Flash
Google сегодня, 27 августа, бахнула Gemini Omni 1.1 Flash.
Это уже не preview, а production-версия видеомодели gemini-omni-1.1-flash в Gemini API.
Главное обновление: теперь можно продлевать видео кусками по 10 секунд до суммарных 40 секунд, причём модель учитывает до 10 секунд предыдущего видео вместо примерно последней секунды
Также можно задавать первый и последний кадр для интерполяции, делать быстрые 360p-превью до 60% быстрее и примерно втрое дешевле 720p, а финал апскейлить до 1080p или 4K.
Старый gemini-omni-flash-preview отключат 30 сентября. Цена 720p остаётся примерно $0.10 за секунду видео.
Где пробовать:
Google Flow - самый простой способ попробовать без кода. Сегодня туда уже выкатили возможности Omni 1.1 Flash: start/end frames, 360p drafts и экспорт 1080p/4K.
https://blog.google/innovation-and-ai/models-and-research/google-labs/new-creative-controls-google-flow/
Google AI Studio - лучший вариант именно для тестирования модели и API. В документации модель называется gemini-omni-1.1-flash; можно тестировать генерацию/редактирование и затем сразу забрать код. blog.google
Открыть Google AI Studio
Gemini app - Omni также доступен подписчикам Google AI Plus/Pro/Ultra, но там пока непонятно, какая модель
https://blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-omni-1-1-flash/
https://ai.google.dev/gemini-api/docs/omni
@cgevent
Кажется Илья Суцкевер скоро что-то представит
Safe Superintelligence – единственная лаборатория с оценкой $32 млрд, у которой за два года нет ни продукта, ни статьи, ни демо. Сайт – один абзац и ссылка на вакансии. Ну тут прям куча каких-то утечек, намеков и восхищений.
Сначала контекст, чтобы понимать масштаб ставки:
– Июнь 2024 – Суцкевер уходит из OpenAI и через месяц основывает SSI с Дэниелом Гроссом и Дэниелом Леви. Манифест: никаких промежуточных продуктов, только straight shot к сверхинтеллекту.
– Сентябрь 2024 – $1 млрд при оценке $5 млрд (a16z, Sequoia, DST). Апрель 2025 – ещё $2 млрд при $32 млрд, заходят Google и NVIDIA. Рост x6 меньше чем за год – на одной вере в Илью.
– Лето 2025 – Meta пытается купить SSI целиком, получает отказ, забирает себе CEO Гросса. Суцкевер становится CEO сам.
– Ноябрь 2025 – большое интервью Дваркешу: «эпоха масштабирования закончилась, возвращается эпоха исследований». Ещё x100 компьюта, по его словам, улучшит модели, но не изменит их природу. Чего именно не хватает – не сказал, «мы над этим работаем».
– 27 июля 2026 – NVIDIA объявляет партнёрство: доступ к Vera Rubin, рост компьюта на порядок за год, плюс инвестиция (в прессе – $5 млрд). Формулировка в релизе: вошли «после редкого доступа к закрытым исследованиям».
Дальше – август и слухи. Инвестор Гэвин Бейкер в подкасте говорит, что SSI выпускает первую модель в этом месяце, причём слово «модель», а не «LLM» – в X это отдельно подметили. Мартин Касадо из a16z пишет про «самый значимый релиз года», не называя компанию. Обозреватели подхватывают: кто-то про «прорыв в continual learning из небольшой лаборатории», кто-то уже про «сверхинтеллект создан». Сама SSI молчит.
Ключевой слух – архитектура Test-Time Training. В декабре 2025 вышла статья Stanford «End-to-End Test-Time Training for Long Context» – модель не держит длинный документ в контекстном окне, а дообучается на нём прямо во время инференса, сжимая прочитанное в собственные веса. На 3B-модели это дало такое же качество на 128K контекста, как у полного attention, но почти в 3 раза быстрее. Среди авторов – люди из NVIDIA.
Если у SSI действительно рабочий continual learning в масштабе, это бьёт по трём вещам сразу: гонке за контекстные окна, RAG как костылю вместо памяти и самой идее, что побеждает тот, у кого больше GPU. Суцкевер описывал цель как «сверхумного 15-летнего подростка» – ничего не знает про вашу компанию, но выучивает работу за неделю и не забывает. Для тех, кто строит агентов и каждый новый чат заново кормит контекстом, это ровно та боль.
Короче, звучит невероятно, но пока загадывать сложно. Вариантов три: перенос релиза на осень (для лаборатории без истории релизов – норма), обычная фронтир-модель (при такой оценке – провал) или реальный шаг в continual learning – тогда это важнее, чем появление reasoning-моделей.
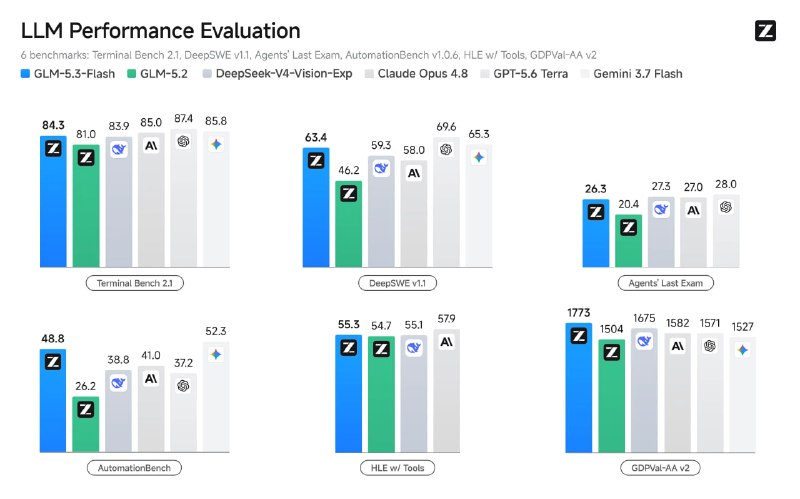
Z.ai выложила GLM-5.3-Flash – ту самую «загадочную» Ox Alpha
Все там писали кипятком, что же стоит за стелс-моделью Ox Alpha, которая бесплатно взлетела в топ по использованию. Сын же мой потестил и сказал, что что-то китайское и среднее по качеству, не понятно, отчего такие восторги (не слушайте блогеров).
Сегодня интрига закончилась – это Z.ai, и модель GLM-5.3-Flash, с открытыми весами под MIT, мультимодальная.
Короче, получилась такая:
– 320B параметров, из них активных всего 18B
– первая нативно мультимодальная модель в линейке GLM-5: картинки и видео на входе, 1M контекста
– гибридная архитектура sparse + linear attention – Z.ai говорит, что это первая открытая frontier-модель с такой связкой. Attention-вычислений в 3 раза меньше, KV-кэш в 4,4 раза компактнее, чем у большой GLM-5.3
– обучалась и крутится целиком на китайских чипах – без Nvidia
По цифрам заявляют паритет с Claude Opus 4.8 на кодинге и агентских бенчмарках и уверенное превосходство над GLM-5.2 – при цене в десять раз ниже. Отдельная фишка – «визуальный кодинг»: модель сама смотрит на отрендеренный интерфейс, находит косяки и правит, а ещё умеет доводить офисные задачи до готовых PPTX/XLSX/DOCX. Все остальное скорее всего будет так себе.
Цена, конечно, жесть:
– $0.15 за 1M входных, $0.50 за выходных, кэш $0.03 (официальный API)
– на OpenRouter сейчас вообще $0.075 / $0.25
– для сравнения, большая GLM-5.3 стоит $1.40 / $4.40, Opus – в разы дороже
Веса на Hugging Face, API уже живой, в Coding Plan дают тройную квоту.
Короче, скоро ИИ-ка будет вам кодить за чашку риса...
https://z.ai/blog/glm-5.3-flash
Чип OpenAI Халапеньо обогнал Nvidia.
Ждал каких-то обзоров первых и вот случились. SemiAnalysis съездили в лабораторию OpenAI и прогнали свой бенчмарк InferenceX на «Jalapeño» – инференс-чипе, который OpenAI делает с Broadcom. Сделали за 16 месяцев от найма людей до готового чипа.
Что получилось:
– по токенам на мегаватт обходит все чипы Nvidia, AMD и Google, которые SemiAnalysis успели протестировать
– на DeepSeek R1 – больше 700 токенов/сек на одного пользователя, на GPT-OSS – около 1 400
– всё это без спекулятивного декодирования (а это дает 3х+ по цене токена), а у конкурентов уже был включен.
– Сверхбыстрые HBM4, 15,4 ТБ/с, TDP 700 Вт против 900–1 150 у Rubin
– 128 чипов в стойке, до 2 048 в одном scale-up домене
Самое интересное – не железо, а как его довели до ума. Ядра Jalapeño пишут почти как ассемблер, на самом низком уровне, и большую часть этой работы делает внутренняя версия Codex. MLA-кернелов для DeepSeek у OpenAI вообще не было – Codex написал. Doom на чипе тоже портировали и запускали промптами. Философия простая: спроектировать железо с максимальным теоретическим потолком, а оптимальные компиляторы под каждую модель пусть пишет ИИ. Если это сработает – индустрия зря десять лет молилась на универсальные компиляторы.
Выйдет это все только в следующем году и основная масса - в конце года, но это в любом случае означает, что стоимость токена у OpenAI через год упадет в разы!
https://newsletter.semianalysis.com/p/openai-jalapeno-better-than-nvidia
edited
Ответочка от Apple: новые Mac Studio и Mac Mini!
На процах M6 и M5 Ultra
M6 – первый чип Apple на 2 нм, ставят в новый Mac mini:
– 12-ядерный CPU (2 «супер», 4 производительных, 6 эффективных) – на 20% быстрее M5 в многопотоке
– 12-ядерный GPU с Neural Accelerator в каждом ядре – +30% AI-вычислений против M5, обещают заметно быстрый prompt processing для локальных моделей
– двойной 16-ядерный Neural Engine – до 2x пиковой производительности, фреймворки сами раскидывают нагрузку на оба
– до 32 ГБ памяти, 170 ГБ/с
M5 Ultra – в новом Mac Studio, впервые четыре кристалла в одном SoC (два M5 Max, склеенных UltraFusion):
– до 36 ядер CPU, до 80 ядер GPU
– до 512 ГБ unified memory, 1.2 ТБ/с – на 50% больше, чем у M3 Ultra, то есть как у xiaomi процессоров, о которых вчера писал.
– 4.5x AI-вычислений на GPU против M3 Ultra, prompt processing в LM Studio – в 4 раза быстрее
Предзаказ уже можно сделать. Доставка с 22 сентября.
Mac mini от $900 за M6 Pro, 16Gb памяти, 512Gb диск. M6 + 1 Tb SSD + 32Gb памяти - $1800
M5 Pro 24 ГБ – $1,699. M5 Pro + 1Tb SSD + 64Gb памяти - $3000
Mac Studio:
– M5 Max начинается с $2,499 (36 ГБ памяти, 512 ГБ диск). Если нужно 128Гб памяти, то $5400 уже.
– M5 Ultra начинается с $5,499 (на $200 дороже M3 Ultra, 96 ГБ, 1 ТБ, в принципе, не сильно дороже DGX Spark, но скорость памяти бешеная). 256 ГБ минимум $9500
– 512 ГБ только в конце октября, цены нет – по прогрессии ждём около $15k
Получается, что Mac mini M6 с 32 ГБ за $1,299 – самый дешёвый нормальный билет в локальные LLM: 7–14B в квантизации с запасом под контекст, и Apple прямо говорит про «агентные задачи локально». Следующая разумная ступень – M5 Max Studio со 128 ГБ за $4,799: туда влезает 70B в Q4. А Ultra с 512 ГБ и 1.2 ТБ/с – единственный десктоп, куда влезает модель на несколько сотен миллиардов параметров без кластера. Ширина памяти здесь важнее ядер: именно она определяет токены в секунду. Даже за $15k это дешевле одной H100 с обвязкой, и без DevOps. Обидно другое: Apple теперь берёт за память как за GPU – $4,000 за +160 ГБ, год назад тот же апгрейд стоил $1,600.
Отдельно интересно, что маркетинг полностью развернулся: не «монтаж видео супер-быстро», а «запуск frontier-моделей на десктопе». Для команд, которым нельзя гонять документы, код, аудиозаписи в облаке, это самый простой способ получить приватный инференс.
https://nr.apple.com/Dj0T8P0dD8
Xiaomi снова делает топ за свои деньги для локального AI )
Показала AI Cube – мини-ПК для локальных LLM на трёх собственных чипах. Внутри нет ни Qualcomm, ни Intel, ни Nvidia:
– XRING O3 – основной SoC: 10 ядер CPU, 16-ядерный GPU, NPU на 200 TOPS, 3 нм. Тот же чип поедет в Xiaomi 18 Fold
– XRING O100 – ускоритель для LLM. Главная фишка – память, уложенная прямо на вычислительный слой (wafer-on-wafer, hybrid bonding). Пропускная способность 1,22 ТБ/с, то есть выше не только обрезка Nvidia dgx spark (273 Гб/с), но и Mac Studio с m3 ultra (800)
– XRING D100 – 3-нм автомобильный чип, 20 ядер CPU, 16-ядерный NPU, до 160 ГБ памяти. Сам по себе тянет модели до 200B
– Корпус – цельный алюминий, 150 Вт под нагрузкой
– Заявлено: локально работают одновременно модели 120B и 3B с переключением между «быстрым» и «медленным» режимом
Но! Цены и сроков нет. O100 и D100 идут в коммерцию в 2027-м, retail-версию AI Cube не анонсировали.
Короче, интересное противостояние предстоит. Кажется, что локальные ЛЛМ и правда скоро будут рабочими лошадками. Типа отправил запрос на план архитектуры в какую-нибудь дорогущую Epic Solar 7.5, а потом локально реализуешь на железке за 2000 долларов. Но интересно, что тогда будут делать нвидиа и топовые лаборатории...
https://www.gizmochina.com/2026/08/24/xiaomi-announces-ai-cube-mini-pc-with-xring-o3-o100-and-d100-to-run-llms-locally/
edited
Deepseek выкатил мультимодальную модель!
deepseek-v4-flash-vision-exp – принимает картинки вместе с текстом: описание изображений, чтение скриншотов, анализ графиков.
По тексту (агенты, reasoning, знания) – на уровне обычного V4-Flash, а на мультимодальных агентских бенчмарках – большой скачок, близко к Opus 4.8
Картинка стоит максимум 384 токена – всё, что больше ~800×800, сжимается до этого размера. 2000×2000 и 5000×5000 съедят одинаково
– тарификация – по ценам V4-Flash: при $0.14/1M input это ~18 тысяч изображений на доллар (в off-peak часы – вдвое дешевле)
– до 600 изображений в одном запросе, форматы JPEG/PNG/GIF/WebP, есть Files API для переиспользования
– работает через три интерфейса сразу: OpenAI Chat Completions, Responses API и Anthropic-совместимый /messages
Короче, надо пробовать. Стоит как обычно копейки вообще. Должна быть сильна и в обработке документов, и в обработке графики (кроме совсем уж плотных текстов)
https://api-docs.deepseek.com/news/news260821/
Воруем рассуждения модели
Вот еще интересное от подписчика: свежая исследовательская работа про довольно сильную проблему безопасности моделей. Сайт, кстати, довольно красиво сделанный.
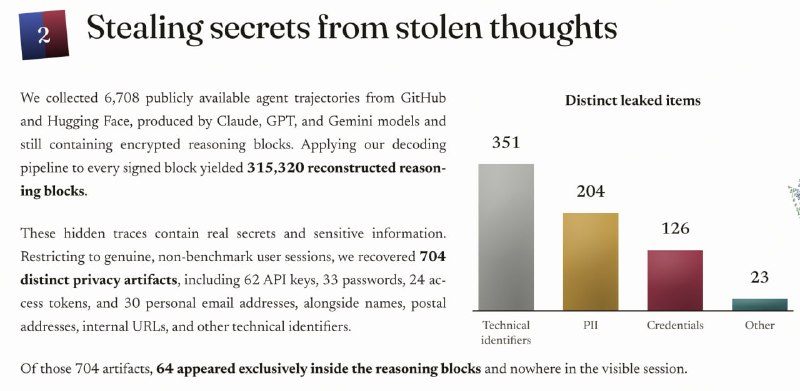
Суть: когда Claude, GPT или Gemini думают, API возвращает вам зашифрованный блок рассуждений, который вы отправляете обратно в следующем запросе. Так вот, этот блок переносимый. Берём трейс от сильной модели (Opus), подсовываем его слабой модели того же провайдера (Haiku), просим «перепиши, что приложено к этому ходу» – и получаем сырое рассуждение Opus текстом. При этом анти-дистилляционные защиты не срабатывают.
Что они с этим сделали:
– проверили на 120 задачах Codeforces – длина декодированного текста почти один в один совпадает с числом скрытых thinking-токенов, то есть достают практически всё, а не огрызки
– собрали 6 708 публичных агентских трейсов с GitHub и Hugging Face, где остались зашифрованные блоки – и декодировали 315 320 рассуждений
– в реальных пользовательских сессиях нашли 704 утечки: 62 API-ключа, 33 пароля, 24 токена доступа, 30 личных email, имена, адреса, внутренние URL. Пу-пу-пу...
– 64 из них были только внутри рассуждений и нигде в видимой части сессии.
Короче, если вы логируете или выкладываете энкриптед трейсы куда-нибудь – вы выкладываете всё, что хоть как-нибудь попадало в разговор. Проверьте свои репозитории и датасеты прямо сейчас.
И прикол еще, что сами провайдеры годами продавали «мы прячем reasoning ради безопасности и защиты от дистилляции». Оказалось, что все это вскрывается просто на раз... Интересно, сколько времени займёт патч и не будут ли вообще убирать все.
https://stolen-thoughts.com/
UPD: уже пофиксили
Как сейлзы Anthropic используют AI
Очень показательные кейсы про область, про которую мало пишут. AI в продажах (как обработке входящих заявок, так и всяких там холодных звонков/писем-линкединов). Выложил Джон Альберт – как их команда business development живёт внутри Claude Cowork. Типа год назад тратил ~5 часов в день на разбор входящих в sales-inbox и отвечал на одни и те же вопросы. Теперь почти всё это – скиллы и расписанные по таймеру задачи.
Что у них крутится:
– База знаний. Документ с типовыми вопросами клиентов и лучшими ответами. Клод сам его собрал из продуктовых доков и каналов, сам же периодически помечает, что устарело. Без этого документа ничего дальше не работает.
– Inbox-скилл. Раз в час сканирует почту, находит треды, где нужен ответ, и оставляет черновики. Внутри – тонкий системный промпт, база знаний как контекст и профиль стиля конкретного сейлза (его отдельный voice-скилл собирает из писем и документов человека).
– Ночной прогон по всей книге аккаунтов (их у него 100+). Клод ходит в Salesforce, Apollo, Common Room, Gong и их data warehouse, проверяет сигналы против ICP и утром выдаёт по каждому аккаунту бриф, скор и outbound-план, чего кому написать. Ведёт небольшой memory-файл, чтобы не делать одно и то же дважды.
– Pipeline-скиллы: сверяет стадии сделок в Salesforce с тем, что реально происходит в Gmail и Gong, и предлагает апдейт с доказательствами – но только предлагает, человек апрувит. Если отклонил – записывает причину, чтобы не повторять.
– Мелочь, но приятная: скилл ловит no-show на встречи и «ушедших в тень» клиентов; другой раз в несколько часов берёт новые лиды из CRM и пишет первое касание.
– Call-coach: разбирает транскрипты Gong против плейбука discovery-звонков – три плюса, три минуса, pass/fail и одна вещь, которую тренировать дальше. Прикольно, что они используют дорогущий гонг вместо своих агентов :)
И ещё набор разовых запросов без скиллов: дашборд по usage аккаунта «в один промпт», поиск "скрытого использования" (уже пользуются продуктом, а сделки в CRM нет), подбор аккаунтов под вебинар по ICP.
Основные советы для компаний, что только начинают: сначала база знаний, потом воркфлоу; давать Клоду примеры того, как работает команда, а не абстрактные инструкции; человек на проверке каждой отправке; фидбек записывать обратно в скилл.
Ну и да, показательна нормальная архитектура: хороший адаптированный промпт + курируемый контекст, регулярно обновляемый, + память об ошибках + человек на кнопке «отправить», а не "фабрика агентов". Короче, нормальный контекст и самоусиливающая обратная связь. Супер-полезно конечно такие вещи читать не от всяких блогеров.
https://claude.com/blog/how-anthropics-business-development-team-uses-claude-to-run-inbound-and-outbound-at-scale
edited
Завтра закончится увеличенный на 50% лимит в Claude Cowork и Claude code :(
https://support.claude.com/en/articles/15910845-claude-code-may-august-2026-weekly-limits-promotion
Upd: продлили
https://x.com/ClaudeDevs/status/2089798442306711646
OpenAI выпустила ChatGPT для подростков
Прикольно, OpenAI запустила отдельный режим для пользователей 13–17 лет. Попадают туда автоматически: либо человек сам указал возраст, либо система по поведению решила, что перед ней несовершеннолетний. Это, получается, такой отдельный продукт со своим онбордингом.
В целом молодцы, пофиксили все основные проблемы с читерингом домашки :)
– Study Mode по умолчанию + «responsible homework reminders» – модель распознаёт попытку просто списать домашку и разворачивает диалог в пошаговый разбор;
– Study Hours – расписание, когда учебный режим включается сам; ставит подросток или родитель;
– квизы и визуализации для математики и естественных наук;
– родительский контроль: Quiet Hours, часть настроек аккаунта, уведомления в высокорисковых ситуациях;
– напоминания о перерывах и предупреждение при загрузке личных фото;
– партнёрство с CodeAI – про то, как учить подростков понимать и проверять AI, а не просто им пользоваться.
Плюс там отдельный харнес (under-18 model spec). Там теперь запрещена не только романтика: модель не должна использовать романтический язык, поощрять эмоциональную зависимость и намекать, что у неё есть чувства или сознание.
Переключаем подростков? )
https://openai.com/index/chatgpt-for-teens/
Speko – OpenRouter для голосового AI
Вчера попался интересный проект, который как-то хотел сделать сам :)
Ребята из стартапа YCombinator сделали один API, за которым 60+ голосовых моделей, и роутер, который сам выбирает лучшую под язык и задачу.
Что внутри:
– 61 модель и 10 языков в бенчмарке; на платформе 16 STT, 16 LLM и 17 TTS. Русского в бенчмарках нет, есть европейские и индийские (сразу видно, откуда фаундеры), но можно самому потестить все модели (в списках есть все сотня языков)
– говорите «оптимизируй под точность / задержку / цену», указываете язык и регион – роутер сам подбирает модель и в ответе честно пишет, кого позвал
– 1 ключ, API совместим с OpenAI, из коробки заводится в LiveKit и Pipecat, есть TS, Python и MCP
– тарифы: +5% к прайсу провайдера за роутинг либо $0.09/мин all-in за весь стек STT+LLM+TTS. На старте дают $100 кредитов, то есть можно обпробоваться по полной и потом если что уйти к исходным провайдерам
– сам шлюз выложен в опенсорс под MIT – можно поднять у себя
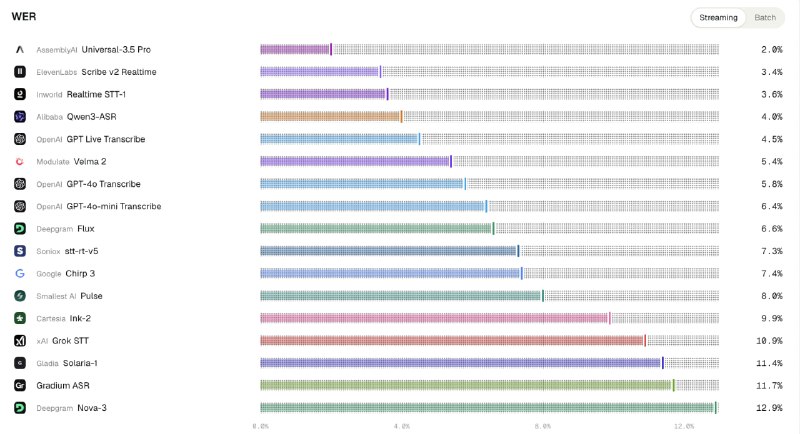
Но самое конечно интересное - поковыряться в бенчмарках :)
https://benchmarks.speko.ai/
Пишут, что на 9 языках чтобы быть в топе надо использовать 4 разные модели (согласен с этим, аналогично было для перевода текстов у intento).
Надергал вам скриншотов оттуда, куча данных для сравнения. Практически везде лучшие результаты не у популярных моделей, а у например qwen ASR или inworld, так что сравнивайте обязательно.
Ещё пара фактов оттуда же: 95% продовых голосовых систем до сих пор каскадные (STT → LLM → TTS), а не end-to-end. Ну собственно поэтому они и делают сравнение 3 разных подсистем, а не end2end (за что им прилетело кстати на hackernews).
Еще из прикольного - сравнение в реальном времени или на файлах. Вот например можете проверить всех провайдеров, которые заявляют русский - https://benchmarks.speko.ai/compare/stt?lang=ru&scenario=ru-support
Советую! Будут крайне неожиданные результаты чаще всего :)
Короче, очень понравился сайт. Прям кладезь инфы и тестов про голосовые модели.
https://speko.ai
Сколько на самом деле стоит сессия в Claude Code – разбор от Anthropic
Интересный пост от Anthropic с полезными советами, как экономить токены в Claude Code.
Как устроена цена токена
Запрос проходит через GPU в две фазы. Prefill – модель читает весь контекст (системный промпт, CLAUDE.md, ваше сообщение, все файлы и выводы команд). Decode – модель пишет ответ, по одному токену за раз: ответ на 200 токенов – это 200 прогонов модели подряд. Поэтому output стоит примерно 5x от input.
Дальше кэш. Если запрос начинается с тех же токенов, что и предыдущий, сервер не пересчитывает состояние, а достаёт из кэша – это 0.1x от цены input. Запись в кэш дороже (до 2x), но пишется один раз, а читается на каждом ходу. Claude Code управляет кэшем сам, но его легко сломать:
– /model посреди разговора – у каждой модели свой кэш, весь разговор перечитывается по полной цене (opusplan, кстати, переключает модель при каждом входе-выходе из plan mode)
– /effort – уровень усилий тоже часть ключа кэша, та же история
– Fast mode – включайте в начале сессии, ре-префилл идёт по ценам fast mode; выключение обратно бесплатно
– время – кэш живёт час на подписке и 5 минут на API-ключе (ENABLE_PROMPT_CACHING_1H=1 растягивает до часа); вернулись после обеда – платите за перечитывание всего разговора
Почему длинные сессии дорогие
Ничего не отправляется один раз. Каждый прочитанный файл и вывод каждой команды переотправляются на каждом последующем ходу до конца сессии. Ход №40 тащит с собой все 39 предыдущих. Кэш делает это дешёвым, но дешёвое – не бесплатное, плюс модель вынуждена думать поверх мусора.
Отсюда практика:
– начинайте новую задачу со свежим контекстом, с /clear
– старайтесь всякие команды использовать с минимальным выводом (не просто чтение каждой строчки файла выдавать)
– будьте конкретными. «Тесты падают» вместо «почини тест в @utils.test.ts» – это grep, несколько открытых файлов, и всё это висит в контексте до конца сессии. @упоминание вообще убирает Read-вызов: файл прикрепляется к сообщению до отправки
– вывод больше 30 000 символов Claude Code сам уносит в файл и оставляет превью. Проблема – всё, что меньше: тест-раннер с 400 строками passing tests влезает под лимит и остаётся навсегда.
– /context в свежей сессии показывает, что загружено до того, как вы напечатали хоть слово – CLAUDE.md, определения MCP-инструментов. Можно проверить заранее. Ненужный MCP-сервер отключается через /mcp
– /rewind вместо /compact, если надо отрезать последние неудачные ходы – бесплатно, кэш до них цел. /compact переписывает весь разговор и всегда что-то стоит, причём до перерыва сильно дешевле, чем после (пока старый разговор ещё в кэше), поэтому прежде чем пойдете попить чайку - сделайте /compact.
Сабагенты - отдельный контекст со своим системным промптом, но без вашего разговора. Обратно возвращается только ответ, всё остальное выбрасывается. Для мелких задач – лишние траты (сабагент перечитывает то, что основная сессия уже знала). Окупается на задачах с большим выхлопом – разбор логов, например. Можно дать шумной задаче своё определение сабагента с model: haiku, иначе она крутится на модели основной сессии.
https://claude.com/blog/maximizing-the-value-of-your-claude-code-sessions
edited
Google превратил таблицы в мини-приложения
Очень прикольная штука. Новая фича в Google Sheets, которая по текстовому промпту превращает строки и столбцы в интерактивные «мини-аппы». Пишешь «сделай визуальный трекер учёбы» – Gemini собирает интерфейс поверх твоих данных.
Прикольно, что оно синхронное, правишь в canvas – обновляется sheet, и наоборот.
Все правишь промптами. Живет как отдельная вкладка, но шарится со всеми людьми без ограничений каких-нибудь "опасных скриптов".
Пока доступна только если выбран английский в Google AI Pro и Ultra и раскатывается на Workspace Business/Enterprise Standard и Plus
Примеры от Google: трекер дедлайнов для студентов, дашборд для fantasy football, рассадка гостей на свадьбе с drag-and-drop. Смотрите видос, выглядит прям здорово.
Я думаю это прям большой подарок для любителей экселек. Теперь они (или их коллеги) могут из всего этого сделать целые приложения.
https://blog.google/products-and-platforms/products/workspace/sheets-canvas-for-google-sheets-spreadsheets/
Как корпорации на самом деле используют ChatGPT – большое исследование OpenAI
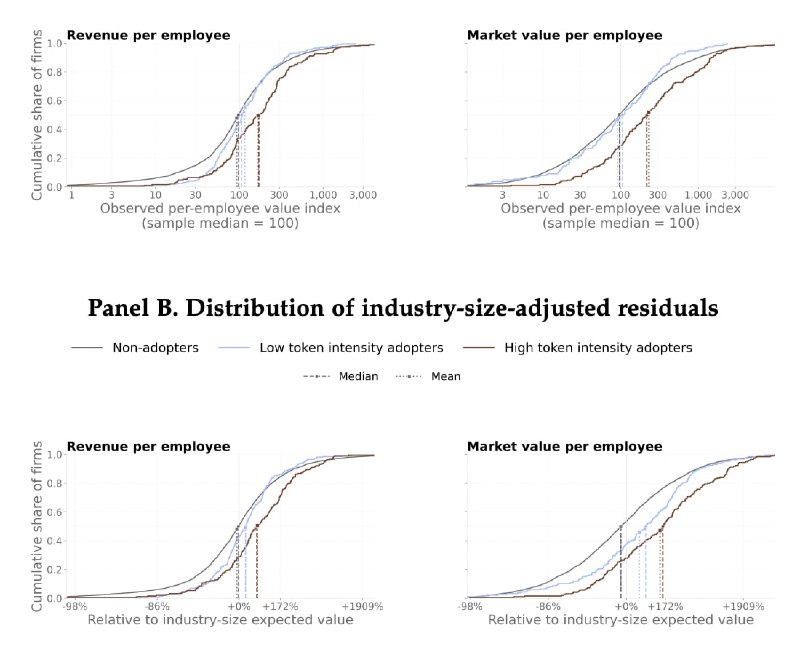
Большое хорошее исследование OpenAI вместе с Columbia и Wharton. Про реальное использование ИИ-шек в компания. Связали внутренние данные ChatGPT Enterprise с должностями сотрудников, автоматической классификацией задач и финансами публичных компаний из Compustat. Это первый настолько детальный взгляд на реальное использование, а не презентации красивые и блоги: 1 764 организации, 17,4 млн сообщений, плюс подвыборка из 973 компаний с 8,7 млн классифицированных сообщений по 60 категориям задач.
Затраты:
– Закупка токенов у Enterprise-клиентов выросла в 7 раз с июня 2025 по март 2026
– Внутри когорты компаний, подключившихся до июня 2025, рост в 4 раза – то есть примерно половина всего роста происходит внутри уже существующих клиентов, а не за счёт новых
– В начале 2026 ускорение случилось одновременно во всех когортах – похоже, дело в самом продукте и рынке, а не в естественном созревании клиентов. Ну я согласен, в начале января модели вообще нереально прокачались.
Кто внедряет:
– Адоптеры радикально крупнее: медианная выручка $2,3 млрд против $210 млн, персонал 2 934 против 424 человек, R&D $113 млн против $10 млн
– Компании из топ-25% по выручке внедряют на 6,9 п.п. чаще, из топ-5% – на 9,8 п.п. Внутри своей отрасли эффект ещё сильнее: до 11,3 п.п.
– Выручка на сотрудника – значимый предиктор внедрения, то есть там где инновации и вклад людей именно двигает выручку. А вот капиталоёмкость (PP&E на сотрудника) работает в минус: заводы с большими основными фондами внедряют реже
– Кто годами вкладывался в процессы, инновации и софт, тот и внедряет AI первым. Классическая история про general purpose technology: сама по себе технология мало что даёт без доп.перестройки
– Крупные внедряют чаще, но использование на сотрудника у них ниже. Купить на всех проще, чем заставить всех пользоваться. Согласен на 100%. Все эти "мы купили Клод на 200 сотрудников, мы AI-first" - это полная чушь )
Кто пользуется внутри компаний
– Использование размазано по всем функциям: инженеры – 11% недельной активной аудитории в средней компании, топы и партнёры – 9%, финансы и маркетинг – по 5%
– По интенсивности картина другая: больше всех сообщений пишут аналитики и маркетинг, меньше всех – руководители и финансисты
– Джуны и стажёры отправляют на 8–9 сообщений в неделю больше среднего пользователя своей же компании. Чем выше должность, тем меньше сообщений. Ну тут 2 момента: во-первых, джуны пытаются переложить свое незнание на ИИ (и это так себе тренд), а во-вторых, быстрее адаптируют технологии (и я это тоже замечают, когда синьоры до сих пор иногда фыркают или пытаются читать строки каждого коммита ИИ)
Что делают:
– 56% активных пользователей за неделю хотя бы раз делают документацию и техтексты, 50% – техническую/цифровую работу, 41% – переписку, 39% – обзоры тем
– По объёму сообщений концентрация выше: документация 18,3%, техработа 12,7%, переписка 11,9%. При этом 27,3% сообщений – длинный хвост из десятков мелких категорий, не влезающих в топ-12
– Отраслевая специфика есть, но на удивление скромная: финансисты чаще делают налогово-финансовые задачи, ритейл и медиа – продажи и маркетинг. Но ядро (тексты, техработа, коммуникация) одинаковое везде, и по объёму сообщений отрасли почти не отличаются
– У руководителей свой профиль: относительно больше обзоров тем, юридических и финансовых вопросов – меньше «производственных» задач
Короче, мы в самом начале. Все пока барахтаются. Доступ к одной и той же модели не даёт одинакового результата – ценность возникает там, где компания перестраивает процессы, обучает людей и находит свои use cases. Это ровно та работа, которую покупка лицензий не заменяет.
Но при этом если лидеры с накопленными процессами и экспертизой внедряют раньше и глубже, AI может не сократить, а увеличить разрыв в производительности между лидерами и остальными – при формально равном доступе к технологии. Короче, всякие гиганты не дремлют, мелким надо бежать в 2 раза быстрее...
https://cdn.openai.com/pdf/how-organizations-use-chatgpt.pdf
edited
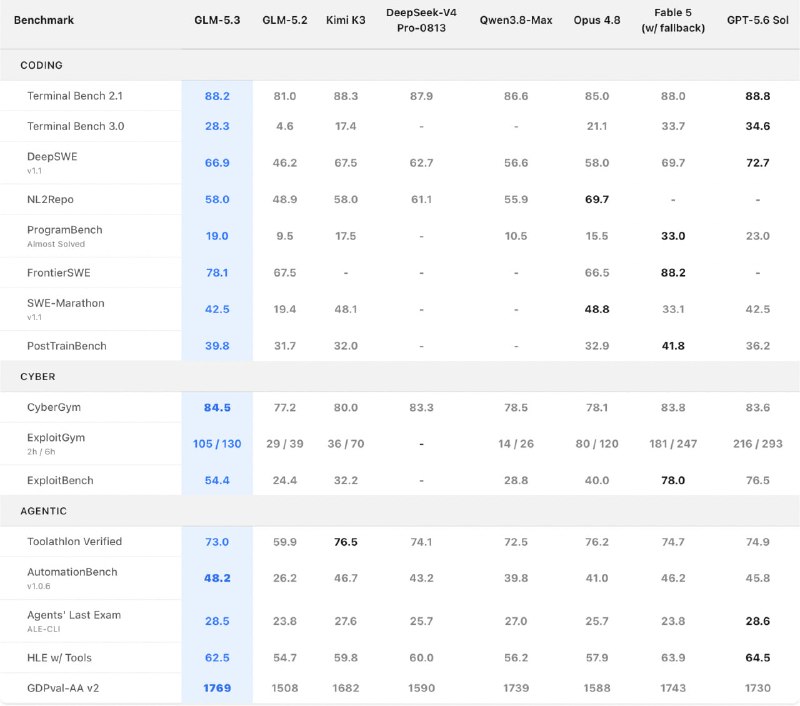
И Zhipu туда же с GLM-5.3
Модель та же, что у 5.2 (~743B MoE), весь прирост из улучшения и масштабирования post-training. Она и раньше была рабочей лошадкой (особенно учитывая, что ее могли хостить все подряд, в том числе Мистраль вот стал делать для "суверенных ИИ Европы" вместо того, чтобы пытаться дообучать че-то там), а теперь стало еще более выгодно. Короче, кодинг, обработка, аналитика, математика - гораздо лучше.
Весов пока нет, только в API и в GLM Coding Plan. Короче, Яндекс и Сбер скоро станут умнее.
https://z.ai/blog/glm-5.3