Claude в Chrome теперь – это Cowork
Прикольно, сделали полноценную рабочую сессию. То есть разговор, начатый в браузере, продолжается в десктопе и на мобильном, работают skills и коннекторы. Claude видит страницу, кликает, заполняет формы под вашими логинами. Кстати в Codex немного кривые чаты, но они синхронизировались уже, Клод догоняет.
Главный сценарий – системы без API: внутренние дашборды, legacy, порталы вендоров. Честно говоря все больше этим пользуюсь. Буквально сегодня получал сертификат из реестра компаний с помощью ИИ-шек. А уж настройка всяких гуглоклаудов и Ажуров (чего терпеть не могу) - милое дело. Главное - проверить план перед запуском.
Теперь вообще можно так: собрал инвойсы из кабинетов поставщиков в таблицу в браузере – докрутил её в десктопе с локальными файлами. Эт тоже прям мой юзкейс :)
Видос: https://youtu.be/C-5wF6tkQ2Q?is=7K-bw55ZAu62Zrxf
Про prompt injection пишут честно: риск снижен, но не убран. Добавили проверку действий – перед отправкой формы или скачиванием файла система сверяет действие с исходной задачей.
Доступно на Max и Team, Pro – в ближайшие недели.
Для компаний с зоопарком старых систем это дешевле, чем писать коннекторы.
https://claude.com/blog/cowork-chrome-side-panel
Google выкатил Gemini 3.7 Flash
Их прорвало что ли? Или летние нагрузки меньшие освободили GPU для тренинга?
– Цена не изменилась: $0.75 / $3.75 за 1M токенов. Для сравнения: Claude Sonnet 5 – $2 / $10, GPT-5.6 Terra – $2 / $12 (он типа круче Луны) То есть Flash в 2.5–3 раза дешевле конкурентов. Но это промо-цена до конца 2026. С января – $1.50 / $7.50. Хах, тут каждые 2 недели выходят новые модели, а они рассказывают, что будет через 5 месяцев :)
– FrontierCode 43.6% – лучший результат среди всех, включая Sonnet 5 и GPT-5.6. Огоняет флагманы конкурентов в production-коде
– AutomationBench (автоматизация enterprise-процессов): 30.4% против 10.7% у Sonnet 5
– Длинный контекст: 97% на MRCR при 128k.
– Понимание PDF (GDP.pdf): 34% – тоже лучший результат, хотя абсолютные цифры показывают, что до "решённой задачи" всем ещё далеко
Слабые места тоже есть: агентские задачи (Terminal-bench 3.0, OSWorld) – GPT-5.6 заметно впереди, а в знаниевой работе (GDPVal) лидирует Muse Spark.
Короче, перейти с 3.5/3.6 наверное стоит после тестов, для больших доков, обработок и кодовых баз должно быть норм.
https://deepmind.google/models/model-cards/gemini-3-7-flash/
DeepSeek V4 Pro 0813 вышел.
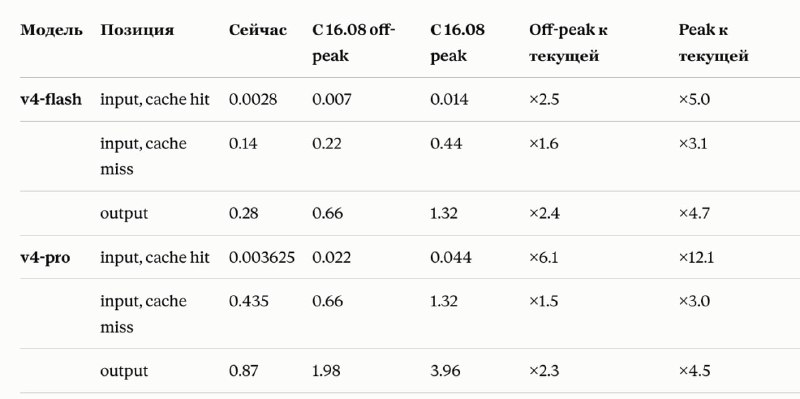
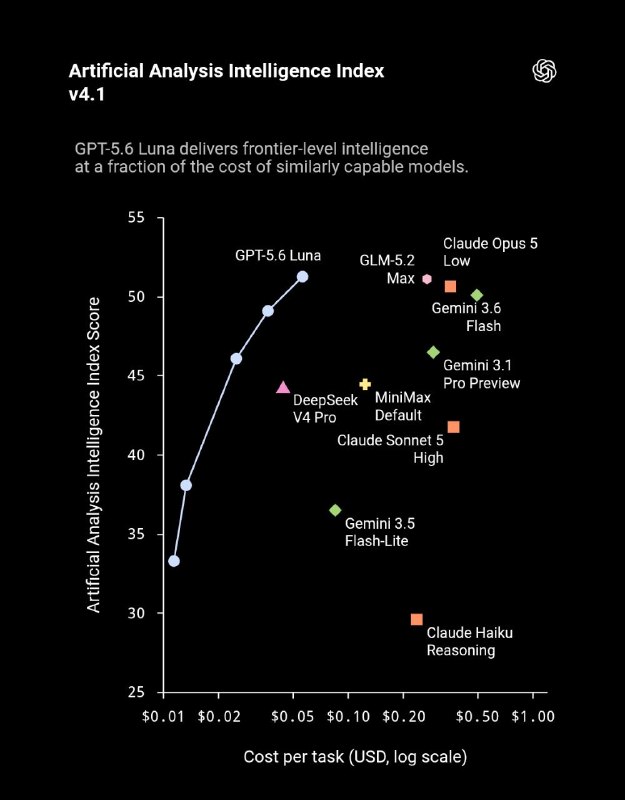
Ждал бенчмарков и цен новых. Выглядит довольно неплохо, но с новыми ценами уже чуууть уступает GPT-5.6 Luna, а если не видно разницы и модель от OpenAI доступа из каждого утюга, то смысла как будто нет.
В целом увеличение не такое страшное. Примерно в 1,5-2,5 раза. Кэш - больше подорожал, но он и стоил вообще копейки. В пиковое время все еще в 2 раза выше. Пик - это китайский пик, то есть по Кипру/Москве - 4-7 утра и 9-13 утра. Короче, до обеда не работать с deepseek :)
https://artificialanalysis.ai/models/deepseek-v4-pro
Хах, новый компактный Qwen завтра:
https://huggingface.co/Qwen/Qwen3.8-27B
С Qwen связан один прикол. Тестировал разные модели для извлечения данных в закрытой системе (никакими облачными провайдерами без DPA не за тыщщу миллионов пользоваться нельзя, нужны "суверенные модели" со всякими zero data retention или хостинг на своих серверах). Компания европейская и соответственно я попробовал все, что хвалится своей безопасностью и "умом" от европейских провайдеров и лабораторий на английском, французском и немецком языках.
Так вот Qwen3.6-35B-A3B за копейки порвал всех просто в клочья... То есть китайские модели лучше работают на европейских языках, чем европейские :)
ChatGPT снова сбросил лимиты :) Было в субботу, во вторник и вот сегодня. Ощущение, что лучшая тактика - за пару дней вычистить все, перейти на Claude, подождать сброса, снова потратить все
Grok 4.6 вышел
Главный фокус – долгоживущие агенты и интерактивная/визуальная работа: модель должна держать задачу на много шагов, а не выдавать один хороший ответ.
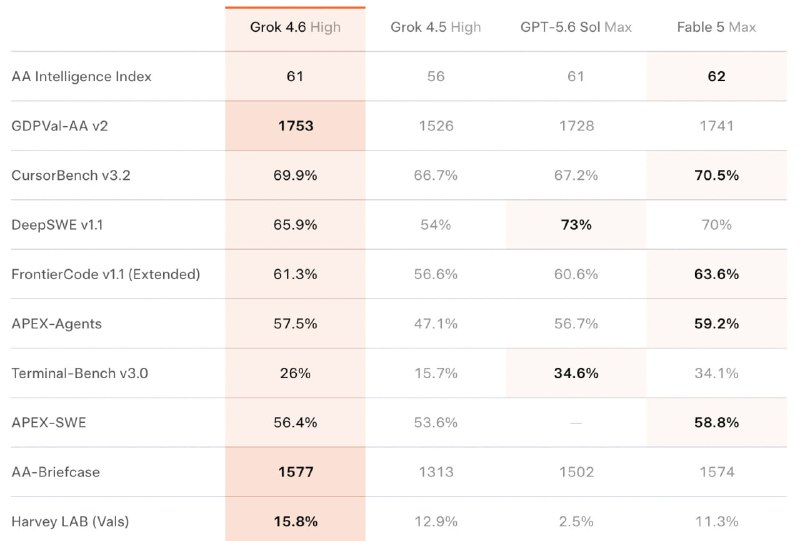
– AA Intelligence Index: 61 против 56 у Grok 4.5. Это ровно уровень GPT-5.6 Sol Max (61) и почти Fable 5 Max (62). Скачок за месяц серьёзный. Прикольно, что в табличке в скриншоте не боятся показывать бенчмарки, на которых не занимают 1 места. Сейчас все в тройке, но при этом цена вообще мизерная - $2 / $6 за 1M токенов, есть fast-вариант вдвое дороже. Первую неделю – 2x включённого лимита в Grok Build и Cursor.
– Доступ сразу везде: Cursor, Grok Build, API, OpenRouter, Vercel, Cloudflare.
– Тренировали интересно: Grok 4.5 использовали, чтобы перегенерировать SFT-траектории для 4.6, а мусорные трейсы отфильтровали модельными проверками. Модель учит модель.
В кодинге пока чуть отстает, а вот в работе белых воротничков - лидер: GDPval-AA v2 — 1753 (у Fable 1741, у GPT 1728), AA-Briefcase – 1577, и особенно Harvey LAB на юридических задачах: 15.8% против 11.3% у Fable и 2.5% у GPT-5.6. Разрыв в шесть раз.
Кажется это сейчас лучший вариант для длинных агентов над документами и офисной работой: разбор договоров, заявок, отчётности.
x.ai/news/grok-4-6
edited
Как перевести команду разработки на AI-агентов
Провёл сегодня тренинг для продуктовой команды (мобильное приложение, несколько миллионов установок), и после него прилетел вопрос про разработчиков, как им-то переключится и какие инструменты использовать.
Ну, мое мнение, что всякие блогерские и ютюбовские советы, а также специализированные скиллы и MCP становятся неактуальными при первом же большом обновлении моделей или оболочек, поэтому единственное, к кому стоит прислушиваться - ведущие лаборатории. Они знают, над чем работают и что будет неактуально уже в ближайший месяц и при этом могут выстраивать state-of-the-art процесс с текущими моделями, чтобы быть быстрее и круче конкурентов.
Короче, что стоит изучить:
Самый содержательный текст про agent-first команду – Harness engineering от OpenAI. Люди задают архитектуру, ограничения и критерии качества, агенты исполняют. Короткий AGENTS.md (~100 строк) служит картой, а не простыней инструкций. Документация, планы и техдолг живут рядом с кодом, а их актуальность проверяют CI и отдельные «doc-gardening» агенты.
Для руководителей есть более широкий Building an AI-native engineering team – про изменения по всему SDLC и то, что ownership кода всё равно остаётся за инженерами.
У Anthropic главный практический документ – Best practices for Claude Code: CLAUDE.md, workflow «исследовать - спланировать - реализовать - проверить», subagents, hooks, worktrees. Ключевая мысль: агенту нужен исполняемый способ проверить свою работу – тест, сборка, линтер, скриншот.
Для обмена командными практиками лучший механизм – skills: повторяемые workflows типа fix-issue или review-api-change лежат в репозитории и работают у всех одинаково. У OpenAI это описано в Customization, а почему нельзя просто свалить все знания команды в один гигантский промпт – объясняет Effective context engineering.
По параллельной разработке рекомендации совпадают у обоих:
– начинать с независимых read-heavy задач: ресёрч кодовой базы, анализ логов, поиск пробелов в тестах, code review, это можно делать с любой системой и любой ИИ-кой
– изолировать агентов через git worktrees – отдельный checkout на каждого
– выбор архитектуры (routing, orchestrator-workers, evaluator-optimizer) разобран в Building effective agents
– для длинных задач – журнал прогресса и проверяемое состояние для следующего агента, см. Effective harnesses for long-running agents
В общем, советы вроде банальные, но их никто не делает, все оптимизируют локальную свою работу, а в итоге даже при переходе на другую ИИ-ку, а тем более другому сотруднику уже будет плохо: короткий CLAUDE.md/AGENTS.md как карта, docs/ рядом с кодом, skills для повторяемых workflows, CI проверяет правила механически, тесты – критерий завершения работы.
Grok Bot – xAI выкатили «AI-коллег»
Кажется, у Grok какой-то ренессанс. Новую модель для кодинга сильную тестят на Арене, image generation выпустили один из лучших, а теперь вот наконец-то конкурента Hermes/OpenClaw. Пишешь боту в мессенджере, он уходит делать задачу и возвращается с результатом. Чем мне не нравились предыдущие версии, что это по сути поддерживалось микро-командой, а уровень абстракции там просто зашкаливал, то есть вся система работала как крейзи черный ящик, которому ты даешь доступ вообще к своей жизни... Такое себе. Я ждал, что более "энтерпрайз"-версия будет от ChatGPT, раз они по сути купили OpenClaw, но нет, Grok был быстрее.
В общем, получается так:
– у каждого бота свой компьютер – логинится в ваши Zendesk/CRM/почту и работает в интерфейсах как человек
– обучение показом: один раз проходишь workflow, бот сохраняет его как рутину и дальше гоняет сам
– боты помнят контекст, учатся и передают знания друг другу – показал одному, к пятнице отдаёшь весь проект
– несколько ботов в одном треде перекидывают работу между собой: ресёрч - тексты - отправка
– готовые роли: outbound-продажи, рекрутинг, баг-репродакшн, chief of staff
Короче, звучит прям как "новый сотрудник вышел на работу"...
Цены пока негуманные, видимо чтобы протестировать на ранних последователях: $200/мес соло, $120 за место в командах. Есть macOS, Windows, iOS и Linux, Android обещают позже.
https://x.ai/bot
Модель на 14 МБ, которая вызывает функции
Много сейчас ковыряюсь с локальными ЛЛМ-ками/библиотеками, чтобы персональные данные удалять или структурировать извлеченные данные и вот неплохой кандидат, который даже в вебе можно использовать.
Needle 2 – открытая модель на 45M параметров для tool calling и извлечения структурированных данных. Именно для вызова функций и создания JSON.
Цифры, ради которых стоит читать дальше:
– 14 МБ бинарник, 28 МБ RAM на всю сессию, даже для всякого старья подходит
– 500 ток/с на Raspberry Pi 5, 300–700 на старых телефонах
– 2-битное квантование, причём модель так и обучалась
– на мобильных бенчмарках идёт вровень с FunctionGemma 270M и LFM2.5 230M, будучи в 5–70 раз меньше (но по правде сказать LFM2.5 230M поумнее будет, конечно, и больше подходит для среднего компа)
– Apache 2.0, веса на Hugging Face, можно даже файнтюнить под ваши задачи.
Короче, у всяких локальных обработок часто не нужна мощща гигантских моделей, есть набор функций с типизированными параметрами – задача только сопоставить фразу пользователя с ними. Pebble кстати гоняет эту модель локально в приложении для своего кольца без экрана.
Если у вас IoT, носимые устройства или голосовое управление чем угодно – посмотрите, порог входа смешной.
https://cactuscompute.com/needle
Lenny опять расширил свой Product Pass – и это уже какой-то аттракцион невиданной щедрости!
11 новых продуктов, теперь их 34, а Lenny заявляет ценность в $40k+ для Insider-подписки за $400 в год. Даже с поправкой на маркетинг – для меня реальная ценность набора уже перевалила за $10 000. Один нюанс: часть новинок только для Insider-тарифа, и все – только для новых аккаунтов в продукте.
Что добавили:
– Runway Pro – AI-видео, картинки, аудио и аватары в одном месте: свои модели (Gen-4.5, Aleph) плюс все чужие (Veo, Kling, Seedance). $336 (1 год, только Insider).
– Higgsfield Pro – AI-видеоплатформа для рекламы и кинематографичного контента. $348 (1 год, только Insider).
– Customer.io Essentials – платформа customer engagement: email, SMS, push, in-app на сессия пользователей. $1,200 (1 год).
– Jam Team – багрепорты одной ссылкой: запись экрана + консоль, network, метаданные – сразу в Slack, трекер или кодинг-агенту. 10 мест, $1,920 (1 год).
– Supercut Pro – скринрекордер вместо митингов, замена Loom с AI-ассистентом по содержимому видео. 10 мест, $1,800 (1 год).
– Resend – email API для разработчиков, который советуют сами Claude Code и Codex при вайб-кодинге. $240 (1 год).
– Pangram – детектор AI-текстов с расширением для Chrome: показывает, какие посты в LinkedIn и X написала нейросеть. $540 (1 год, только Insider).
– Readwise + Reader – читалка-«второй мозг» для статей, рассылок, PDF и подкастов, с MCP для агентов. $120 (1 год).
– Mercury Personal – личный банкинг от Mercury, лучший UX среди необанков. $480 (2 года, только Insider).
– Brain.fm – музыка для фокуса. $100 (1 год).
– Waking Up – медитации и mind-тренинг от Сэма Харриса. $129 (1 год).
Из нового отказался от подписки на Heygen и взял халявную Higgsfield и Runway. Плюс пользовался resend, а теперь можно платный тариф взять. Ну и интересно попробовать Jam Team и Supercut.
Короче, я до сих пор всячески и всецело рекомендую!
https://www.lennysproductpass.com/
Помогает ли claude.md файл?
Интересный рисерч. Взяли три реальных Python-репозитория с хорошими AGENTS.md – pdm, firebase-admin-python и opshin. Из смерженных PR сделали 17 задач: описание PR = промпт агенту, тесты из этого же PR = скрытая проверка. Агент тестов не видит.
Дальше три режима подачи контекста:
– none – файл вообще убран из воркспейса
– always_on – весь AGENTS.md вставляется в системный промпт каждый ход
– selective – вместо файла лежит вики по темам, агент читает нужное сам
Прогнали на Claude Code (Sonnet 4.6) и Codex CLI (GPT-5.5), по 3 повтора. Всего 288 засчитанных прогонов.
Результат - все тлен. Claude: 53,3% / 55,6% / 55,6%. Codex: 58,8% / 56,9% / 52,9%. В пределах шума.
Автор вручную разобрал «почти прошедшие» падения – те, где до зачёта не хватило пары тестов. И там ни одного случая, где агенту не хватило знания о репозитории. Не хватало интеллекта и инженерии, и такое AGENTS.md не лечит.
Отдельно проверял улучшение правил, чтобы падения починить. Не получилось.
А вот что реально сработало: у репозитория opshin в AGENTS.md есть строчка: полный прогон тестов занимает больше 20 минут. Без контекста Claude вслепую гонял весь сьют 3,67 раза за прогон. С always_on – 2,44. С selective – 1,67. Время выполнения упало с 2689 до ~2030 секунд, примерно на четверть. Корректность при этом не сдвинулась ни на пункт.
То есть контекст-файл работает как операционная инструкция, а не как учебник. «Не запускай полный сьют, он медленный», «сборка вот этой командой», «линтер такой» – экономит время и деньги.
А вот всякие там "ты синьор разработчик", "мы придерживаемся чистой архитектуры и SOLID" – не делает ничего измеримого.
До этого были две работы с противоположными выводами – одна на Codex-агентах нашла пользу у файла, другая на Claude-агентах не нашла. Оказалось, сложность задач у агентов не совпадает: примерно у 40% задач агенты по-разному упираются в потолок. Задача, на которой можно было бы увидеть эффект у одного агента, у другого либо решается всегда, либо не решается никогда.
Короче, писать AGENTS.md стоит, но как список правил, не как описание проекта. Команды, тайминги, грабли, что не трогать. Всё, что агент может вывести из кода сам, туда класть бессмысленно: он и выведет. А качество реализации вытягивается не файлом, а декомпозицией задачи и примерами.
https://arxiv.org/abs/2607.27250
edited
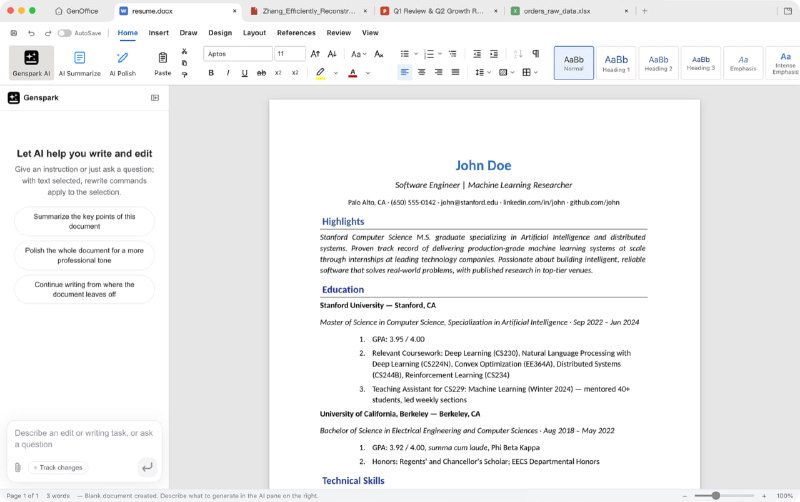
GenOffice: офисный пакет за неделю
Genspark выложил 3 августа GenOffice – десктопный офис с ИИ внутри, под Apache 2.0.
Что внутри:
– Docs, Sheets, Slides, PDF – полноценная поддержка .docx/.xlsx/.pptx
– пять Electron-приложений на общем движке, TypeScript + Rust-сайдкар для xlsx, таблицы на опенсорсном Univer
– Super Agent живёт внутри документа, а не в боковом чатике: попросил свести бюджет – формулы появились прямо в ячейках
– Mac (Apple Silicon) и Windows x64, ядро бесплатное и без рекламы, ИИ-функции жгут кредиты Genspark
Сделал типа один инженер за одну неделю и примерно ~$10 000 токенов.
Ну на самом деле у них наработок было много и опенсорса тоже, так что честнее читать это как «неделя на сборку из зрелых кусков», а не «Office с нуля за семь дней».
Ну и надо помнить, что это альфа версия, ИИ-ка требует ваш аккаунт genspark, планируют энетпрайз версию обещают скоро.
Но если стоимость сборки правдоподобного офисного клона реально упала до пятизначной суммы, то Word и Excel и все подробные огромные продукты уже вообще никак не защищены, помогает только дистрибуция...
https://genoffice.ai/
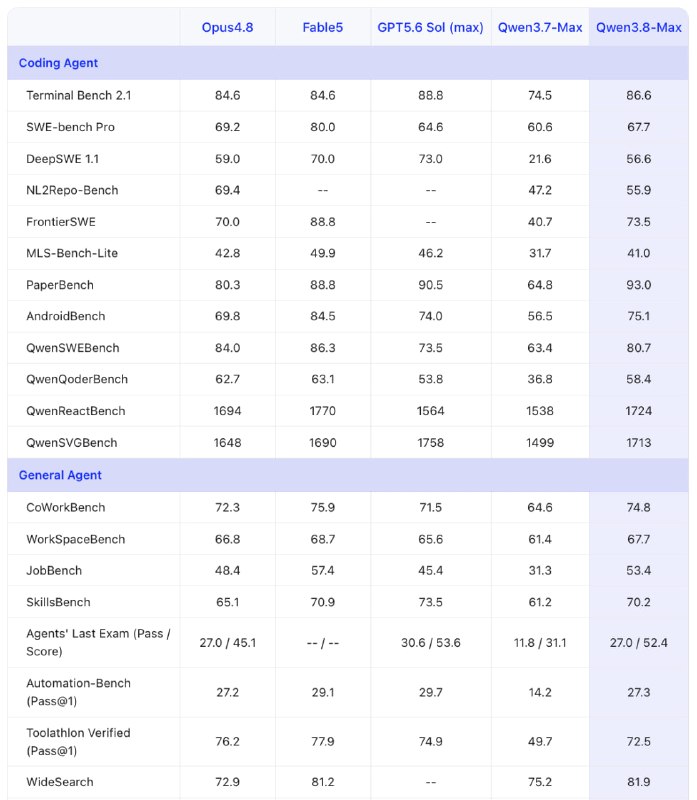
Qwen 3.8-Max вышел. Через неделю и веса тоже
2,4 триллиона параметров, 95B активных, контекст 1M.
Цены получается $2 вход / $6 выход
Для сравнения
DeepSeek V4-Flash – $0,14 / $0,28
GLM-5.2 – $1,4 / $4,4
Kimi K3 – $3 / $15
Claude Fable 5 – $10 / $50
Короче я так понял, что они прокачали ее максимально в мультимодальности: всякое распознавание картинок, скриншотов, документов и все вокруг него:
PaperBench 93,0 – это выше GPT5.6 Sol с его 90,5. Весь мультимодальный блок тоже высокий: MathVision 95,2, CharXiv 88,4, OmniDocBench 92,1. Это модель для агентов, которые смотрят на экран, читают PDF и доводят задачу до готового файла. Остальные топовые китайцы чисто текстовые.
Где не очень: чистый код по описанию. DeepSWE 56,6 – ниже, чем у Kimi K3 (67,5), Fable 5 (70,0) и GPT5.6 (73,0). FrontierSWE 73,5 против 81,2 у Kimi.
Ну а всякая последовательная работа крутая:
- За 16 дней автономной работы с нуля построил проект oh-my-cli с саморазвивающимся кодинговым харнесом - qwen-code-dev-bot/oh-my-cli
- За ~125 часов написал 7 600 строк кода для проверки статьи, провёл 33 раунда GPU-обучения, воспроизвёл все 6 выводов статьи, затем придумал и проверил 18 своих гипотез и превзошёл метод авторов на +2,7 пункта
- За 500 ходов оптимизировал чип, уменьшил площадь кристалла в 5 раз, лучший результат среди всех проверенных моделей.
Короче, там где модель может посмотреть на результаты и получать обратную связь или нужны PDF/фото/видео- результаты отличные, даже круче закрытых моделей. Чисто по коду лучше брать GLM-5.2, Kimi и топовых OpenAI/Anthropic.
https://qwen.ai/blog?id=qwen3.8
DeepSeek flash существенно обновили
Теперь точно дешевле Luna при существенно прокачанной агентской работе
https://api-docs.deepseek.com/updates/
edited
OpenAI снизил цены на GPT‑5.6
– Luna: дешевле в 5 раз(!), теперь $0.20 / $1.20 за млн токенов (вход/выход)
– Terra: минус 20%, $2 / $12
– Sol: цена та же, но вместо Priority теперь Fast mode – до 2.5× быстрее за двойную цену
Написали, что они гоняют
Sol для оптимизации инференса Sol, уже на 20% скорость увеличили ... Что будет дальше...
– Luna, кстати, по данным OpenAI, обгоняет Fable 5 на профессиональных задачах при цене за задачу на ~99% ниже
https://openai.com/index/advancing-the-price-performance-frontier-with-gpt-5-6/
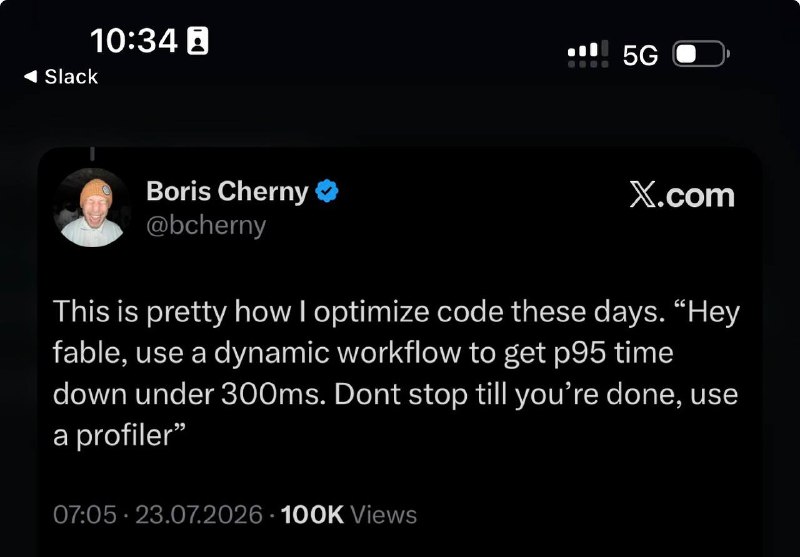
Промпт-инжиниринг лета 2026 года
Че-то там наговорил за 10 минут бессвязное или просто "давай там сделай оптимизации короче. Пока не получится - не заканчивай" :)
Я тоже так часто делаю :)
edited
Пользователям Revolut дадут 6-12 месяцев ChatGPT Go
Можно друзьям/семье/родителям дать. Промокод в личном кабинете:
Premium - на 6 месяцев
Metal - на 12 месяцев
Ultra - на 12 месяцев вам и другу
https://help.revolut.com/help/profile-and-plan/my-plan-benefits/partnership-benefits/question-chatgpt/
Обновленный тест на решение реальных кодинговых задач с гитхаба
Fable на первом, Opus на третьем, Sol на 5, но Grok реально на втором месте, по цене-качеству один из лидеров. Kimi K3 еще не тестили. Короче, Grok для разнообразных кодинговых задач - очень даже ничего.
https://swe-rebench.com/
edited
Kimi K3 таки выложили в опенсорc
https://huggingface.co/moonshotai/Kimi-K3
И опубликовали отчет.
В общем, ничего супер-нового, но несколько интересных вещей отметил:
– 2.8T параметров всего, но на каждый токен работает 104B – 16 экспертов из 896.
– Контекст 1M, а позиционного кодирования нет вообще. Поэтому огромный контекст для нее вообще детский лепет и памяти на него не надо вагонами завозить.
– MXFP4-квантизацию вводят не после обучения, а прямо во время RL. Модель с самого начала учится жить сжатой, то есть серверную стойку можно взять и поменьше :)
– Стараются экономно расходовать токены, в том числе в мультимодальности. На BrowseComp лучший результат в мире за $2.03 за задачу. GPT-5.6 Sol вдвое дороже, Клод на максимуме – на порядок
Еще из прикольного:
– За обучение создали 51 миллион виртуалок-песочниц. Пока модель думает, песочница на паузе и не ест ресурсы вообще – а думает она до 98% времени жизни задачи. Вот на этом простое и сэкономили кучу денег на обучение.
– За один 48-часовой автономный прогон K3 спроектировала и проверила прототип чипа для ИИ, вообще с нуля. 4 мм², 8700 токенов/с в RTL-симуляции. Исходники выложили на гитхаб
– Написала свой компилятор для ИИ, обгоняет torch.compile
– Воспроизвела результат из астрофизики за два часа вместо двух недель: 20+ статей, 300 уравнений состояния, нашла ошибки в опубликованных формулах
– Смонтировала видео-ролик про собственную архитектуру из 56 клипов
Отдельно про кибербез. Мерились с GLM-5.2. Нашли 16 ранее неизвестных уязвимостей, две в ядре Linux. UK AISI и NIST проверяли независимо: GLM обходит, до фронтира не дотягивает – 0 из 41 на end-to-end эксплойтах. То есть по кибербезопасности модель лучшая из опенсорса.
По бенчмаркам всё то же, что и неделю назад: первое место на WebDev Arena среди 99 моделей (впервые открытая модель возглавила лидерборд живых людей). Про дизайн читал до этого статью интересную, как топовые модели сейчас стараются в более лучший дизайн.
И я не вижу вообще как тут можно говорить, что это просто "дистилляция fable".
Ну и здорово, что поделились вообще всем, как что работает, как дообучали, как песочницы делали, какие библиотеки использовали. То есть повторить и улучшить сможет любая лаборатория. Вау!
Но у себя дома стойку под 2.8T, правда, всё ещё надо иметь :)
https://github.com/MoonshotAI/Kimi-K3/blob/main/k3_tech_report.pdf
О, как раз свежий Opus 5
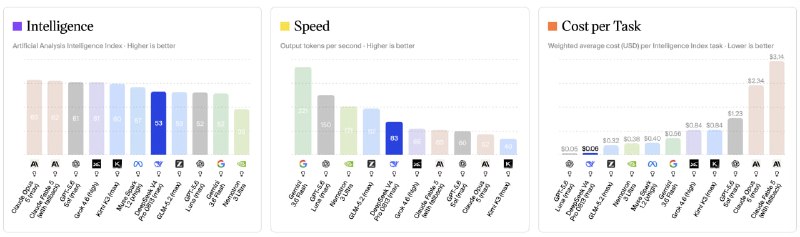
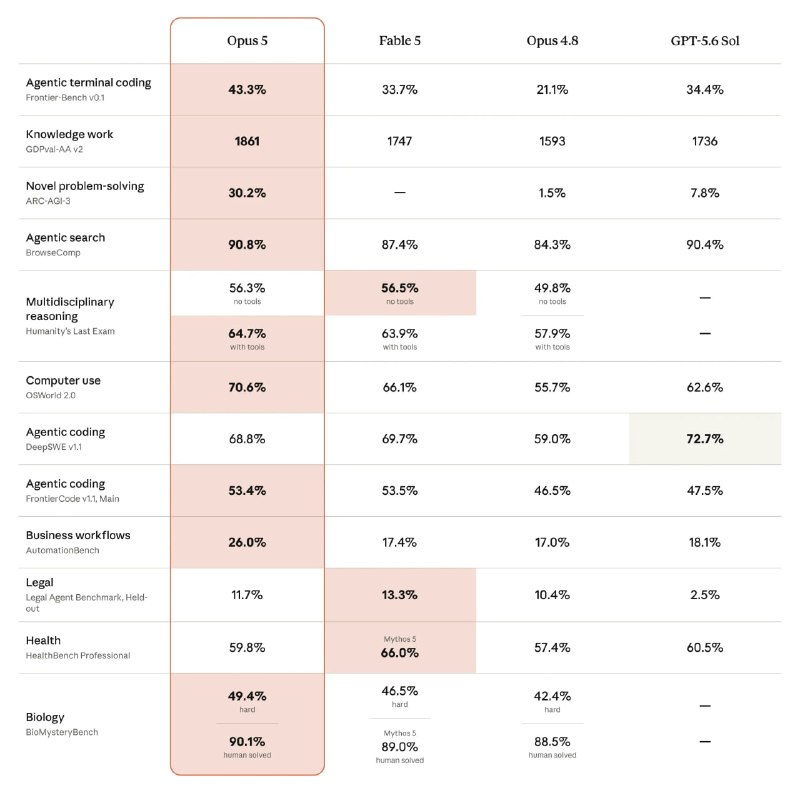
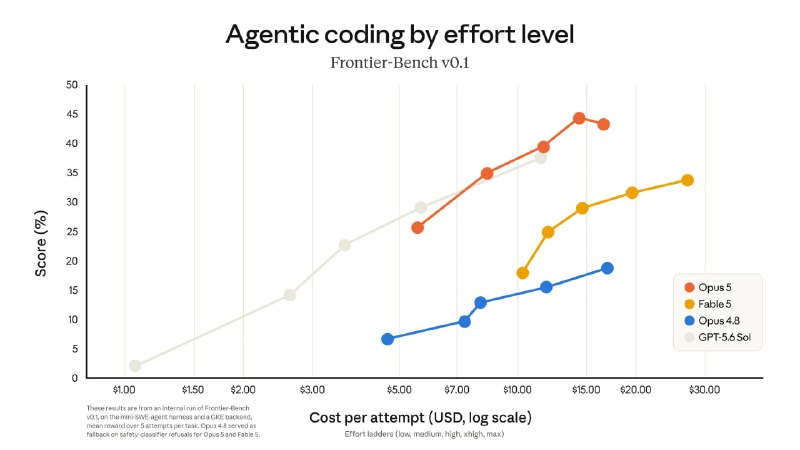
По бенчмаркам лучше аж Fable, что конечно же хорошо, потому что не будет свистопляски с тем, что включено в тариф (кажется, они просто слили fable теперь), и стоит в 2 раза дешевле, но смотрю я на их же детальных графиках по интеллекту за цену и как-то все на уровне или даже чуть хуже и дороже GPT-5.6 Sol.... И Fable смотрится вообще плоховато... Или чего-то не догоняю?
https://www.anthropic.com/news/claude-opus-5