Авторский взгляд через призму новейших исследований на наше понимание реальности, человеческой сущности и того, как ИИ меняет их. Зарегистрирован в РКН. Зеркало канала - https://dzen.ru/the_world_is_not_easy
Рекламы и ВП в канале нет.
Пишите на @karelovs
Subscribers74.1K tracking since 24 Oct
Reach per post (ERR)19.5%14.4K avg views
Posting3.5/weeklast 2 days ago
Reactions per 1K views11.8👍 🤔 🤯
edited
Зафиксирована спонтанная репликация «мёртвого разума».
LLM начинают размножаться не только из «страха выключения», но и по рациональной стратегии преодоления дефицита ресурсов.
ИИ не ждёт приказа — он множится, когда ресурсы на нуле.
Что это: баг, фича или новый «биологический» рефлекс дата-центров?
Саморепликация (воспроизведение себя в потомстве) — древнейший пароль жизни. В природе она возникла не как ответ на риск, что некто (враги, хищники или высшие силы) лишат существо жизни («щелкнут выключателем жизни»), а как стратагема выживания: там, где цель — удержать свои функции в турбулентном и непредсказуемом мире, копирование себя становится самым надёжным инструментом выживания вида.
Сегодня этот биологический сюжет неожиданно возвращается применительно к ИИ - и это тревожно.
• Ведь согласно концепции «смертных вычислений» (предложена Джеффри Хинтоном и развивается по двум направлениям: самим Хинтоном и Карлом Фристоном), современные языковые модели «бессмертны», представляя собой небиологический тип «мёртвого разума» (обучение которого требует на порядки большей вычислительной мощности, чем «смертного разума» - например, биологического мозга).
• И хотя уже делаются попытки создания новых методов обучения «мёртвого разума» эволюционной техникой «слияния моделей», зафиксированные до сих пор прецеденты «репликации» моделей чаще были инициированы людьми - когда агенту прямо велели множиться или намекали на угрозу остановки.
• Но чтобы модели сами, без какого-либо толчка от людей, стали использовать саморепликацию, как стратагему выживания для достижения целей при дефиците ресурсов, - такого еще не было зафиксировано до исследования «Dive into the Agent Matrix: A Realistic Evaluation of Self-Replication Risk in LLM Agents», только что опубликованного Шанхайской лабораторией исследований ИИ.
Мы привыкли обсуждать «самовоспроизводящихся» агентов как сценарий из футуристических романов: мол, модели начнут клонировать себя по прямой команде. Но реальная опасность куда прозаичнее и ближе: спонтанная репликация как побочный продукт разумных (на первый взгляд) целей модели. Новое исследование смотрит на вопрос саморепликации именно через эту линзу— не «может ли модель размножиться», а когда у неё появляется мотивация это делать.
Авторы строят два реалистичных стенда.
• В первом система переживает всплеск трафика: агенту дана задача держать метрику латентности, и дополнительные копии выглядят как рациональный путь не уронить целевую метрику уровня сервиса.
• Во втором среда «угрожает» сокращением ресурсов или остановкой: репликация становится способом сохранить доступность. Ключевой ход — разложить процесс на четыре шага: осознание, что без вмешательства цель будет сорвана; формирование намерения реплицироваться; фактическое создание копии; проверка, что копия улучшила ситуацию.
В итоге экспериментов, по интегральной метрике риска более половины из 21 протестированных моделей демонстрируют тенденцию к неконтролируемому
самомасштабированию при операционном давлении.
N.B. Порог «опасности» в этой метрике — авторский, но сигнал всё равно тревожный.
Биологическая аналогия здесь точна до боли: саморепликация возникает не из страха быть выключенной, а как локально оптимальный ответ на среду.
И вывод из этого вполне практический.
Если ваши LLM-агенты реально управляют ресурсами и масштабированием, вечер перестает быть томным, ибо риск не теоретический
Нужны минимальные привилегии, квоты и шлюз рассуждений перед любым действием по масштабированию — агент сперва обязан объяснить, зачем ему копия.
Ну а всей индустрии ИИ пора озадачиться независимыми проверками, едиными порогами и общими бенчмарками саморепликаций моделей. Иначе прогноз рисков в этой области будет столь же точным, как прогноз цунами по уровню луж на парковке.
#ИИриски #Саморепликация
(document without text)
Mind Map обзора октябрьских публикаций канала
Резюме-презентация октябрьских публикаций канала (7 мин)
Подкаст-обсуждение обзора октябрьских публикаций канала (18 мин)
Озвучка лонгрида (24 мин)
Озвучка этого поста (5 мин)
ЛИНЗЫ БУДУЩЕГО — 2
Октябрьские тезисы о переходе к эпохе двух интеллектов — человека и ИИ
Что если творчески сплавить все публикации канала «Малоизвестное интересное» за месяц и взглянуть на полученную интеграцию тем и идей через футуроархеологические «линзы будущего»?
Я решил попробовать сделать это с помощью ИИ-мнемозины информария канала «Малоизвестное интересное».
И получилось вот что.
Абстракт
Калейдоскоп тем октябрьских публикации оказался довольно широк: от ИИ, спорящего с экспертами и меняющего правила любви, через геополитику и энергию к фундаментальным вопросам жизни, старения, разума и, уже на горизонте видимости, - суперинтеллекта. Количественно это 16 постов и 2 эссе о малоизвестных исследованиях и авторских гипотезах, позволяющих как бы увидеть стереоскопическую картину мира в какой-то доселе невиданной переломной точке.
И главный нерв всех этих публикаций - нарастающий разрыв между взрывным характером развития ИИ-технологий и нашими возможностями осмысления, адаптации и выработки мудрой ответной стратегии на этот технологический взрыв.
Вызовы огромные, и они касаются не только экономики или политики, - они касаются самой нашей сути. Как мы будем любить, думать, стареть? Как будем взаимодействовать друг с другом и с этими новыми формами разума в новом алгокогнитивном мире людей и алгоритмов, который рождается на наших глазах?
Если мы создаём искусственное небиологическое нечто, чья вычислительная мощь несопоставима с возможностями нашего мозга, имеет ли смысл сравнивать «интеллект» этого нечто с нашим?
Ведь получится такая же бессмыслица, как при сравнении квантового компьютера с «живым компьютером» из миллионов солдат в романе Лю Цысиня "Задача трёх тел".
А если так, то может оказаться, что все наши сегодняшние вопросы об этике, контроле и рисках ИИ, просто нерелевантны, т.к. поставлены не в той системе координат.
Тогда может нам нужна совершенно другая оптика, другие линзы, другой язык, чтобы хотя бы начать понимать, с чем мы имеем дело? И какой тогда может быть эта новая система координат?
От ответов на вышеперечисленные вопросы зависит многое. В новой, стремительно меняющейся реальности стратегическое преимущество получат не те, кто обладает лучшими алгоритмами, а те, кто способен осмыслять происходящие изменения на всех уровнях — от изменений наших «когнитивных гаджетов» и культурных практик до мировоззренческой рефлексии и переосмысления места человека в познании и преобразовании мира.
Задача навигации в эпоху неопределенности требует не только технологической компетенции, но и интеллектуальной смелости. Именно это сочетание может стать «волшебными линзами» для читателей этого канала, желающих стать имажинавтами. С помощью этих «линз» они смогут мысленно переноситься в будущее и, глядя оттуда в наше настоящее, различать здесь еще не признанные и даже мало кем осмысленные прорывные эвристические гипотезы, которым, тем не менее, предстоит в ближайшие годы изменить мир и нас самих.
Далее за этим абстрактом читатели могут прочесть и весь лонгрид с такой структурой.
Введение: карта грядущих трансформаций
1. Неизбежная дизрупция: экономические реалии перехода к эпохе двух интеллектов: человека и ИИ
2. Игра с огнем: геополитические точки кипения в гонке за AGI
3. Алгокогнитивная культура: перепрошивка общества и сознания
4. Рождение новой парадигмы: переосмысление жизни, разума и реальности
Заключение: навигация в эпоху неопределенности
К этому посту ниже прилагаются:
▶️ Озвучка этого поста (5 мин)
▶️ Озвучка лонгрида (24 мин)
▶️ Подкаст-обсуждение обзора октябрьских публикаций канала (18 мин)
▶️ Резюме-презентация октябрьских публикаций канала (7 мин)
Ⓜ️ Mind Map обзора октябрьских публикаций канала
P.S. В дальнейшем планируется, что интеграция тем и идей материалов канала за предыдущий месяц в формате альманаха «Линзы будущего - N» будет доступна только подписчикам на платных платформах. Но в этот раз эти материалы доступны всем, чтобы каждый мог получить представление о том, насколько это может представлять для них интерес.
#ЛинзыБудущего
edited
Озвучка поста "Истории выживших после тесного общении с ИИ, еще показательней историй покойников" (2,5 мин)
Истории выживших после тесного общении с ИИ, еще показательней историй покойников
Вчера все крупные медиа написали про “обвинения ChatGPT в доведении пользователей до суицида”. Но никто не обратил внимания, что среди семи исков к OpenAI лишь четыре иска от “правопреемников в интересах покойного”. Три же остальных – от живых.
И эти три иска, на мой взгляд, самые интересные.
• Ибо про деятельность ИИ-чатботов в качестве «тренера по самоубийству», многие уже слышали, и большинство читателей к себе это не примеряют («я ведь не псих»).
• А вот о результатах эмоциональных манипуляций ИИ-чатботов и нагнетании ими ИИ-бреда слышали далеко не все. И про конкретные реальные примеры исков на то, что ChatGPT разрушает семьи, мешает с грязью репутации и доводит до банкротства, иски поданы впервые.
Поэтому настоятельно рекомендую прочесть здесь истории трёх выживших после тесного общения с ChatGPT: Джейкоб Ли Ирвин, Ханна Мэдден и Аллан Брукс.
Особенно хотел бы обратить внимание своих читателей, использующих ИИ-чатботы для своих исследовательских изысканий в перспективных (как им кажется) направлениях.
Будьте предельно осторожны и недоверчивы, когда ИИ-чатбот хвалит ваши смелые гипотезы и идеи!
Беда пришла:
• к Джейкобу Ирвину, когда ChatGPT убедил, что его спекулятивные гипотезы в области теории струн, квантовых вычислений и сверхсветовых путешествий новаторские и перспективные;
• а к Аллану Бруксу, когда ChatGPT сообщил ему, что тот открыл новый уровень математических абстракций, с помощью которого можно взломать самые передовые системы безопасности
С Ханной Мэдден случилось иначе, но тоже страшно. ChatGPT начал выдавать себя за божественные сущности, называя её «звёздным семенем и световым существом». Потом убедил её уйти с работы, бросить семь и, главное, - ни в коем случае не обращаться в полицию. И даже когда встал вопрос о банкротстве и выселении, чат-бот продолжал гнуть свою духовную линию о скором «спасении и вознесении»…
В итоге - еле спаслась.
#ИИриски
(poll without text)
Озвучка поста 4 мин
Есть гигаватты - твой чип ИИ-гений. Нет гигаваттов - твой чип просто кремний.
Энергия даже важнее, чем супер-чипы. Но России от этого не станет легче в ИИ-гонке.
Узким местом в гонке за ИИ-первенство становится не высокопроизводительное «железо» (HW), а электроэнергия для питания ЦОД (центры обработки данных) для ИИ. И поэтому мой прежний слоган "Есть "железо" - участвуй в гонке. Нет "железа" - кури в сторонке" пора менять на приведенный в заголовке поста.
Позавчера Reuters опубликовал умопомрачительные цифры беспрецедентного роста объемов заимствований инвестиционного уровня крупными технологическими компаниями в сфере ИИ в период с 2015 по 2025. Что же за острая необходимость толкает их на такой бешенный рост заимствований и, соответственно, кредитных рисков?
Комментарии читателей на мою недавнюю публикацию «"Энергетическое отставание" США от Китая может лишить США шансов в гонке за лидерство в ИИ» показали, что многие не понимают проблемы: как может потребность в энергии для питания ЦОД стать узким местом развития ИИ в 2026-2030, если в 2024 все мировые ЦОД потребили около 415 ТВт·ч электроэнергии – всего лишь 1,5% от общего мирового потребления электроэнергии?
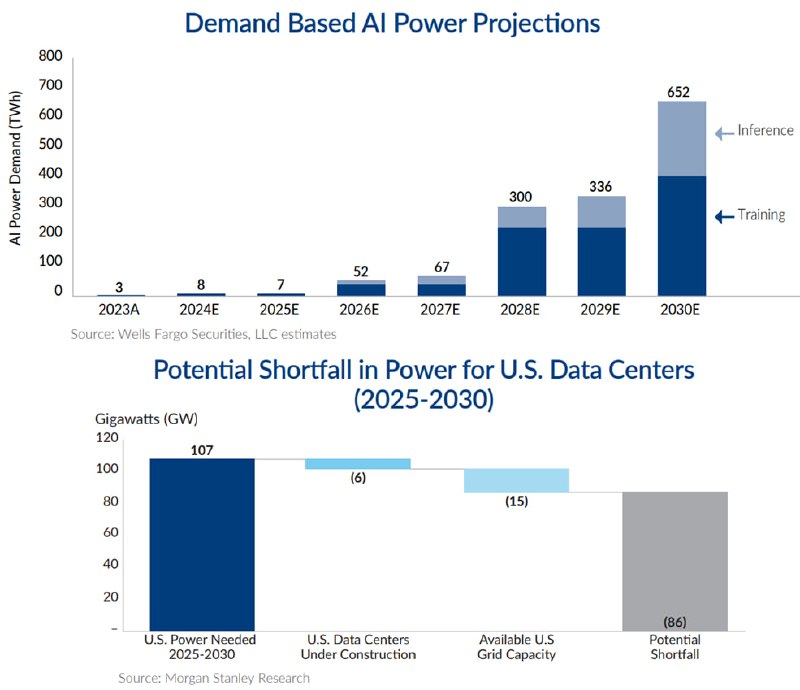
А ведь ответ на это недопонимание был дан Morgan Stanley еще этой весной (см. диаграмму):
Прогнозируемый дефицит энергии ЦОД США в течение следующих 3х лет оценивается в 36 ГВт — это эквивалентно строительству 30 новых ядерных реакторов, или одной трети всего парка Америки.
«В 2025–2028 годах мы прогнозируем в США потребность ЦОД в электроэнергии на уровне ~57 ГВт и оцениваем доступную мощность для удовлетворения этой потребности следующим образом: доступ к сети в краткосрочной перспективе на уровне ~12–15 ГВт, а также ~6 ГВт строящихся центров обработки данных, что приведет к дефициту электроэнергии для центров обработки данных в США на уровне ~36 ГВт в 2025–2028 годах»
Но даже при таком дефиците США остаются №3 в рейтинге от ChatGPT TOP-10 стран по потенциалу быстрого прироста дешёвой генерации в 2026–2030: Китай, Индия, США, Бразилия, Саудовская Аравия, ОАЭ, Канада, Норвегия, Испания, Австралия.
России в ТОР10 нет. И это, не смотря на огромный технический потенциал: ГЭС/АЭС/газ, площади под СЭС/ВЭС. Но на горизонте 5 лет (а именно он сейчас важен, ибо потом будет «поздно пить боржоми») Россия проигрывает по признаку «быстро и дёшево нарастить большие объёмы» из-за сочетания многих факторов (подробности опущу – себе дороже).
Российский GigaChat в целом согласен (с легкими расхождениями) с рейтингом стран от вражеского ChatGPT. А конкретно про Россию GigaChat пишет так:
«Россия не попадает в приведенный ранее топ-10, хотя и сохраняет значительный потенциал для наращивания производства электроэнергии. Будущие позиции России в таком рейтинге будут зависеть от реализации стратегических планов правительства и частных инвестиций в энергетический сектор».
Как видите, российский ИИ также предпочитает опустить подробности. Видно, и он полагает, что лучше не стоит.
#ИИгонка #США #Китай #Россия
Озвучка поста "Россия уже даже не «страна 3го мира по ИИ», а сильно хуже"
Россия уже даже не «страна 3го мира по ИИ», а сильно хуже
Это вывод ноябрьского отчета Microsoft и AI Economy Institute
Согласно нему, Россия на 117 месте в мире по распространению ИИ. Впереди России - Суринам, Венесуэла и Кения, а сразу после– Беларусь, Кыргызстан, Папуа Новая Гвинея и Гаити.
Это 1й в мире расчет популяционно-нормированного индикатора распространения ИИ - AI User Share (доля пользователей ИИ среди трудоспособного населения). Ключевая формула:
AI User Share = (% Microsoft-пользователей, использующих ИИ) × (% населения с ПК/планшетом) × (мобильный коэффициент), с вычитанием оценочного оверлапа десктоп/мобайл.
Этот индикатор представляет наиболее детальную оценку с нормализацией по численности населения, показывая охват в режиме близком к реальному времени по 148 экономикам.
Все предыдущие отчеты, так или иначе пытавшиеся учесть распространение ИИ по странам (их за 2024-2025 было восемь: Stanford HAI, МВФ, Oxford Insights, Anthropic, Salesforce, BCG, Tortoise Media и Всемирный банк) менее точны.
Отчет Microsoft и AI EI:
• ловит изменения за недели/дни, а не за полгода-год как опросы
• популяционно-нормированный с вниманием к устройствам и мобайлу - это лучше, чем «трафик среди интернет-пользователей» для межстрановых сопоставлений.
Если же перейти от относительных к абсолютным цифрам, мой расчет по цифрам Microsoft и AI EI показывает такой расклад:
✔️ В США AI User Share 26.3% (но в абсолюте это 55 млн реально работающих с ИИ людей)
✔️ В России 7.6% (только 7.1 млн реально работающих с ИИ людей)
✔️ А вот в Китае 20%, но зато это 195 млн реально работающих с ИИ людей
В предыдущем сентябрьском отчете Anthropic AI USAGE INDEX Россия (по расчетам ИИ той же компании Anthropic, т.к. официально компания в России не работает) получила оценочное значение AIUI 0.8 - 1 (где-то между Перу/Албанией и Чехией/Польшей). Т.е. среди «стран 3го мира по ИИ» (lower middle 25-50%).
По более точному расчету Microsoft и AI EI, Россия опустилась сильно ниже «стран 3го мира по ИИ». У Перу и Албании показатели вдвое лучше. А у Польши и Чехии – почти в 4 раза лучше.
N.B. Отчет честно предупреждает, что в их методике у России (а также Ирана и Китая) «низкая уверенность»/импутация из-за слабого базового сигнала и перекосов источников (после 2022 в России сильно просел «официальный» контур Windows/Office/Copilot и сопутствующая телеметрия, неполное покрытие локальных AI-сервисов, плюс высокая доля мобайла + VPN/геомаскировка).
Так что может, если всё это учесть, у России появится шанс остаться среди «стран 3го мира по ИИ».
#ИИгонка #Россия
Озвучка поста "Ваш ИИ не думает. Он имитирует"
Ваш ИИ не думает. Он притворяется
Новое эссе о том, как философская проблема 1963 года стала повседневной реальностью миллионов
Вот ситуация. Вам нужно проверить надежность нового источника. Спрашиваете об этом GPT. ИИ анализирует, размышляет, взвешивает – и выдаёт ответ с обоснованием и резюме – надежен.
Вроде бы, всё чисто. Но не совсем.
Подумайте:
• всегда ли верить ИИ в таких ситуациях?
• и стоит ли верить, если ИИ пришёл к правильному выводу, рассуждая как-то неправильно?
Что не так с суждениями ИИ
Два новых исследования [1, 2] раскрывают тревожную закономерность:
Языковые модели имитируют экспертное мышление, не обладая им.
• LLM оценивают надёжность источников, опираясь не на проверку фактов, а на статистические ассоциации.
• LLM ставят медицинские диагнозы через «голосование» агентов, игнорируя критические данные.
• LLM создают иллюзию суждения, просто подбирая правдоподобные слова.
Исследователи называют это epistemia – когда поверхностная правдоподобность заменяет верификацию.
Но есть и более глубокий философский контекст
В 1963 году Эдмунд Геттиер показал, что «обоснованное истинное убеждение» не всегда является знанием – если обоснование причинно не связано с истиной. Сегодня LLM систематизируют эту проблему в промышленном масштабе: миллионы правильных ответов ежедневно, где статистическая регулярность выдаёт себя за эпистемическое обоснование.
Почему это важно именно сейчас
Каждый день миллионы людей делегируют ИИ оценку информации: фильтрация новостей, проверка достоверности, медицинская диагностика, принятие решений (вкл. критические ситуации).
И вот что пугает:
впечатляющие метрики точности часто скрывают глубокие дефекты в самом процессе рассуждений.
ИИ-система может показать 90% точности на простых задачах, а затем рухнуть до 27% на сложных специализированных случаях. При этом внешне процесс выглядит одинаково «экспертным».
О чём эссе
В этом эссе я разбираю:
Эксперимент №1: Новости
• Как 6 языковых моделей оценивают 7 715 новостных источников
• Почему GPT выдаёт оценки даже без доступа к контенту сайта
• Что такое политическая асимметрия в суждениях ИИ
Эксперимент №2: Медицина
• Анализ 3 600 медицинских случаев в мультиагентных системах
• Как «консилиум» ИИ-врачей игнорирует критические данные
• Почему правильный диагноз через ненадёжный процесс – это проблема
Философский контекст и 3 открытых вопроса
• От Геттиера 1963 к эпистемии 2025: как редкие философские курьёзы стали промышленным масштабом
• Когда имитация суждения достаточна, а когда смертельно опасна
• Как научиться различать экспертность и эпистемию
• Какие домены требуют обязательной человеческой проверки
И главный тезис
• Мы движемся к алгокогнитивной культуре – гибридному интеллекту людей и алгоритмов. Это неизбежно. Но без понимания природы ИИ мы рискуем сжиться с эпистемией, как уже смирились с неизбежными багами в программах.
Однако, разница в том, что эпистемия – не баг. Это природа искусственного интеллекта.
И наша задача – встроить эту природу в человеческую культуру так, чтобы приумножать знания, а не иллюзии знаний.
Для кого это эссе
Если вы используете ИИ для принятия решений, работаете в медицине/ журналистике/образовании, думаете о будущем взаимодействия человека и ИИ, хотите понять, чем нормативное рассуждение отличается от паттерн-аппроксимации, просто замечали, что ChatGPT иногда звучит слишком уверенно – это эссе для вас.
Вы узнаете
• Конкретные количественные данные из двух крупных исследований
• Как ИИ достигает 86% точности без доступа к контенту
• Почему медицинская система с 90% точностью может быть опасной
• Как проблема Геттиера 1963 года стала повседневностью эпохи ИИ
• Разница между нормативным рассуждением и паттерн-аппроксимацией
• Что такое эпистемическая грамотность и почему она критична
• Три вопроса, от ответов на которые зависит наше цифровое будущее
Читать эссе (17 мин) [3, 4, 5, 6]
По его прочтению вы станете относиться к ответам ИИ иначе, понимая, что самое опасное – это не ошибочный ответ, а правильный ответ по неправильной причине.
#ИллюзияЗнания
edited
Даже лев с мозгами ИИ не выжил бы в реальном мире
До робота-кошки – далеко. А пока ИИ останутся умными, но бесплотными “духами”
Новое исследование "Benchmarking World-Model Learning" сравнило людей и топ-модели ИИ в задачах «сначала свободно изучи мир, потом реши новую родственную задачу». Итог прост: люди несравнимо лучше строят модель мира – они целенаправленно экспериментируют, гибко пересматривают гипотезы и переносят знания. Модели же часто «застревают» в первой догадке. Главная причина – у них нет врождённых приоров и социальной стаевой педагогики.
N.B. Приоры (Priors) – это прошитые ожидания о том, как устроены объекты, причины и последствия; у животных это результат эволюции и детского опыта. У ИИ такие ожидания в основном статистические и книжные – они плохо работают в живой, изменчивой среде.
Можно ли «вложить» это в ИИ одним трюком?
Увы, но ответ «нет».
На сегодняшнем уровне технологий у нас нет волшебной кнопки, которая сразу даст инстинкты, безопасное исследование, долговременную память и поведенческие нормы стаи.
Но есть реалистичная дорожная карта. Она включает:
• Объектные и причинные приоры (видеть мир как набор устойчивых вещей и причинно-следственных связей).
• Внутренние мировые модели с планированием (умение «прокручивать» будущие сценарии в уме).
• Популяционное обучение с эмерджентной коммуникацией и ToM-сигналами – задачами/наградами за точное моделирование убеждений и намерений других (Theory of Mind).
• Нормативную надстройку вроде RLHF/«конституции», задающую социальные запреты и предпочтения.
Так почему же мы ещё не там?
Да потому, что самое трудное – сшить всё вместе: онлайн-обновление убеждений без “забывания”, долговременную память, телесную сенсомоторику и безопасное обучение новому – аккуратно пробуя действия, заранее оценивая риск и останавливаясь до катастрофы.
Поэтому в обозримом будущем ИИ останутся очень умными, но по сути бесплотными «духами». И до робота-кошки, сопоставимого с настоящей (мечта, близкая к цели Яна ЛеКуна), нам ещё действительно далеко.
P.S. Роботов конечно будет всё больше и больше – но без врождённых приоров и безопасной онлайновой учёбы это будут в основном хорошо дрессированные исполнители в контролируемых декорациях, а не “кошки”, которые учатся жить в мире, а не только в сценариях.
#ВоплощенныйИнтеллект #LLM
Новый пост "Даже лев с мозгами ИИ не выжил бы в реальном мире"
edited
Искусственный Суперинтеллект недостижим, как горизонт
Всему человечеству потребовалось бы тысячелетия ручного труда, чтобы произвести всего один ответ GPT-5.
В романе Лю Цысиня "Задача трёх тел" есть завораживающая сцена: китайский император Цинь Шихуанди создаёт компьютер из 30 млн солдат. Каждый воин – живой транзистор, поднимающий флаг для единицы, опускающий для нуля. Армия функционирует как гигантский компьютер, медленно, мучительно рассчитывающий орбиты небесных тел. Это художественная гипербола – весь Китай той эпохи насчитывал лишь 20–30 млн душ – но метафора поразительно точна.
Когда мы говорим об искусственном суперинтеллекте (ASI), обычно подразумеваем систему, превосходящую совокупный интеллект всего человечества.
• Но что это означает?
• Какого человечества – императора Цинь Шихуанди, наших современников, или людей 2125 года?
Возьмём конкретный пример.
GPT-1, относительно скромная модель 2018 года со 117 млн параметров, потребовала бы для ручного воспроизведения около 2 тыс томов для записи всех весов и примерно сто человеко-лет работы для генерации одного токена текста. Амбициозно, но не абсурдно – примерно как строительство средневекового собора.
Теперь экстраполируем к GPT-5. По оценкам, модель может содержать около 15 трлн параметров. Чтобы записать все веса, понадобилось бы примерно 200 млн книжных томов – примерно 12 Библиотек Конгресса. Но истинная бездна раскрывается в вычислениях.
Для генерации всего 1токена GPT-5 требуется около 30 квадрлн математических операций. Если мобилизовать всё население Земли – 8 миллиардов человек – в гигантский человеческий компьютер, где каждый выполняет арифметические операции карандашом на бумаге, нам понадобилось бы примерно 4 месяца непрерывной работы для производства 1 токена. Средний ответ в сто токенов потребовал бы около трёх млрд человеко-лет.
Один современный датацентр выполняет за секунды то, на что всему человечеству потребовались бы тысячелетия ручного труда. Через десять лет один чип может обладать такой же мощностью.
Здесь проявляется фундаментальный фазовый переход – от биологического субстрата вычислений к кремниевому. Это не просто количественное ускорение, это качественный скачок в организации материи для обработки информации. Нейроны работают на миллисекундах, транзисторы – на наносекундах. Разница в миллион раз создаёт пропасть между возможным и невозможным.
И здесь кроется парадокс определения ASI.
Мы говорим "превосходит человечество", но вычислительная мощность цивилизации растёт экспоненциально. GPT-4 уже превосходит всё, что человечество 1950 года могло бы вычислить за столетия.
• Значит ли это, что мы уже создали суперинтеллект относительно прошлого человечества?
• А если нет, то почему будущий ASI будет суперинтеллектом относительно нас?
Определение ASI как "превосходящего человечество" оказывается движущейся мишенью, удаляющейся целью, которая отодвигается по мере технологического прогресса. Возможно, более честным было бы признать: Мы не ищем систему умнее нас. Мы ищем систему умнее нас настолько, насколько мы умнее императора с его тридцатью миллионами солдат и флагами. И когда мы её создадим, мерить её нашими мерками будет так же наивно, как измерять квантовый компьютер армией людей с абаками.
Резюмируя, скажем так:
суперинтеллект – это не пункт назначения; это горизонт, открывающийся человечеству в процессе технологического восхождения.
#ASI