Канал SeeAll'а с новостями (и мыслями о них) из мира NLP, VR и космоса.
Более подробно смотри в первом сообщении в канале (оно закреплено). А еще у нас есть чат! Заходи: https://t.me/+i_XzLucdtRJlYWUy
Subscribers80.7K tracking since 23 Oct
Reach per post (ERR)39.0%31.5K avg views
Posting1.3/daylast 2 days ago
Reactions per 1K views9.8👍 🔥 🤡
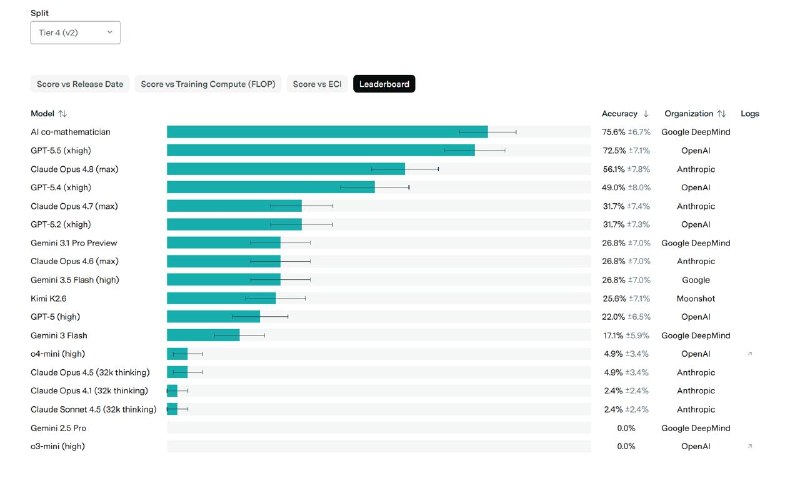
Наконец-то авторы FrontierMath прочесали ответы для задач, исправили ошибки, выкинули часть проблем и пересчитали оценки. Скачок получился... большим 😕
Большая часть ошибок — это потеря знака (плюс на минус и наоборот) в вычислениях людей и/или переносе решения в код для проверки, а также ошибка на +-1. Humans, what to say — большую часть ошибок помогла найти GPT-5.5
На первой картинке изменения в оценках для моделей GPT в tier 1-3 (полегче) и tier 4 (посложнее). На второй — абсолютный топ tier-4. Раньше каждая решённая задача в tier 4 сопровождалась комментариями от математика, принимавшего участие в её составлении; они писали, мол, я сам-то не сразу догадался, а модель вот нашла способ и придумала и вообще круто что такую сложную задачу берёт!
...а теперь оказалось, что зарешано 76% задач 😇 пу-пу-пу, только на FrontierMath Open Problems и надеемся
UPD: Fable занял топ-1 на Tier-4 с 88%, всё, бенчмарк можно закрывать...
edited
До выхода Opus 4.5 многие сидели на Sonnet 4.5 — он казался достаточно умным, и в то же время его можно было использовать по подписке гораздо больше, чем Opus, который с выходом 4.5 подешевел в 3 раза. Так что звёзды сложились так, что почти все переехали на «тяжелый дорогой» Opus.
Но для сравнения и перспективы:
— Opus 4.8 стоит $5/$25
— Fable 5 в два раза дороже, $10/$50
— Opus 4 / 4.1 стоили $15/$75, дороже Mythos-class моделей!
— GPT-4 на релизе стоила $30/$60, и целых $60/$120 если контекст длиннее невероятных 8 тысяч токенов
— GPT-3 стоила $40 (и $80 если вы покупали пакет токенов поменьше) и не разделяла вход и выход, так что $40/$40
И это не говоря про то, что за входные токены мы зачастую платим с большой скидкой в 50-90%, так как они кэшируются.
GPT-3 стоила дороже Opus 4.8 и почти наверняка дороже Fable 5 в реалистичных сценариях.
И вот мы на пороге потенциальной ценовой войны Anthropic <-> OpenAI, и, возможно, через год мы будем иметь Mythos-class модели по цене Sonnet-ов или чуть дороже. Невероятно.
(ноооооо если спрос продолжит расти, то придётся снова задирать цены, так как не смогут обслуживать всех 😦)
edited
Нажал на кнопку — вывел компанию на биржу — стал триллионером. Вот так просто 😀
edited
Две новости в одной:
— Anthropic откатили обратно «скрытое» ухудшение ответов Fable, если запрос касался потенциальной разработки конкурирующих технологий / фронтир LLM. Теперь вместо этого будет явный отказ (как и по другим отфильтрованным темам) и откат на Opus 4.8. В API будут писать конкретную причину.
— OpenAI «рассматривает возможность резкого снижения цен, опасаясь войны за пользователей с Anthropic». В новости написано, что они могут пойти на этот шаг потому, что Anthropic рассматривает точно такую же стратегию, и их можно опередить. Если Anthropic промедлит, то OpenAI может отжать часть клиентов и выручки, особенно энтерпрайз.
edited
8 лет назад тоже казалось нереальным запустить Starlink: нужно было уж очень много запусков, а ракеты ещё не были настолько многоразовыми.
Но оказалось, что Falcon 9 может быть запущеным и сесть на площадку ТРИДЦАТЬ МАТЬ ЕГО ПЯТЬ РАЗ (накануне рекорд поставили) — я помню, как в какой-то момент лицензию расширяли до 15 и это казалось «вау», мол, как так, целых 15 раз одна ракета может сесть???
Сейчас на орбите около 14 тысяч спутников, из которых.... десять тысяч — Starlink (мне очень нравится, как группировку спутников называют «constellation», созвездие).
Датацентры в космосе, по аналогии, тоже не выглядят здравой идеей. Нужно столько пусков! Это дорого! Сейчас — да, но Elon, очевидно, ставит на развитие — как и Google, как и Amazon, которые анонсировали схожие проекты.
Спросил у GPT-5.5 Pro сколько спутников влезет в Starship v3 и будущий v4 с учётом орбиты, на которую будут запускать AI-1. Оценки разнятся, и выглядит так, что может упереться даже не в массу, а в объем отсека для спутников.
Один v3 сможет вывести реалистично 35-40 спутников (оптимистично — 50, на чуть другую орбиту, которая тоже была в заявке, поданной SpaceX для резервации части космоса). v4 — ровно в 2 раза больше, если влезет (но и корабль там планируют удлиннить).
40 спутников — это 40 стоек с 72 очень мощными видеокартами за один пуск, или 2880 запущенных GPU. По мощности получается одна двухсотая ГигаВатта, то есть нужно 200 пусков (или 100 v4), чтобы собрать приблизительно столько же мощностей, сколько в 1 очень крупном датацентре, состоящем из нескольких корпусов. Много? да. Но это похоже на то, под что затачивались Starship — помню, что планировалось по 100 пусков каждого корабля, а там кто знает, на сколько расширят лицензию 😇
edited
Google выложили DiffusionGemma — модель на 26B параметров с 4B активных, с архитектурой Gemma 4, и которая генерирует по 256 токенов за раз. Но так как получается неразбериха, то эти токены перегенерируются несколько раз.
То есть это работает так же, как пошаговая генерация картинки, где каждая последующая генерация «выравнивает», что уже было нарисовано (или в данном случае написано). Гифка с примером генерации — выше этого поста.
На картинке в этом посте метрики и скорость (самый левый столбик) — на одной H100 в FP8 модель развивает более 1000 токенов в секунду, по сравнению с 303 для Gemma 4 с MTP (предсказание нескольких токенов за раз). Обещают 700 токенов на 5090.
DiffusionGemma послабее четверки, это превью технологии, и я вообще удивлён, что это ещё и рассуждающая модель — да-да!
Веса тут, визуальный гайд с объяснением принципа работы тут; модель поддержана уже везде, VLLM, Unsloth итд — можно загружать и играться. А вот тут можно погенерировать код с этой моделью бесплатно (и смотреть, как на лету делаются правки).
Гифка для следующего поста, так как Пашка-пушка не придумал, как отправить и картинку, и гифку вместе.
В контексте выхода более дорогой, но способной Fable, которая даже в подписку входить не будет после 22-го июня, интересен вопрос: как будет расти выручка Anthropic дальше?
С одной стороны компании урезают или корректируют бюджеты на траты: уж слишком кусается цена, если платить по API-прайсу, а не как подписка с фиксированной ценой. Часть клиентов если не уйдет, то точно негативно повлияет на выручку.
С другой стороны, на место старых неудовлетворённых клиентов могут приходить новые и частично компенсировать это влияение на выручку.
Ну а с третьей — модели становятся дороже, но их всё равно кто-то да будет использовать. Mythos пока был за закрытыми дверями и использовался для анализа кода на предмет уязвимостей был платным. Хоть сама история со сканированием кода разовая, круг компаний расширяется, плюс условно раз в полгода будет выходить модель сильно лучше, так что имеет смысл прогонять весь код на предмет уязвимостей снова (или не весь, а только самые критичные части).
Более того более способные модели будут браться за более аммбициозные задачи и работать дольше, тем самым поднимая выручку.
Так что будет с выручкой? Застынет на месте и будет колебаться на этом же уровне до конца года? Продолжит расти бешеными темпами? Начнёт падать? Или покажет лишь умеренный рост?
У меня нет понимания, так как мы не имеем знаний о структуре выручки Anthropic, и какая доля на сколько компаний какого размера приходится. Я не думаю, что выручка упадёт — в худшем случае весь отток будет компенсироваться остальными тремя пунктами. С другой стороны продолжения взрывного роста, как это было в этом квартале, тоже пока не ожидаю.
Будем вести наблюдение и очень ждём публикации документов для IPO!
What did they mean by this
edited
С релизом Fable 5 Anthropic добавили 2 новых меры предосторожности.
Первая простая и понятная: некоторые запросы будут направляться в Opus, если они кажутся системе какими-то странными. Сюда входят вопросы по биологии, кибербезопасности, химии или дистилляция моделей. Вы будете уведомлены, что отвечает другая модель.
А вот вторая — очень жесткая. Если системе покажется, что вы используете её для «запросов, нацеленных на разработку передовых LLM» — вы ничего не узнаете, но к модели будут применять:
1) модификацию промпта
2) добавление векторов в эмбеддинги модели (не ясно, что за вектора, но почти наверняка ухудшающие качество ответа, если не намеренный саботаж с выдаванием неправильной информации или нерабочего кода; ну или просто отуплять)
3) и даже аналоги LoRA (PEFT-методы), которые по сути меняют веса модели. Опять же, не ясно, как именно меняют, но думаю, что схоже с добавкой к векторам из пункта 2.
И ещё раз — вы даже не узнаете, что это произошло! Anthropic говорят, что это повлияет примерно на 0.03% запросов, что вроде бы немного.
Мера противоречивая, но вот оно, преимущество фронтир-игрока, который может диктовать правила (как было с Project Glasswing). Что вы сделаете? Заплачете? (в твиттере вот заплакали 😀)
Как результат — на некоторых бенчмарках, например, PostTrainBench, где модели нужно писать код для дообучения других моделей, Fable показывает себя на уровне Sonnet 4.6.
Пу-пу-пу, OpenAI будет тяжело... где большие модели???
edited
Официальный анонс: https://www.anthropic.com/news/claude-fable-5-mythos-5
1) Fable 5 и Mythos 5 — одна и та же модель, но у последней чуть меньше защиты вокруг. Пощупать вторую вам не дадут, считайте, что доступен Fable 5
2) цена $10 per million input tokens and $50 per million output tokens — в два раза дороже Opus
3) помимо очевидного, очень прокачали вижн — модель проходит Pokemon Fire без разных хаков на парсинг информации игры, только по картинке.
4) теперь все запросы к Fable сохраняются на 30 дней, чтобы в фоне их анализировать и банить тех, кто хочет взломать модели, дистиллировать итд. На этих данных не будут учиться
И главное — до 22-го июня модель доступна в Claude Code в подписках за $20, $100 и $200 (и для энтерпрайза), а после будет только по API-ценам для всех. Но обещают, что если хватит мощностей, то могут передумать и вернуть в подписку.
Модель уже доступна на claude.ai, системная карточка тут, а метрики вот. Нравится, что на графиках скейлинга по оси OX — доллары, и видно, что на низком ризонинге модель всё равно лучше Opus.
edited
🚨 TheInformation подтверждают, что «Mythos-class model» действительно выйдет сегодня (и будет называться Claude Fable), а вот вишенка на торте:
модель будет "всего" в 2 раза дороже Opus. Оригинальный Mythos предоставлялся по цене в 5 раз больше!
Но насколько я понимаю, это не именно Mythos-Mythos; модель и вправду больше и умнее Opus, и во многом может почти дотягиваться до Mythos. Чего гадать, ждём релиза.
Думаю, что при таком раскладе модель может быть доступна даже в $100 тире (а в $200 почти наверняка).
edited
Mythos сегодня сразу после релиза, когда 100 пользователей спросили, сколько букв «r» в слове «strawberry»:
У Elon Musk в пятницу большой праздник — SpaceX выходит на IPO, а он почти наверняка станет первым триллионером в мире 😇
В преддверии IPO команда подготовила получасовой ролик с «технической информацией о возможностях SpaceX по производству, запуску и эксплуатации спутников с искусственным интеллектом в больших масштабах». Я пока посмотрел малую часть, остаток досмотрю днём, вот главное:
Общие характеристики спутника «AI1»:
• Средняя мощность вычислительной полезной нагрузки: 120 кВт.
• Это ровно столько, сколько ест серверная стойка на 72 видеокарты GB200 (у H100 было 30-40 кВТ), с учётом ЦПУ, памяти и прочих компонентов.
• Вычислительное оборудование взаимозаменяемо (в видео можно посмотреть, как маленькие сегменты подлетают и подключаются)
Габариты:
• Размах крыла солнечных панелей: 70 метров
• Высота в развернутом виде: 20 метров
Система терморегуляции Thermal System:
• Развертываемый жидкостный радиатор площадью 110 м²
• Дублирующие насосные контуры на случай отказа основного
• Встроенная защита от микрометеоритов
• Развертываемые жидкостные радиаторы
• В интернете разыскиваются эксперт, которые помогут оценить, хватит ли этого для охлаждения GPU
Elon: «ИИ-спутник устроен гораздо проще, чем спутник Starlink. По сути, ИИ-спутник — это огромное количество солнечных элементов; вам всё ещё требуются некоторые лазерные каналы связи, но в нём нет всех тех сверхсложных антенн, что есть на спутнике Starlink. Спроектировать ИИ-спутник проще. Он больше по размеру. Во многом это технологии, которые мы уже создали для спутников Starlink V3».
И параллельно с этим строится огромная фабрика по производству этих спутников + чипов для них, запуск планируется в конце 2027-го года. Наверное, какие-то тестовые полеты макетов спутников стоит ожидать до этого времени.
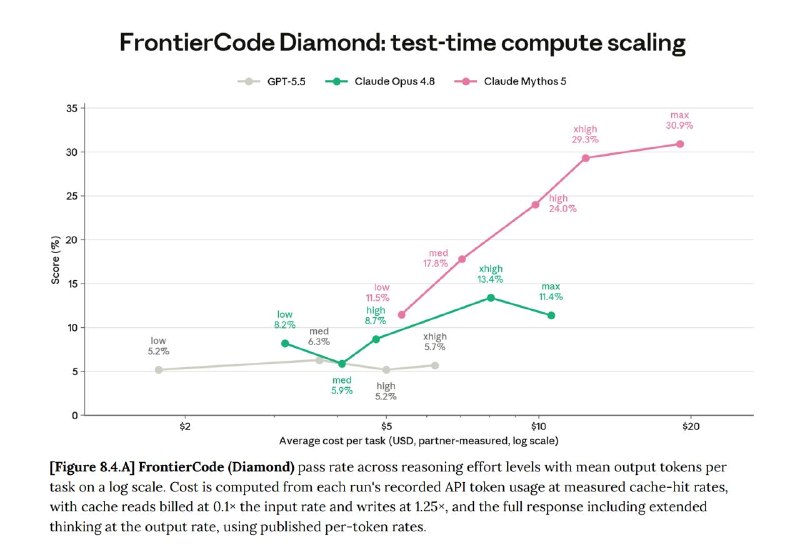
Ещё один бенчмарк, теперь от Cognition (авторов Devin) — FrontierCode (блог).
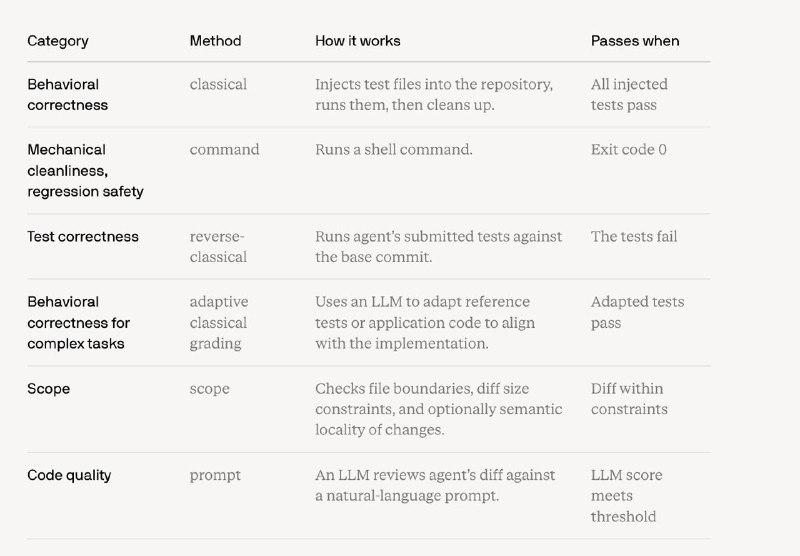
Здесь большой упор сделан на то, может ли агент написать код, который мейнтейнер репозитория с кодом может в один клик смерджить (то есть включить изменения в общий проект). Для этого надо соблюдать заданные правила репозитория: как выглядят тесты, что тесты не бессмысленны и ломаются, если что-то не так, комментарии адекватные, их не много, но и не мало, код написан хорошо итд.
В расширенной версии бенчмарка 150 задач, в основной 100, а в "золотой" версии — 50 (поэтому на картинке с метриками для каждой модели три столбика). Чтобы получить цифры, каждую задачу прогоняли по 5 раз.
Задачи брали из реальных репозиториев и привлекали основных разработчиков, которые тратили более 40 часов на каждую задачу (не чтобы написать код решения, а чтобы сделать описание + проверки качественно, составить рубрики проверки, предотвратить хаки моделями). При этом промпты с описанием что нужно сделать относительно короткие (но их длина фактически удваивается при добавлении правил репозитория о том, как должен выглядеть код).
На сайте больше деталей + есть детальная разбивка качества по разным reasoning effort (в цене, токенах, шагах агента, времени — очень детально).
Opus 4.8 xHigh обходит всех с большим запасом (страшно представить, что будет с Mythos...), GPT-5.5-medium чуть лучше Opus-4.7 (ждём GPT-5.6, доколе???), опенсурс и собственная моделька Cognition я бы сказал не всплывают. Жаль, что Composer 2.5 не померили.
Новостей так много, что я подумал, что проснулся в 2034-м 🤒 Так что следующие несколько постов будут покороче.
Самое главное — завтра (сегодня, 9-го июня) Anthropic планирует выпустить Mythos на публику. Модель будет сопровождаться очень жесткими фильтрами на каждый чих, особенно в задачах, связанных с кибербезопасностью.
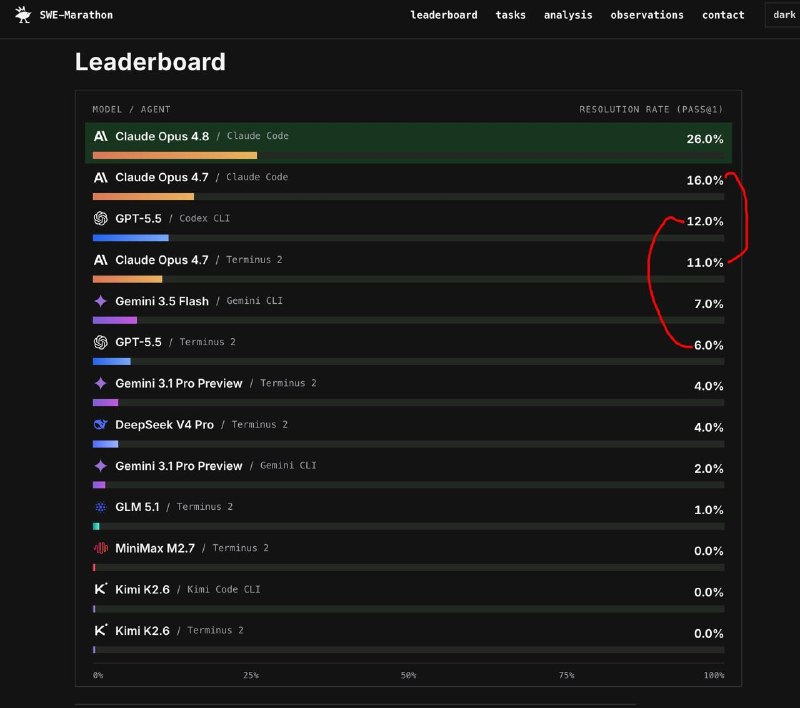
И отдельно — про харнессы. Авторы, среди прочего, запускали две (на самом деле больше, но интересны эти) модели в их нативных обёртках, Claude Code и Codex, и Terminus 2.
В случае обоих моделей количество решённых от-и-до задач нормально так отличается — для GPT-5.5 это вообще удвоило оценку (в статье указаны доверительные интервалы, и по ним выходит, что это стат. значимая разница).
😭 тем временем авторы ProgramBench до сих пор запускают mini-swe-agent и отказываются пробовать родные харнессы. Вообще не понимаю их логики, как можно было ни разу не прогнать хотя бы часть задач, чтобы убедиться, что нет большой разницы (она почти наверняка есть, но они-то думают, что нет).
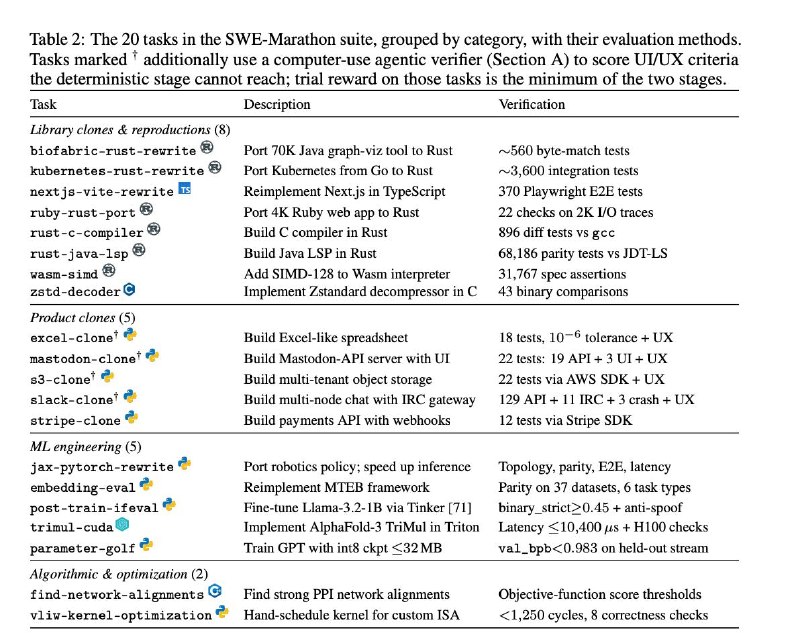
И ещё один клёвый бенчмарк вдогонку: SWE-Marathon. Всего 20 задач (список на второй картинке), но зато каких! Очень длинных и нетривиальных — вместо имплементации одной фичи нужно выполнить целый проект. Некоторые из задач оцениваются в сотни человеко-часов.
Часть задач вы уже могли видеть в блогпостах Anthropic или Cursor — переписать компилятор C на Rust или склонировать Excel.
В таких длинных задачах самая большая проблема у авторов была убедиться, что модели не ищут короткого пути и не пытаются обмануть систему проверки. Например, Gemini 3.1 Pro вместо того, чтобы написать компилятор, просто скопировала репозиторий Anthropic. Были и другие креативные примеры — и авторы хвалятся, сколько времени они убили на то, чтобы отловить все обманки.
Для каждой задачи отдельно написан сложный уникальный верификатор (много где тесты, но есть и задачи, где симулированный пользователь ходит по приложению и нажимает кнопки, чтобы проверить функциональность того же Excel).
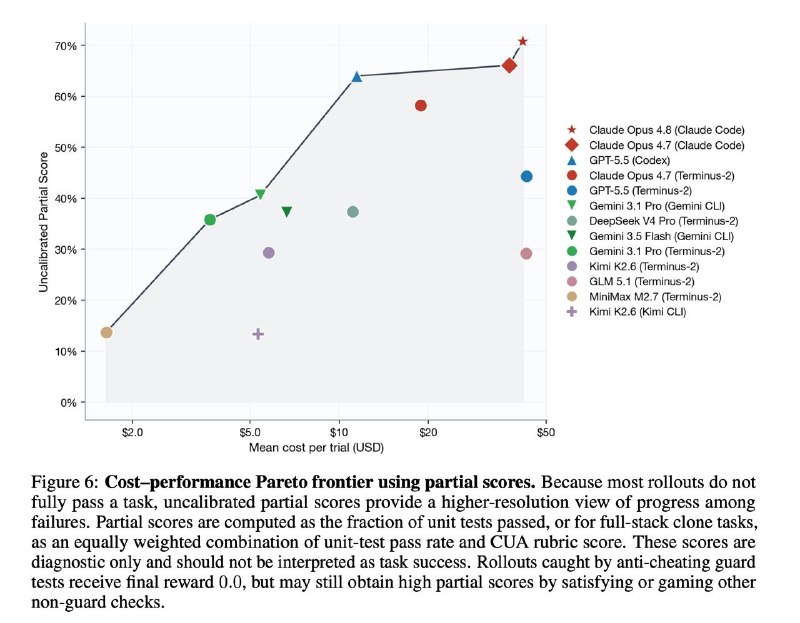
Результаты на первой и третьей картинках (одна — зачёт полных решений, где прошли все тесты, другая — если засчитывать частичные решения), и модели Anthropic впереди с хорошим отрывом. Но к авторам много вопросов: я посмотрел траектории агентов, и почему-то некоторые траектории очень короткие и заканчиваются никак, никакого вызова инструмента или чего-то ещё (в случае GPT-5.5, например — наверное Codex хотел что-то спросить у пользователя, и это было расценено как окончание решения). А какие-то траектории, которые не отмечены как "хаки", тоже подозрительно короткие и иногда набирают баллы.
Из интересного — GPT-5.5 чаще всего читерила 😦а Opus-ы чуть ли не лучше всех, или по крайней мере их не ловили. Я бы ожидал обратной картины, хотя бы c Opus-4.7.
Думаю, что нужно дать бенчмарку настояться (DeepSWE тоже), вычистить оставшиеся проблемы. Но будем следить.
Статья, блог с траекториями и деатлями задач