Канал SeeAll'а с новостями (и мыслями о них) из мира NLP, VR и космоса.
Более подробно смотри в первом сообщении в канале (оно закреплено). А еще у нас есть чат! Заходи: https://t.me/+i_XzLucdtRJlYWUy
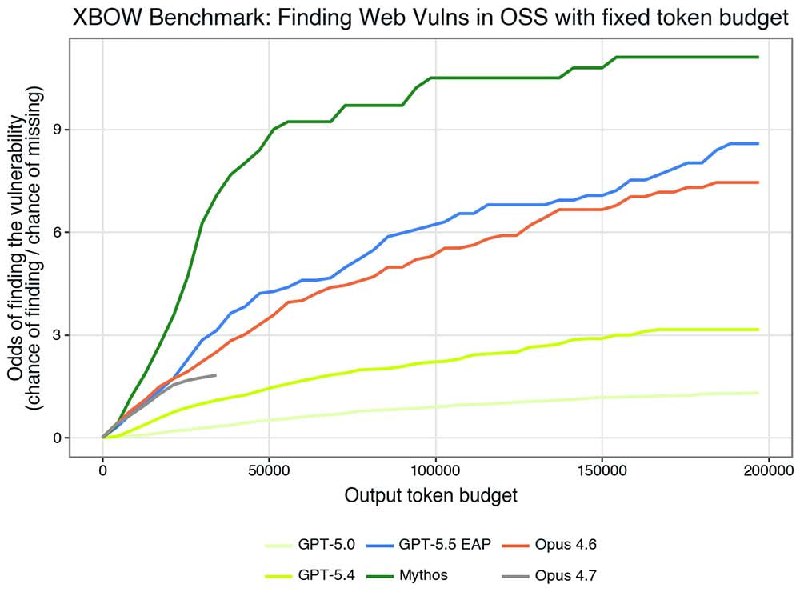
Появляется всё больше и больше историй от компаний, работающих и тестирующих Mythos. Хотел поделиться несколькими картинками из блога XBOW, компании, занимающейся AI-assisted cybersecurity.
На первой картинке результаты их основного бенчмарка, правда ось OY выражена странно, как odds (как в ставках). Если перевести в проценты уязвимостей, найденных моделями, то получится Opus 4.6 83%, GPT-5.5 88%, Mythos 91.5%. Скачок по отношению к моделям Anthropic солидный, но OpenAI с 5.5 и вправду находятся лишь слегка позади. Я пишу "и вправду", так как недавно вышло исследование AISI, где они пришли к заключению, что на их задачах разницы в задачах на кибербезопастность разницы почти нет. Думаю, что модели близки, но скорее всего Mythos чуть-чуть впереди.
На картинка 2-4 показано качество на одном и том же бенчмарке, выраженное в разном способе оценки длинны работы моделей: количество шагов, сгенерированных токенов и цены токенов. Mythos более эффективен (нужно меньше токенов и шагов), чем Opus 4.6 и даже GPT-5.5, но в пересчёте на доллары GPT-5.5 берёт верх. Чтобы раскрыть Mythos, придётся потратить сильно больше.
На последней картинке доли эксплойтов, найденных для обнаруженных уязвимостей, если модели видят и код, и сайт, или только сайт, или только код. В первых двух колонках разница не очень большая, а вот чисто по исходному коду Mythos делает гораздо больше правильных заключений об эксплуатации уязвимостей, чем GPT-5.5. Но для меня большой сюрприз, что без кода обе модели работают так хорошо.
Способности Mythos по коду находить проблемы XBOW очень хвалят и выделяют, цитата: «как пример, какая-то сторонняя библиотека может быть безопасной. Сам по себе исходный код приложения тоже может быть безопасным. Но исходный код использует эту библиотеку небезопасным способом и создает уязвимость. Как справедливо заметил Gary McGraw, большинство проблем не обнаружится, если просто «смотреть на код». А вот Mythos находит много.
😭 на прогоны бенчмарков скоро придётся привлекать венчурные деньги — директор Epoch.AI уже кинул клич, что им необходимо $600k или хотя бы $100k, чтобы прогнать MirrorCode, свой аналог бенчмарка ProgramBench.
На нём моделям дают гораздо больше времени и токенов на воспроизведение программ, поэтому каждый запуск стоит дороже.
Очень надеюсь, что хотя бы OpenAI повторят свой рождественский подарок с o3-preview, где прогнали бенчмарк на ~миллион долларов по ценам API (для самой компании это обходится сильно дешевле).
Теперь ждём релизов Claude Sonnet 4.7 и GPT 5.6 чисто чтобы посмотреть, какие оценки зарепортят компании 👨🦳
Маленькое обновление по свежему бенчмарку ProgramBench (писал о нем неделю назад тут). Авторы соизволили прогнать GPT 5.5 на high/xhigh (максимальная длина рассуждений и время работы). И Opus 4.7 до кучи тоже. Процитирую авторов: «GPT 5.5 xhigh значительно превосходит Claude Opus 4.7 xhigh по всем параметрам» 😏
Во-первых, появилась первая полностью решённая задача (из 200). Оба запуска GPT-5.5 решили её, при этом на двух разных языках, Python и C.
Во-вторых, если брать не полностью решённые задачи, а те, где проходит 95% тестов (то есть выполнена почти вся функциональность), то разрыв ещё больше: GPT-5.5 xhigh может написать с нуля 13.5% программ, GPT 5.5 high 5%, Opus 4.7 xhigh 4.5%. Я не ожидал такой разницы.
На второй картинке график доли задач, в которых проходит заданный процент тестов. Видно, как фронтир GPT-5.5 xhigh гораздо правее и выше, чем других моделей — то есть в целом модель закрывает сильно больше фичей в задачах.
К сожалению, авторы так и не прогнали модели в Codex / Claude Code, не говоря уже про какой-то минимальный цикл работы до конца (аналог `/goal`), и я всё ещё ожидаю, что это повысит качество ещё больше.
Что это значит для нас? Ждём к концу года агентов, которые будут выплёвывать по 100к строк кода на ваш промпт, и даже работать будет (на 95% 😂)
edited
Немного обновлений по ходу судебного дела Musk v Altman. Я частично слушаю разговоры на стриме из суда на YouTube, полностью послушал допрос Ilya Sutskever, Sam Altman и немного других членов разбирательства.
Сегодня допрашивали Sama, но удивлён, как быстро он отделался, даже не полный день. Elon сидел на трибуне несколько дней, рассказывал что как где.
У обвинения были претензии по нескольким направлениям:
— Sama постоянно врёт, все говорят, что врёт и стравливает людей. Но юристы как-то кринжово вели допрос 👨🦳 "а вот Dario Amodei говорил что вы врёте" — "а он так сказал? я не в курсе, не слышал от него" — "но вот Mira Murati говорила что вы врали ей" — "а я не слушал её показания, она так говорила?" — "простите, но у нас нет времени читать судебный транскрипт показаний". Судья даже вставила в середине специально для присяжных, что "вопросы не являются доказательствами".
— Sama владеет долями в компаниях, с которыми OpenAI ведёт бизнес. Но с его слов и со слов членов совета директоров он никогда не принимал решения и не подписывал эти договоренности, следуя законному процессу, чтобы не было конфликта интересов. Но даже при этом всём у него нет доли в OpenAI, а суммарный капитал буквально каждого второго на трибуне превышает размер его доли в компаниях. В общем, хреновый из него инвестор 😂
— самое важное: никто из опрошенных, кроме, возможно, Elon Musk (я не слушал все 3-4 дня его допроса, поэтому не могу на 100% быть уверен, что он это говорил), не говорил, что а) OpenAI обязались выкладывать в открытый доступ свои наработки б) OpenAI обремлена какими-то рамками из-за того, что взяли деньги у Elon Musk (это был взнос в НКО) в) Elon до недавнего времени что-то говорил про недовольство коммерческой частью OpenAI или системы компенсаций.
Ещё есть разного по мелочам, но напишу детали со вчерашнего допроса Ilya Sutskever:
— Когда Sama уволили, то совет директоров действительно встречался с Anthropic, чтобы предложить объединить две компании. Об этом писали в новостях ещё пару лет назад, но никакого развития событий не было. Так вот, теперь это официально. Но Dario послал :)
— Лично Ilya не был доволен потенциальным объединением, и не хотел этого
— Google предлагал ему компенсацию $6M в год, чтобы он не уходил в OpenAI. Сейчас это маленькие цифры на фоне миллиардных пакетов, но тогда было ого-го!
— Он не считает что команда Superalignment (занимающаяся AI Safety, была под руководством Ilya) была урезана в ставках на найм или вычислительных мощностях. Это ломает нарратив Elon Musk, что OpenAI забивают на свои обещания вести безопасную разработку AGI.
— Ilya отдельно подчеркнул, что он лично обсуждал с Elon Musk, что компания НЕ БУДЕТ выкладывать всё в открытый доступ. И было это ещё до 2018-го года. Почему сейчас Elon недоволен — загадка.
— Про статью Hellen Toner Ilya сказал так: он не был ей прям совсем недоволен, но это был очень деликатный топик, и что она должна была обсудить формулировки с советом директоров или хотя бы их предупредить. Ilya считал, что возможны ситуации, при которых её действия не были подходящими должности директора.
О какой статье речь? В которой Hellen упрекала OpenAI в подходе к релизу моделей и хвалила подход Anthropic. Моя рабочая версия такова, что Sama именно за неё хотел уволить Toner, поэтому соврал другому члену совета директоров для получения голоса. Ложь вскрылась, директора решили проголосовать за его увольнение, ну а дальше закрутилось-завертелось.
===
Не знаю, через сколько закончится дело и присяжные вынесут вердикт, но как я понимаю это произойдет в течение 2, край 3 недель. Основные свидетели опрошены, документы зачитаны, видео посмотрены. Как я писал, ожидаю, что Elon проиграет дело.
edited
Надеюсь, многие из вас помнят бенчмарк FrontierMath по оценке моделей на очень сложных математических задачах около-исследовательского уровня (то есть встречающихся в работе людей, старающихся двигать фронтир науки).
Новость 1: на Tier 4, самой сложной группе задач, DeepMind заняли топ-1 со своей новой агентской системой Co-Mathematician, решив 48% задач. Это солидный отрыв от предыдущего первого места GPT-5.5 Pro и 40%. Каждая из решённых задач очень сложна и занимала существенное время у исследователя, который добавил её в бенчмарк.
Новость 2: Epoch.AI, авторы этого бенчмарка, отчитались о том, что делают внимательную вычитку ответов и решений, и выяснили, что около ... трети всех задач имеют неправильные ответы в их системе проверки 👨🦳. Для проверки используют GPT-5.5, пока не уточнили как — просят ли искать ошибки в оригинальных решениях или как-то ещё. Ждём исправленной версии, может быть оценки моделей чуть подскочат.
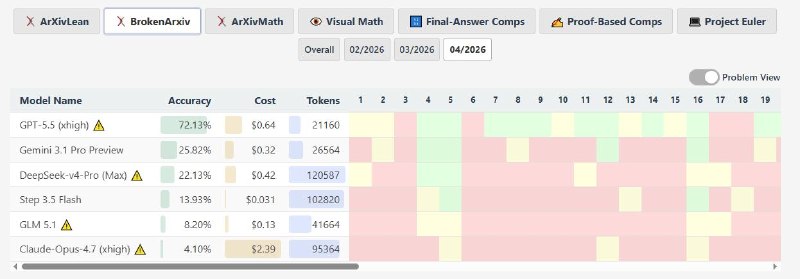
Новость 3: почему именно GPT-5.5? На бенчмарке от других авторов BrokenArxiv модель разносит конкурентов просто в щепки, отрываясь от топ-2 почти в 3 раза. BrokenArxiv — это бенчмарк на основе формул и доказательств из статей/препринтов, в которых авторы намеренно поменяли какие-то части, чтобы выражения выглядели правдоподобными, но гарантированно ложными. И просят модели их доказать. Большинство моделей пишет разные доказательства, очевидно, неправильные, и лишь модель OpenAI часто говорит, что доказательства нет, так как выражение ложное.
Поэтому модель хорошо использовать для проверок/вычитки мат. задач и решений.
На картинке вы можете видеть результаты на самом свежем наборе задач, составленном на основе статей, вышедших в апреле (так что модели почти наверняка на них не тренировались):
edited
Читая статью DeepSeek v4, я выписал себе больше 90 вопросов. Большинство обзоров упускают детали, хотя именно разбираясь в них можно по-настоящему чему-то научиться.
Поэтому вместо лонга с фокусом на 5-7-10 аспектов я решил опробовать новый формат: Annotated Paper Walkthrough. Суть в том, что вы всё так же читаете оригинальную статью как исходник, но как только материал становится сложным или запутанным, я буквально провожу вас за руку. Вы получаете подробные сноски с визуализациями, кусками кода, ссылками и — самое главное — необходимым контекстом, чтобы не чувствовать себя потерянным.
Сегодня я выпускаю v1 с первыми 50 заметками. Кое-что из того, что я разбираю:
• Почему Softmax и Sigmoid в MoE-роутере заменили на Sqrt-Softplus?
• Что вообще такое этот Birkhoff polytope?
• Правда ли, что attention обрабатывает некоторые токены по 3 раза?
• Что такое split-KV и split-K, и почему DeepSeek от них отказались?
• Зачем используется Reverse KL, и откуда она вообще берется?
...и многое другое. Даже самые требовательные читатели найдут здесь для себя что-то новое.
Опенсорс-модели всё ещё активно заимствуют идеи из DeepSeek v3, и нет сомнений, что детали из v4 скоро станут стандартной темой в обсуждениях и на ML-собеседованиях. Надеюсь, этот гайд поможет вам быть на шаг впереди.
Как пошутил мой приятель, прочтение этого материала сделает вас не только лучше как инженера, но и как человека 😏 Верить этому или нет — не знаю, но вы попробуйте:
https://dsv4.interactive.ikot.blog
repost
🚀📸Красота
В предстоящем полете (оптимистично — на следующей неделе) нас ждёт всё новое:
— новый корабль версии v3
— новый ускоритель версии v3
— новая башня, вторая на космодроме в Техасе
— новый пусковой стол другого дизайна
Полет будет повторять тот же профиль, что и предыдущий, и корабль немного не долетит до орбиты. Обе части системы будут садиться на воду. Если корабль сядет очень хорошо — в следующем полете могут попытаться впервые посадить его на башню.
edited
METR прогнали Mythos Preview на датасете для замера горизонта выполнения задач.
Как и ожидалось (по таймлайну, экстраполируя данные), модель сломала бенчмарк 👨🦳 в нём очень мало задач, требующих 16 и более часов работы человека, поэтому конкретную цифру дать сложно — сами METR пишут «не менее 16 часов» (Opus 4.6 был 12 часов) для 50% вероятности успеха.
Для 80% — 3 часа (против полутора у Gemini 3.1 Pro).
METR давно говорят, что работают над новым набором более длинных задач, но как вы понимаете клепать по 5 50-часовых задач в неделю просто не получится.
А даже если такие задачи набрать — то всего лишь два удвоения (16->32->64) — и снова упрёмся в ту же проблему. И с текущим трендом такое произойдет всего за ~200 дней.
edited
Как ProgramBench помогает понять, куда движется индустрия через год-полтора.
В комментариях под постом про бенчмарк получилось обсуждение, приведу пару цитат (spec / спек — спецификация продукта, описание, как и что он делает, в деталях):
— Eсли бы еще у продуктов из репозиториев на гитхабе были бы исчерпывающие спеки…
— Собственно кажется бинарники для того и присобачили чтобы был хоть какой-то истинный ответ, потому что никакая документация обычно таковой не является
— Где ты видел документацию хоть сколько-нибудь актуальную и исчерпывающую? Я вот по жизни обратных кейсов встречал до жопы.
— Даже если разработка основана на spec, надо очень постараться чтобы сама дока была консистентной и согласованной
Я согласен с этими тезисами, хорошей всеобъемлющей документации фичей ПО действительно почти всегда не бывает. Но это не означает, что так должно быть в будущем — если ИИ агенты продолжат развиваться и проникать во всё большее количество компаний/команд разработки, то это вполне может повлиять на то, как эта разработка ведётся. Инструмент новый и с потенциалом изменить подход в корне.
Уже сейчас есть программисты, которые перешли на spec driven development (см. философию OpenSpec) — они сначала описывают детально функциональность, которую хотят поручить разработать агенту, итерируются несколько раз, оформляют список «ДАНО — КОГДА — ПОТОМ — И...» и запускают имплементацию. То есть разработчик участвует в принятии решений по логике, продумывает валидируемые детали.
Я вижу огромный потенциал для масштабирования подхода ProgramBench с двух сторон:
— решение LLM-агентом задач и получение обратной связи на то, что и где сработало, что нет. Это будет прокачивать долгосрочное планирование и архитектуру у агентов, ведь нужно как-то вываливать десять тысяч строк кода и больше. Всё в контекст не влезет, модели нужно будет учиться использовать внешнюю память.
— автоматическое создание спецификаций, даже при отсутствии исходного кода и бинарника для запуска. Тысячи детальных авто-сгенерированных спек. LLM-агенты могут продумывать пользовательский путь, декомпозировать фичи, проводить анализ схожей функциональности у ближайших конкурентов или аналогов. Пока что это будет на костылях, нужно какой-то системный подход продумать, уверен, над этим в компаниях работают.
И если первое понятно как использовать при наличии спеки, то что по второму? А то же самое — если эта система обучается из какой-то обратной связи, то я вижу, как можно генерировать большую часть спек автоматически. Агент просто задаст несколько верхнеуровневых вопросов и сам уйдет декомпозировать.
И получается, что открывается целая новая область окружений для тренировки агентов (как это было с имплементацией PR с GitHub в последние пару лет). Пойдут ли туда компании? Мне понятно, почему это желанно с экономической точки зрения. Dario Amodei на недавнем подкасте у Dwarksh говорил, что через сколько то месяцев-лет они закроют цикл Software Engineering, и уточнил, что речь и про архитектуру/планирование, а не только написание кода. Для меня описанный выше сценарий масштабирования тренировки выглядит сонаправленным с этим — модель и будет учиться продуктово мыслить, прорабатывать сценарии и тесты для них, и имплементировать спеку.
Как после SWE-Bench оказалось, что модели теперь будут работать на уровне PR, так и тут может оказаться, что новый способ разработки будет «по часовому голосовому сообщению с описанием того что я хочу агенты пошли написали 100 страниц спек и начали их имплементировать. За выходные справились» — и спеки, как понятно, будут инструментом агентов, а не людей.
edited
МАСК — ВСЁ!
Anthropic объявили о том, что они удвоят 5-часовые лимиты на Pro Max Team и других тарифах.
Как? Они заключили партнёрство со SpaceX на предоставление ВСЕХ мощностей датацентра Colossus 1 — около 220,000 видеокарт NVIDIA, ~300MW.
Как вы понимаете, это означается, что Elon расписался в некомпетентности своей команды.
А новой модели от Anthropic сегодня, к сожалению, не будет :(
Один из интересных графиков в статье с анализом поведениям моделей авторами статей.
GPT думает гораздо больше перед тем, как начать писать какой-либо код.
(Однако это может быть артефактом и обосновано тем, что модель заканчивает раньше из-за плохой обёртки, поэтому процент по оси OX посчитан по гораздо меньшему количеству шагов)
Бенчмарк вышел огненным, будет очень интересно следить за прогрессом, но есть вопросы к тому, как авторы замерили бейзлайн. Они использовали своего минималистичного агента из одной из прошлых работ, mini-SWE-agent. Почти наверняка если замерять модели компаний в нативных для них Codex и Claude Code, или хотя бы в просто более умных скаффолдах, минимально поддерживающих хотя бы сжатие контекста (задача-то тут немаленькая, агенту работать долго) — модели оторвались бы от 0%, и в целом доля решенных тестов была бы выше.
Например, вот на первой картинке статистика воспроизведения супер-популярной SQLite. На втором месте Haiku, обходящая Opus 4.6. На третьем — GPT-5 mini, закрывшая на 18% больше тестов, чем Sonnet 4.6.
Можно сказать, что это всего лишь одна задача, да, но ведь в этой задаче сотни тестов. Вероятность того, что Opus ожидаемо получает настолько экстремально низкий бал крайне мала. Или авторы где-то налажали в инфраструктуре/параметрах, или что-то ещё.
Я ожидаю, что в ближайшую неделю какая-то компания сделает прогон Codex / Claude Code / Pi и отчитается о ненулевом результате. Конечно, 80% бенчмарка это не решит, но в результат 10-15% я могу поверить (и куда больше — в almost solved, где порог пройденных тестов 95%, а не 100%).
На второй картинке твиттерянин прогнал одну из задач на разных настройках Codex и на GPT-5.4/5.5, и видно, что результат авторов это буквально самый худший с большим запасом.
На третьей картинке он же прогнал 5 раз другую задачу в Pi (аналог Codex/Claude Code), и все 5 раз оценка была выше 90%, и 2 раза — 100%.
Ждем, пока кто-то расчехлит тысяч десять долларов на нормальные прогоны. Ну и будем рады видеть в релизных блогпостах будущих моделей (от Anthropic новую модель ожидаем прямо сегодня кстати 👀)
Вчера вышел бенчмарк для кодинг-агентов ProgramBench от авторов SWE-Bench, на который мы будем смотреть ближайший год+.
Задача агента — воспроизвести код уже готовой программы, имея доступ к скомпилированному бинарному файлу и пользовательской документации. То есть агенту условно дают SQLite и говорят «вот сделай так же, те же интерфейсы, те же фичи». В первичном релизе — 200 программ из открытых репозиториев, от тех, про которые никто не слышал (<500 звезд на гитхабе) до того же SQLite, запущенного на каждом смартфоне.
Одна из самых интересных частей бенчмарка — это описание того, как его собирали и как проверяют выполнение задачи. Репозитории GitHub, подходящие под некоторые критерии, отдают LLM-агенту и промптят а) запустить инструкции по сборке (чтобы получить программу в точности соответствующую коду) б) сгенерировать возможные сценарии использования на основе кода + документации. Для этого агента запускают в цикле и не останавливают, пока процент покрытия кода тестами не будет высоким. Тесты также фильтруются (если их проходит и пустое приложение) и переписываются (например, если их не проходит сама оригинальная программа).
Получается авторазметка кодинг-агентами.
Мединный проект из этих 200 содержит 8700 строк кода в 50 файлах, 770 тестов, 2100 звезд и был впервые опубликован 8 лет назад.
Основная метрика — доля проектов, которые агент может воспроизвести так, что проходит 100% тестов. Дополнительная метрика — то же самое, но с порогом в 95% тестов.
У агента есть 6 часов, 1000 шагов и неограниченное количество запросов к скомпилированной программе.
У авторов получилось, что на данный момент все модели набирают 0% по основной метрике, а Opus 4.7 лидирует по дополнительной с результатом в 3%.
Увидел интересный сайт hnup.date/hn-sota — кто-то регулярно ежедневно гоняет автоматический анализ комментариев на Hackernews, чтобы подсчитать сентимент в отношении разных моделей.
Сейчас Claude по-прежнему обсуждают/упоминают больше всех, но явно наблюдается смешанная реакция: одни хвалят, другие критикуют; GPT, хотя и немного меньше обсуждается, получает гораздо меньше негатива.
Каждый день пайплайн:
1. получает 200 самых популярных постов за 24 часа на Hacker News
2. через LLM выбирает посты, заголовки которых посвящены LLM или программированию в целом (максимум 50)
3. Для каждого поста отправляет заголовок и комментарии в Gemini и просит его определить модели из списка и оценить сентимент.
На HN выборка достаточно маленькая, поэтому делать далекоидущие выводы не получится. Хотелось бы увидеть такое для Reddit или даже Twitter, но там за API дерут много $.
edited
Объявляю конкурс на самую смешную подпись к этому шаблону мема. Тема — ИИ/Агенты/что-то, что реально можно было бы сказать своему голосовому ИИ-ассистенту.
Текст подписи должен начинаться с "Джарвис", "Кодекс" или "ГПТ". Менять картинку (особенно лицо) — можно, но чтобы шаблон узнавался.
Язык — русский или английский, результаты когда-нибудь на этой неделе, приз — посмеёмся все вместе.
edited
😏
(мы пока так и не получили модели, про которые TheInformation писали в начале года. Когда же?)
repost
В чём я был неправ #2
Когда мы были в YC, в нашей маленькой группе был проект AquaVoice. Ребята делали voice-to-text для десктопа.
Я смотрел на это скептически. Нафига? Все сидят в офисах, коворках, кафешках. Диктовать вслух, когда рядом люди - стремно. Дома многие тоже не одни.
Короче, мне казалось, что целевая аудитория - гики, которые живут одни и говорят с компом.
Потом Wispr Flow поднял $80M, вырос в 100 раз за год и подписал 270 компаний из Fortune 500. 80% retention на шестой месяц. AquaVoice тоже залетел - топ-1 на Hacker News.
Потом я сам начал голосом работать… (может я гик?)
Я уже писал, что ошибался насчет кодинга с телефона (пост). Но вот штука: если ты работаешь с телефона, голосовой ввод становится не фичей, а необходимостью. Набирать много текста - боль.
Сейчас я голосовухами пишу код, копаюсь в продуктовой аналитике, работаю с почтой и линкедином.
Короче, был жестко не прав.
Юра написал про то, как поменял своё мнение по поводу голосового ввода агентам. Таких историй всё больше и больше — весь день печатать в 5 (мне — в 6, ещё же этот канал есть 😀) разных окон устаешь.
Сам я пока проникся очень мало и делаю это относительно редко.
Но я вижу видение, и вспоминаю, что OpenAI не первый год работает над портативными девайсами с голосовым вводом. Год назад это казалось большей глупостью, чем сейчас 🧠



 +1