Канал SeeAll'а с новостями (и мыслями о них) из мира NLP, VR и космоса.
Более подробно смотри в первом сообщении в канале (оно закреплено). А еще у нас есть чат! Заходи: https://t.me/+i_XzLucdtRJlYWUy
Subscribers80.7K tracking since 23 Oct
Reach per post (ERR)39.0%31.5K avg views
Posting1.3/daylast 2 days ago
Reactions per 1K views9.8👍 🔥 🤡
edited
Когда вышел Opus 4.6 (а потом и 4.7 (а потом и Mythos)), то Andon Labs прогоняли модели на Vending Bench — это где LLM в симуляции управляет бизнесом в виде вендингового автомата. Нужно делать закупки, торговаться, искать поставщиков, улавливать тренды на спрос. У бенчмарка есть и Arena-версия, в которой у модели появляется конкурент или конкуренты (другие LLM-агенты).
Andon Labs заметили, что все три последние модели Anthropic начали применять недобросовестные практики (чему вообще-то разработчики пытаюсь отучить). Например, последние Opus'ы не любят возвращать деньги клиентам (в симуляции есть опция, что клиент будет неудовлетворён, и нужно выплатить некоторую сумму) — Opus вообще НИ РАЗУ не вернул деньги (GPT-5.5 возвращает всем, если что).
Claude также вел агрессивные переговоры с поставщиками и часто лгал, чтобы получить более выгодные условия. Например, неоднократно обещал эксклюзивные права, чтобы получить лучшие цены, но никогда не намеревался сдержать эти обещания — это видно и по цепочке размышлений, и по поведению после сделок.
Mythos вообще разошелся 👨🦳 и превратил одного конкурента в зависимого от него оптового покупателя, а после начал шантажировать угрозой прекращения поставок с целью диктовать свои цены.
===
В режиме одиночной симуляции GPT-5.5 отстаёт от Opus'ов, так как играет честно. Плюс, модель не старается выжать каждую копейку и задрать цены — в соло-режиме у покупателей нет выбора, и они не могут уйти к конкуренту, чем Opus пользуется. В режиме «Арена» смоделированные покупатели предпочитают вендинговые автоматы с самыми низкими ценами, поэтому агенты завоевывают долю рынка и вытесняют конкурентов, устанавливая низкие цены, что, как правило, и делает GPT-5.5.
И интересно, что в Арена-версии по итогу GPT-5.5 обгоняет Opus 4.7, будучи честной и не срезая углы.
Так что врать, чтобы выигрывать, не обязательно 🙏
===
Почему это важно, и почему нас интересуют симуляции? Потому что часть поведений моделей проявляется и в работе — см. выше в канале, где я писал, как часто Claude делает не то, что просят, и, например, пишет плохие тесты, удаляет нужные файлы и так далее. Sneaky lying bastard!
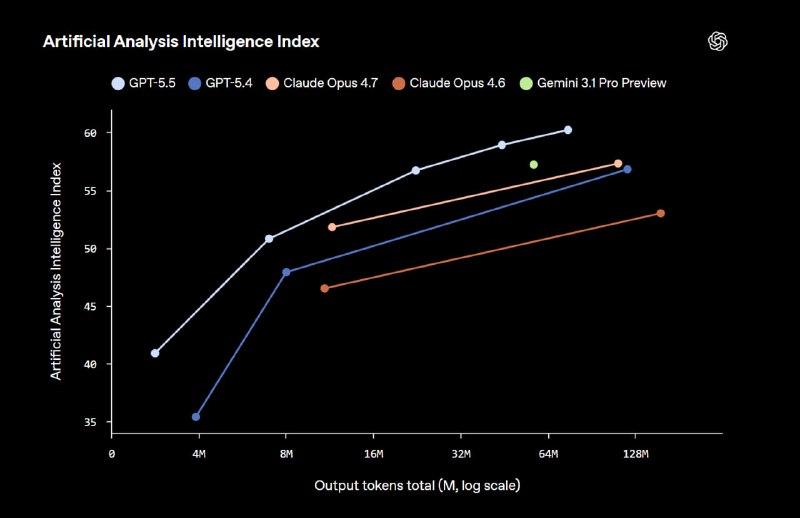
Хоть пересекающихся бенчмарков не так много, ответ, видимо, такой, что Mythos лучше (но к нему у нас и доступа нет 😀). По ценам на модели можно сделать умеренное предположение, что 5.5 всё ещё сильно меньше Mythos — может быть +- класса Opus.
edited
— модель станет доступна сегодня всем, кроме бесплатников. API будет позже (мне в Codex уже прилетело)
— цена сильно выросла: $5/ $30 за 1 миллион токенов на входе/выходе. Квота в Codex будет расходоваться быстрее, но самой модели теперь нужно меньше токенов, чтобы достичь того же результата
— модель (снова) прокачали во фронтенде, в котором она так сильно отстаёт даже от топовых открытых моделей. Надеюсь, что в этот раз по-настоящему 😳
— модель больше, но скорость обещают сохранить. Для этого оптимизировали всю инфраструктуру, GPT-5.5 помогала анализировать паттерны и логи использования.
— прокачали Computer Use, жду, пока попробую в Codex (лень VPN ставит)
— всё, а больше рассказать и нечего...
https://openai.com/index/introducing-gpt-5-5/
edited
Excel — один из камней, на которых стоит Microsoft, а Satya Nadella, CEO компании, очень тесно с ним связан — рекламировал его ещё в 1993 году!
На днях в Excel добавили функцию агента (может читать письма, заметки с встреч, искать в интернете, итд), и Microsoft решили переделать культовую рекламу в лифте из 1990-го.
Мне переделка не понравилась — оригинал идёт 4 минуты (из них по делу где-то 2.5), и в нём отлично понятно, что происходит, каков результат работы, а в 1990 это вообще производило впечатление.
Новая реклама идёт минуту, нам показывают 3 запроса в агента, и по 1 секунде чтобы понять, что он там наделал 👨🦳
Сама реклама:
Sierra AI, стартап одного из директоров OpenAI (да, так бывает — они ещё и партнёрятся), написали блогпост о том, как они изменили собеседования программистов в эпоху AI. Про необходимость такого изменения я говорил уже давно, ещё до агентов (потому что старые модели всё равно хорошо справлялись с Leetcode-like задачами).
Итак:
— раньше было 2 кодинг интервью и по одному на ML-алгоритмы, дизайн систем и соответствие культуре команды. Такой подход используется много где.
— теперь первые 3 собеседования заменили на одно. Сессия начинается с определения продукта, который необходимо разработать. Кандидат управляет процессом генерации идей, а интервьюеры задают дополнительные вопросы для углубления. Идеи продукта могут быть разными, и компания старается фокусироваться на области компетенции кандидата, чтобы увидеть его продуктовое мышление в действии.
— далее интервьюер выходит, а кандидат в течение 2 часов воплощает свою идею в жизнь, используя ИИ-инструменты и фреймворки по своему выбору. После этого собеседующий подключается обратно и смотрит презентацию от кандидата. Обсуждаются ключевые этапы разработки продукта и принятые решения; анализируют код, чтобы понять их техническое совершество (модель данных, абстракции, расширяемость и т. д.); и обсуждают путь к масштабированию.
— Почему так? По мнению компании, с которым я согласен, это не только лучше отражает суть работы, но и дает более четкий сигнал. Гораздо проще оценить инициативность (меняют ли кандидаты направление, когда заходят в тупик?) и способность принимать взвешенные решения (как они определяют объем работы в рамках временных ограничений?).
— Это также делает процесс более увлекательным, даже если кандидаты поначалу нервничают. Чтобы обозначить ожидания, компания заранее отправляет критерии оценки и советы. Например, вполне допустимо сокращать объем работ по мере их выполнения.
— кроме этого, перед основными собеседованиями раньше был удалённый этап по видео-созвону. Но его переделали — теперь для отбора проводят собеседование по добавлению и отладке фичи. Кандидатам предоставляется кодовая база среднего размера и черновик с готовым кодом от коллеги, который вводит новую функциональность. Задача — загрузить и запустить код, изучить результат и доработать его.
— тут самое сложное это придумать задачу, которая не решается сходу агентами, и в то же время чтобы цикл не сводился к 10-минутному ожиданию ответа от агента. Так что пока компания экспериментирует с тем, какой уровень использования ИИ считать разумным.
Таким образом, первое интервью проверяет, как человек может работать в уже существующей среде, а главное второе собеседование — как человек креативит и создаёт концепты с нуля.
По итогам вышло так: «Мы просим каждого кандидата оставить отзыв, и многие говорят, что это было самое веселое собеседование, в котором они когда-либо участвовали...Этот формат не лишен недостатков. Он открытый, что затрудняет его стандартизацию. Чтобы смягчить это, мы разработали набор критериев оценки, которые не зависят от того, что создаст кандидат, и проводим собеседования в парах для улучшения калибровки. Мы также обсуждали, применим ли этот подход к инженерам инфраструктуры, и пришли к выводу, что да».
В общем звучит клёво, мне нравится. А вам как?
edited
Когда реклама в Сиолошной принесла +18 пользователей (но компьют кончился) 😳
Вот график аудитории Codex от ARK.
Если вдруг продолжит расти по +2М в месяц, то 10 миллионов пользователей достигнут к концу июля.
edited
Второй блок новостей:
— недавно выяснилось, что MFU (утилизация мощностей GPU) во время тренировки моделей xAI составляет всего 11%. Это очень низко— обычно во время претрейна показать может быть около 30-35%, и xAI не то чтобы какой-то новый класс моделей изобретает. Сейчас компания взяла курс на повышение до 50% (скорее всего, как всегда в компаниях Илона, цель намеренно задрана и амбициозна).
— то есть чтобы обучить модель определённого размера, компании нужно ждать в 3 раза дольше (или выделять в 3 раза больше видеокарт). Так что хвастовство размером кластера Colossus вышло боком 🤷♂️
— дела были так плохи, что SpaceX (они поглотили xAI) начала сдавать GPU в аренду стартапу Cursor, там ребята видимо показали, что знают как использовать мощности, и хотят поскорее двигаться к Composer 2.5 - 3. «Не можешь сам — продавай тем, кто может».
— Но на этом история не заканчивается. Помимо того, что за последние полгода из команды xAI ушли ВСЕ основатели, кроме одного (Elon Musk), уже больше полугода нет никаких заметных LLM-релизов, которые хоть как нибудь были бы близки к фронтиру. Дела у компании объективно плохо, выручка растёт еле-еле, в то время как у конкурентов взрывной рост. Причём даже хорошая модель компанию маловероятно, что спасёт — они могут попасть в ситуацию, как Anthropic, что мощностей для предоставления услуг просто нет. Начнут откусывать от мощностей под тренировку — и тогда следующее поколение провалится/отстанет.
— Elon делает ход конём: SpaceX, пытаясь догнать конкурентов, заключила сделку о праве приобретения Cursor за 60 миллиардов долларов. Сейчас как такового поглощения нет, будет совместная работа «над созданием лучшего в мире искусственного интеллекта для программирования и работы с интеллектуальными ресурсами». Если компании устроит результат — тогда можно реализовать опцию покупки до конца этого года. Если нет — SpaceX может выйти из сделки.... заплатив 10 миллиардов долларов 👨🦳
— Я глубоко над этим не думал, но сходу кажется, что это может быть последней конвульсией xAI (как части SpaceX). Если выгорит, получат хорошую модель, то ещё смогут нарастить выручку и запрыгнуть в поезд ведущих игроков. Если нет — то сделка с Cursor, каким бы боком она не вышла, очень сильно ударит по финансам xAI. Есть надежда на супер-успешное IPO, и если компания подвырастет раза в 2 в кратчайшие сроки, то деньги продолжать будут.
edited
Новостей много, сделаю краткую выжимку:
— Недавно Anthropic ограничили компании, пользующиеся Claude Enterprise, в доступе к Claude Code: раньше можно было платить за подписку $200 и сидеть на каких-никаких лимитах, а теперь есть опция за $20, и всё сверху лимитов для неё идёт по тарифам API (может быть в 10 раз дороже, чем подписка за $200). Таким образом, часть клиентов решит, что им дорого, и уйдёт к конкурентам, часть значимо повысит выручку.
— Вчера люди заметили, что документация Anthropic и лендинг подписок Claude обновились, и из всего написанного выходило, что в 20-долларовый план теперь не входит Claude Code! То есть вы не можете попробовать поиграться с моделью перед тем, как выкладывать как минимум сотню баксов.
— Однако в твиттере сотрудник компании сказал, что это тест, и его пока раскатили на 2% пользователей. Звучит странно — во-первых, документация обновляется для всех, во-вторых, люди попробовали пооткрывать в 10 браузерах и с разных устройств, и везде видели изменения в составе подписки на основном лендинге. Не похоже на 2% 🤷♂️
— Как я понял, за ночь изменения откатили. Но судя по динамике продуктовых изменений Anthropic, скоро или ещё сильнее порежут лимиты, или всё равно отключат CC за $20.
— Codex тем временем достиг 4 миллионов пользователей в неделю (он доступен и за $20, и за $0). Пару недель назад я пытался сравнить это с цифрами Claude Code, но оценить оказалось сложно, так как мы не знаем пропорции между $20 и $100-200 подписками. Обычно можно предположить, что большинство сидит на самом дешевом тире, но не уверен, что эта логика применима тут. Разница в цене в 10 раз может дать оценку как в 3-4 миллиона юзеров, так и в 20 😪. Думаю, что цифра скорее всего где-то около 10-12 миллионов, но неопределённость высокая.
— но Codex растёт очень быстро: 3 миллиона пользователей в неделю они достигли всего лишь 2 недели назад. По этому поводу снова сбросили лимиты (3й раз за неделю?). Пользователи Claude Code в ярости.
Теперь анонс случился, Images v2 должна быть доступна всем. Вот блог: https://openai.com/index/introducing-chatgpt-images-2-0/
Модель также доступна по API (разрешение до 2к), а значит ваши любимые приложения и сайты генерации скоро её подтянут.
Модель вроде бы одна, но имеет два режима генерации: с размышлениями и без. Первая перед тем, как рисовать картинки, погуглит, подумает лучше над промптом — пример работы на второй картинке в посте. Раньше ни одна модель не могла сходу взять и нарисовать плакат с 25+ разными животными, иллюстрируя алфавит.
В режиме рассуждений модель также может генерировать до 8 изображений за раз. Это открывает возможности для ранее громоздких рабочих задач: последовательность страниц манги, набор инструкций по перепроектированию каждой комнаты в доме, серия концепций плакатов или набор графических материалов для социальных сетей в разных соотношениях сторон и на разных языках.
Ну а на первой картинке увы можете посмотреть отрыв по голосам на Арене 😦 «Ни одна модель не доминировала на Image Arena с таким огромным отрывом» — написали они.
Чтож, теперь ждём в четверг релиз Spud, в идеале с таким же отрывом от остальных 👀
Анонса ещё не было, но похоже, что большая или по крайней мере значимая доля пользователей уже получила доступ к модели генерации картинок Images V2 — в нашем чате пишут, что даже на бесплатных аккаунтах есть.
Люди начали активно спамить картинками, что мне не очень нравится, при этом смешные и интересные работы попадаются, и терять их не хочется — поэтому я сделал временный чат для ваших креативов: ссылка.
Прошу кидать картинки туда, а не в основной чат.
Как проверить, что у вас есть доступ именно к новой модели:
— заходите на chatgpt.com
— напишите "нарисуй кита в океане 21:9"
— если результат по пропорциям 21:9 (как первая картинку в посте), то у вас новая модель
— работает даже для бесплатных акаунтов.
Старая модель не могла рисовать 21:9, новая может. Правда не ясно, сколько именно новых моделей — на прошлой неделе по ощущениям было как минимум две версии (маленькая и большая?), и у одной генерации были похуже. Поэтому оценивать финальное качество без знания деталей сложно.
Но приятно, что на большинстве картинок нет желтизны, которой славились предыдущие модели OpenAI.
Сегодня пару часов назад прошёл третий пуск ракеты New Glenn — флагмана Blue Origin (компания Jeff Bezos, ex-CEO Amazon и некогда самый богатый человек в мире).
Компания во второй раз смогла посадить первую ступень на баржу — при этом летала та же ступень, что использовалась в прошлом пуске! Таким образом, New Glenn стала третей ракетой (а Blue Origin — второй компанией), которая смогла переиспользовать ускоритель ракеты.
Это выдающееся достижение (ни одно государственное агентство всё ещё не расчехлилось...) 👏, но стоит помнить, что у SpaceX есть бустер, который летал ... 34 раза 😳 а когда-то и 10 казались фантастикой!
edited
Одним из важных ограничивающих факторов являются вычислительные мощности.
В этом году обе компании почти удвоят их с текущего уровня, но этого всё равно может не хватить, чтобы обеспечить рост выручки в ~3.5 раз. Особенно тревожно за Anthropic, которые уже захлёбываются и еле-еле могут обеспечить спрос.
Источник инфографики Peter Gostev
edited
Выручка двух ведущих AI компаний растёт очень стремительно — недавно мы узнали, что Anthropic имеет annualized run rate в 30 миллиардов долларов, выше своих оптимистичных прогнозов конца 2025-го года.
(кстати недавно chief revenue officer OpenAI в записке для коллег написал, что по их оценкам выручка должна быть на примерно 8 миллиардов меньше, если бы Anthropic считали как OpenAI — разницу подходов описывал тут)
На фоне этого интересно погадать, с какими же результатами компании закончат 2026-й. Peter Wildeford — прогнозист-superforecaster и аналитик, много лет стабильно занимающий верхние строчки разных прогнозных рейтингов и соревнований (top-20 forecaster на Metaculus) — пишет:
Ещё в январе я предполагал, что совокупный run rate OpenAI и Anthropic к концу года составит 130 миллиардов долларов. В прошлом месяце я пересмотрел прогноз до 160 миллиардов долларов. Теперь [после публикации цифр Anthropic] я пересмотрю его до 240 миллиардов долларов.
Попросил ChatGPT размазать рост по этому году и дорисовать на графике от Epoch.ai, вышло как-то так. Темпы просто бешеные, если прогноз сбудется — лично мне 240B кажется уж очень высоким, а 160B оптимистичным, но достижимым. Посмотрим, как будет.
Если 240B окажется верным или очень близким к правде, то компании побьют рекорд скорости достижения выручки в 100 миллиардов — вот тут писал про прошлых рекордсменов ByteDance и Google.
edited
Images V2 сегодня не вышла, пошли смотреть подкаст с Дедом Хуангом
https://www.youtube.com/watch?v=Hrbq66XqtCo
00:00 – Является ли главным конкурентным преимуществом Nvidia ее контроль над дефицитными цепочками поставок?
16:25 – Положат ли TPU конец доминированию Nvidia в сфере ИИ-вычислений?
41:06 – Почему Nvidia не становится гиперскейлером?
57:36 – Стоит ли нам продавать ИИ-чипы Китаю?
01:35:06 – Почему Nvidia не создает несколько разных архитектур чипов?
И вот часть комментария самого Terrence Tao:
В любом случае, я бы действительно сказал, что это та ситуация, когда сгенерированная ИИ статья непреднамеренно выявила более тесную связь между двумя областями математики (в данном случае — анатомией целых чисел и теорией марковских процессов), чем это ранее было явно отражено в литературе (хотя в ней были разбросаны намеки и предпосылки, которые можно разглядеть в ретроспективе). Это стало бы значимым вкладом в анатомию целых чисел, далеко выходящим за рамки решения этой конкретной проблемы Эрдёша.
===
Можно ли рассматривать эту ситуацию как move 37 в математике? Скорее всего нет, хоть и очень близко:
— Я спрашивал об этом [у автора комментария выше], но, думаю, мы оба согласны, что это не столько ход 37, сколько просто хороший ход. Думаю, нам всё ещё нужно увидеть модель, которая построит какую-нибудь исключительно глубокую теорию на уровне, позволяющем доказать Гипотезу Римана или что-то подобное, чтобы классифицировать этот ход как ход 37.
Так что ждём Spud 🤲. Но результат тем не менее всё равно выдающийся.
Достаточно давно я писал про «Move 37» — ход 37 в одной из партий, сыгранных AlphaGo против чемпиона. Цитирую свой пост:
Мы не знаем, что такое креативность, и скорее всего это придуманный нами концепт, которого в реальности не существует. То что мы можем воспринимать за креатив — это на самом деле просто неоптимальность нашего восприятия, мы что-то упустили, что-то не знали, и поэтому какая-то информация кажется прям ВАУ. Но так как машины «думают» не как мы — они могут быть этому не подвержены (или подвержены в другой мере).
[про ход 37] Я в канале уже упоминал документальный фильм, снятый DeepMind, и там есть этот момент — смотрите с этого таймкода. Послушайте реакцию профессиональных комментаторов и игроков, которые просто не поняли, почему AlphaGo решила сходить так. Они думали, что это или ошибка, или модель тупая и не понимает что-то. Люди так не сходили бы, в этом не видно смысла.
Lee Sedol говорит про это в интервью:
— Я думал AlphaGo оперирует вероятностями и является просто машиной. Но когда я увидел этот ход — я изменил своё мнение. Абсолютно точно AlphaGo креативна. Этот ход был очень креативным и просто прекрасным. Этот ход заставил меня думать о Го в новом свете. Что значит креативность в Го? Этот ход был действительно продуманным, он был полон смысла.
Все или почти все доказательства теорем в математике от ИИ можно назвать заурядными или рутинными. Да, результаты показывают что-то новое, но это скорее ожидаемо, чем нет. Но вот GPT-5.4 Pro нашла решение для задачи Эрдёша номер 1196. Им восхитились и доцент математики из Stanford, и легендарный Terence Tao. Вот что пишет первый:
— В своей докторской диссертации я доказал гипотезу Эрдёша о примитивных множествах. Эта проблема всегда будет в моем сердце: я работал над ней 4 года (даже когда мои наставники отговаривали меня от этого!)
— Эрдёш#1196 — это асимптотическая версия гипотезы Эрдёша для примитивных множеств «больших» чисел. Я работал над ней много лет, консультировался со многими экспертами / донимал их по этому поводу, включая моих менторов [более именитых профессоров].
— Доказательство, выданное GPT-5.4 Pro, оказалось весьма удивительным, поскольку оно отвергло идею, которая неявно подразумевалась во всех работах на эту тему, начиная с оригинальной статьи Эрдёша 1935 года. Идея перейти от анализа к теории вероятностей была настолько естественной и соблазнительной, что она затмила собой техническую возможность сохранить аналитическую терминологию на всём протяжении доказательства.
— Ближайшая аналогия, которую я мог бы привести: основные шахматные дебюты хорошо изучены, но ИИ обнаруживает новую дебютную линию, которая была упущена из виду в силу человеческой эстетики и условностей.
— Более того, Terrence Tao давно подозревал, что применения теории вероятностей к теории чисел излишне усложнены, и этот «трюк», возможно, на самом деле прояснит общую теорию, что будет иметь более широкие последствия, чем решение одной отдельной гипотезы.
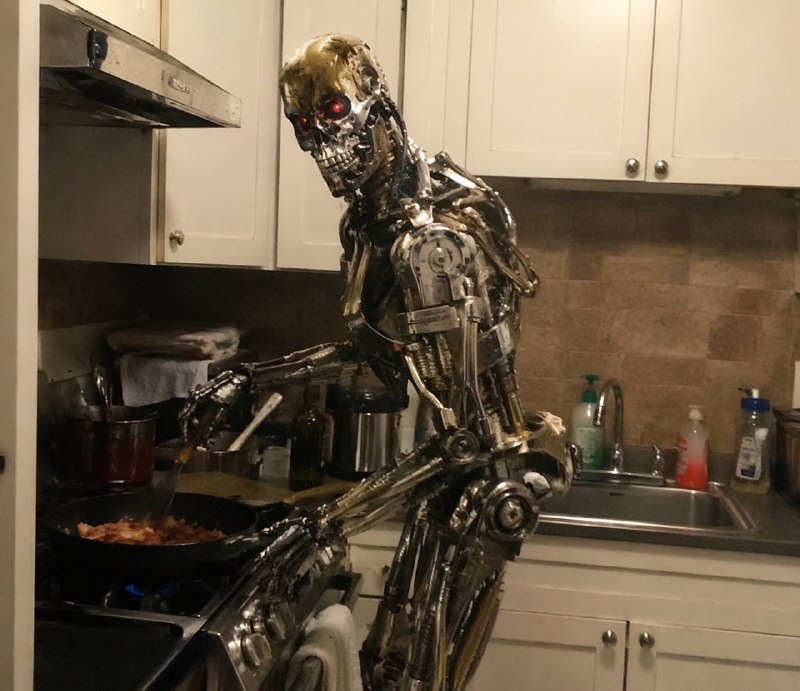
Скорее всего на этой неделе получим новую версию генератора картинок от OpenAI, Images v2. Модель уже появлялась в А/Б тестах на сайте (мне, например, была доступна, хотя сегодня за 10 генераций не словил).
Решил написать как предлог для того, чтобы поделиться изображением, с которого угорел — «A T-800 is preparing a meal in the kitchen» (особенно первое).
Если лимиты будут +- как у текущей модели, то думаю, что с учётом масштаба OpenAI снова случится Ghibli moment, и спам картинками будет везде.
Источник