
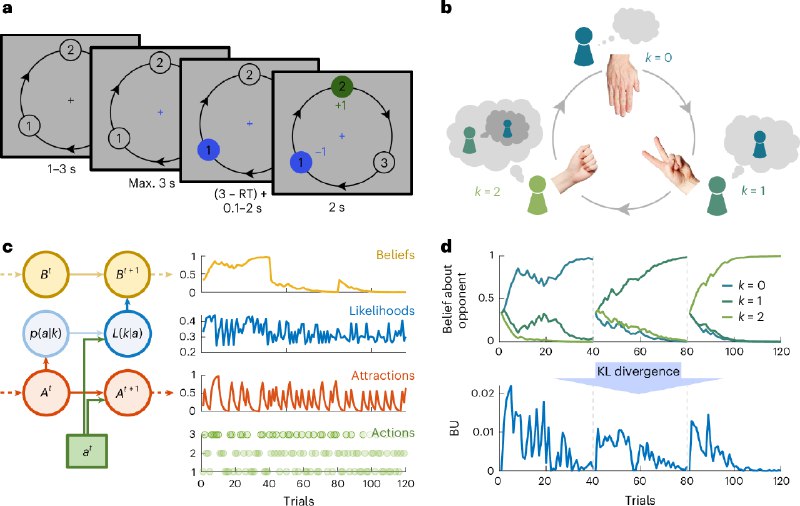
✂️Можем ли мы предугадать, насколько «хитёр» собеседник Сталкивались ли вы с ощущением, что в игре хочется «прочитать мысли» соперника — предугадать не сам его ход, а его рассуждения о ваших рассуждениях? И чем опытнее противник, тем глубже приходится заходить в эту рекурсию. Именно этот механизм разбирает работа, только что вышедшая в Nature Neuroscience. ❓О чем исследование Способность достраивать мысли, намерения и чувства других людей в науке называют ментализацией (или «моделью психического», theory of mind). Долгое время её изучали как относительно статичную характеристику. Но реальное взаимодействие устроено сложнее, ведь собеседники различаются по глубине рассуждений, и оптимальная стратегия против прямолинейного оппонента и против того, кто просчитывает вас на два хода вперёд, — разная. Авторы сфокусировались именно на этой динамической подстройке, которую обозначили как адаптивную ментализацию. ✊Методология В качестве модельной ситуации выбрали повторяющуюся игру «камень-ножницы-бумага» — в ней нет доминирующей стратегии, а выиграть можно, пытаясь предугадывать ходы соперника. В общей сложности через девять экспериментов прошли 553 участника, принявших свыше 11 000 решений; часть из них играла в фМРТ-сканере. Ключевой приём — калиброванные «искусственные» соперники, зафиксированные на разной глубине рекурсии: от уровня 0 (реакция лишь на частоту ходов) до уровня 2 («я учитываю, что ты учитываешь мой ход»). В слепом тесте участники не отличали ботов от людей — то есть подстраивались под саму стратегию, а не под ярлык «машина/человек». 🤓Чтобы заглянуть в скрытые рассуждения игрока, авторы построили вычислительную модель CHASE (Cognitive Hierarchy Assessment). Она объединяет идею уровневого мышления (level-k) с байесовским обновлением убеждений: по последовательности ходов модель восстанавливает, каким игрок считает уровень соперника в данный момент, и как он корректирует это убеждение после каждого раунда. Величину такой перестройки («обновление убеждения») формально измеряли через расхождение Кульбака–Лейблера между распределениями до и после раунда. В сканере фиксировали фазу выбора и фазу обратной связи отдельно; нейронные результаты затем воспроизвели на независимой и более разнородной выборке. Основные результаты 1️⃣Поведенчески CHASE описывала выбор игроков лучше всех конкурирующих моделей. Около 79% участников успешно подстраивались под самого сложного бота (уровень 2), а ~78% верно определяли уровень соперника — хотя результативность закономерно падала с усложнением оппонента: каждый лишний шаг рекурсии даётся тяжелее. 2️⃣Момент обновления убеждения о «хитрости» партнёра отзывался в распределённой сети. Если точнее, в билатеральном височно-теменном узле (TPJ), медиальной префронтальной коре и передней островковой доле, с одновременной деактивацией вентромедиальной префронтальной коры. Центральную роль играл именно правый TPJ — причём он отвечал не за какую-то конкретную стратегию, а за само обновление модели собеседника. 3️⃣По одной лишь активности мозга удавалось предсказывать величину текущего обновления убеждения. Соответствие предсказанного и модельного сигнала было очень высоким (r = 0,82 в основной выборке) и сохранялось при переносе на независимую выборку (r = 0,67). Ограничение анализа только «социальным» мозгом снижало точность (r = 0,65) — значит, в вычисление вовлечены и области за его пределами. Иными словами, у адаптивной ментализации есть воспроизводимые нейронные корреляты. 😐Take-home message Чтение другого — непрерывный процесс: мозг постоянно оценивает, насколько глубоко рассуждает собеседник, и переписывает эту оценку с каждой репликой. У такой подстройки есть измеримые нейронные корреляты, прежде всего, в правом височно-теменном узле. Авторы осторожно предполагают, что подобный маркер в перспективе мог бы пригодиться для оценки социального познания там, где ментализация затруднена, — например, при расстройствах аутистического спектра. #исследования@neurons_and_arrows