
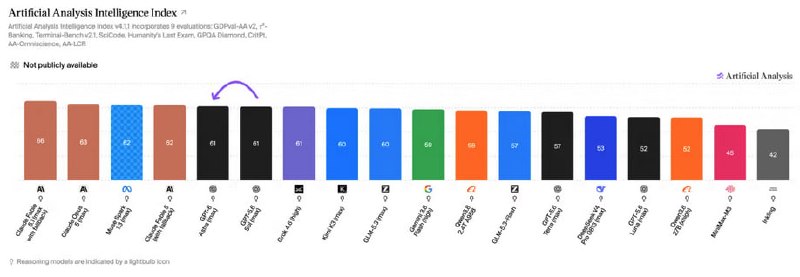
Это очень интересно. На следующий день после бенчмаркинга GPT-6 (Astra) один из ведущих провайдеров мета бенчмарков artificialanalysis.ai изменил методологию оценки возможностей моделей. По версии методологии 4.1 GPT-6 (Astra) соответствовала в среднем по своим возможностям GPT-5.6 (Sol) в режиме усилий max. У обоих моделей было по 61 баллу. В версии методологии 4.2 GPT-6 (Astra) по своим возможностям набрала 55 баллов, а GPT-5.6 (Sol) - 51 балл. В новой версии методологии Astra отстает только от Fable 5.1 по возможностям. Между версиями методологии оценки возможностей 4.1 и 4.2 - прошло меньше месяца. Вывод не изменился - итоги внешних бенчмарков для составления короткого списка на реальный тест, в прод только после реального теста на вашем окружении и с вашими данными.