Официальный канал проекта Data Fusion и comDS — Data Science-сообщества ВТБ 💙
Subscribers5.3K tracking since 13 Nov
Reach per post (ERR)17.8%946 avg views
Posting1.4/weeklast 7 days ago
Reactions per 1K views16.2❤ ❤🔥 🔥
Привет!
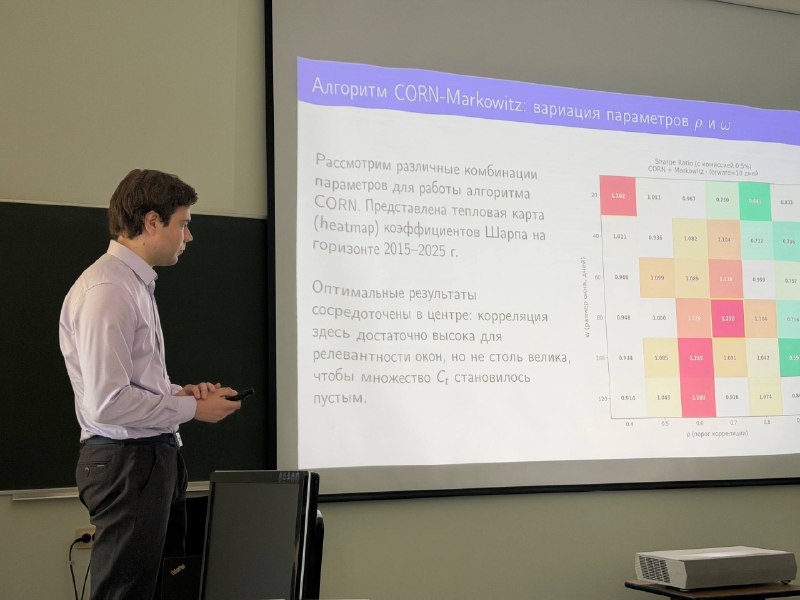
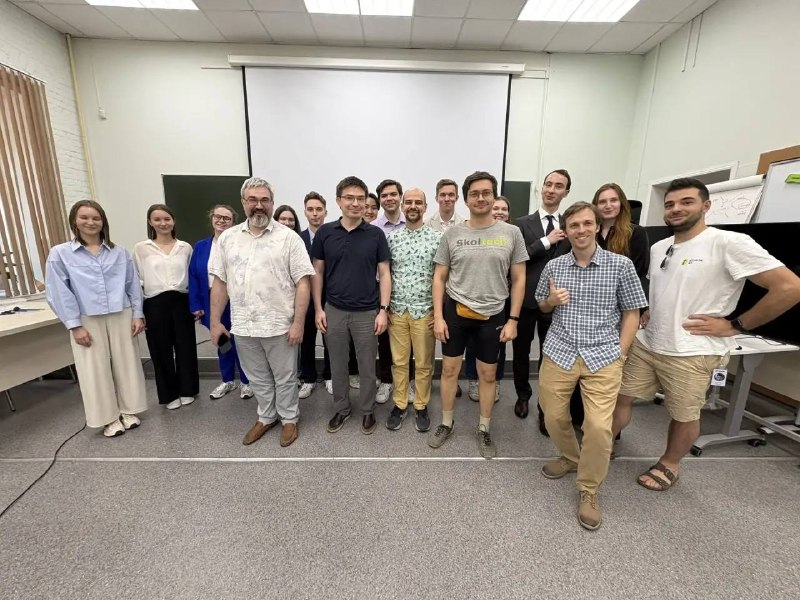
Я Егор Дранов, data scientist в ВТБ, и я защитил свою магистерскую диссертацию🚀
Я и мои сокурсники с магистратуры ИИИИ — программа МФТИ и ВТБ, — представили свои исследовательские работы на научные темы в области ML.
Члены экспертной комиссии внимательно слушали каждую работу и дали свои наставления. В их числе были Константин Вячеславович Воронцов, учёный-математик, д. ф.-м. н. и профессор, и Радослав Нейчев, к.ф.-м.н., автор и преподаватель курсов по машинному обучению.
Всего было 12 работ, 2 из которых поедут на одну из топовых международных конференций по машинному обучению ICML в Сеул.
Для меня это был крутой путь, который удалось пройти благодаря моему научруку и по совместительству тимлиду, Павлу Смирнову.
А в одном из следующих постов я подробно разберу свою работу «Онлайн-обучение в задаче портфельной оптимизации» (PAMR, CORN, нейросети).
Будет интересно!🔥
😎Как измерить культурный код города с помощью big data
Выяснила GeoML-команда ВТБ в рамках спецпроекта с PR. Мы проанализировали исторические районы Петербурга и сравнили, жизнь в городе столетия назад и сегодня — от потребительских привычек до культурных предпочтений жителей.
Что сделали:
Сопоставили транзакции с конкретными районами Петербурга и проанализировали всё: от среднего чека и ритма жизни до интереса к театрам, музеям и книжным магазинам.
1. Геокодировали адреса всех торговых точек и агрегировали данные по границам районов.
2. Посчитали для каждого района: сколько уникальных клиентов совершают покупки в среднем за день, какой средний чек, какие наиболее популярные категории товаров и услуг.
3. Отдельно выделили востребованные сервисы (фитнес, салоны красоты, АЗС), сравнили траты в будни и выходные, а также посмотрели динамику 2024-2025.
4. Добавили культурный срез: книжные магазины, театры, музеи, кинотеатры.
Данные:
1 млрд обезличенных транзакций в квартал + агрегированные скоринговые оценки по возрасту и доходу
Технологии:
Apache Spark и Sedona, которые позволяют обрабатывать такие объёмы геоданных буквально за минуты
Что это дает:
Геоплатформа ВТБ позволяет видеть экономическую и социальную «карту города» в реальном времени, без задержек на месяцы. Это помогает бизнесу, городским властям и всем, кто хочет понимать, как на самом деле живёт район.
Подробнее читай тут и тут 🔥
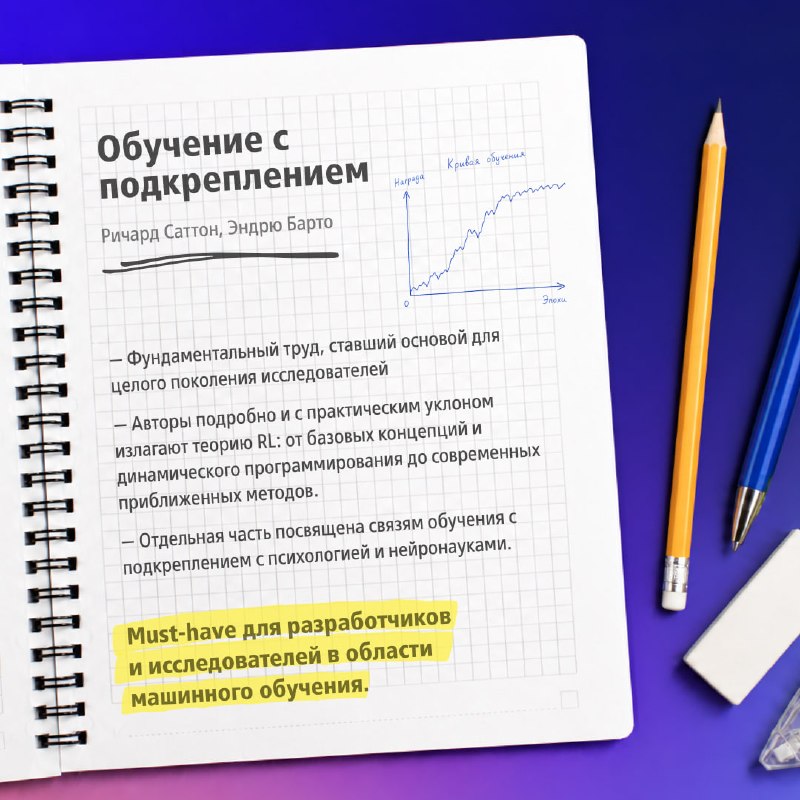
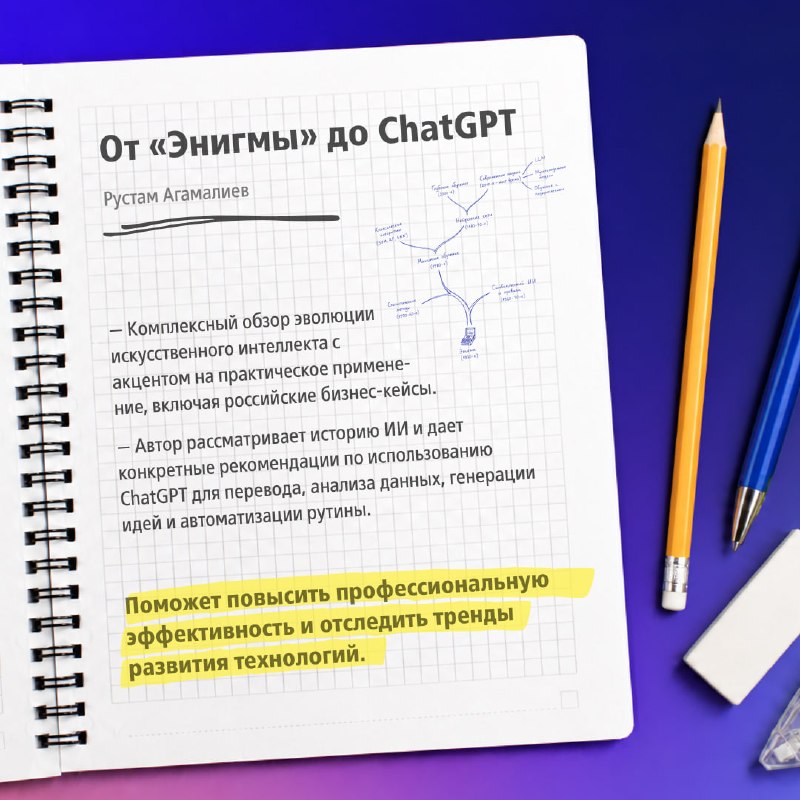
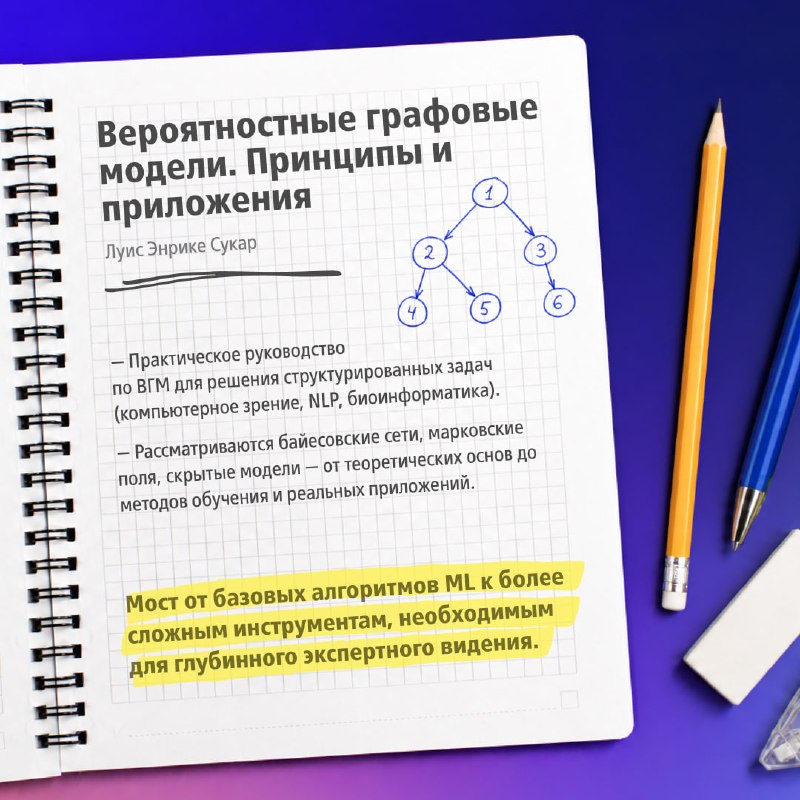
💡Библиотека дата сайентиста
«Что почитать?» — спросили мы у нашего DS лида Алексея Пустынникова.
А он возьми и создай свою библиотеку!
Внутри Департамента анализа данных и моделирования ВТБ Лёша организовал буккроссинг — можно брать почитать понравившиеся книги и делиться своими рекомендациями с коллегами.
Спешим поделиться первой подборкой книг, которые точно пригодятся специалистам Machine Learning & Deep Learning.
➡️ Листай карточки и сохраняй книги в свой must-read
А какие книги по теме ты бы добавил в подборку?
Делись в комментариях!
edited
📃500+ документов и 1 вопрос
Как быстро собрать корректный ответ на вопрос пользователя, если информация распределена по сотням документов?
Василий Сизов, лидер кластера «CRM и клиентский опыт» СМБ, Банк ВТБ, в своём канале разбирает подходы к решению этой задачи — от классического RAG до Agentic RAG.
📌 В посте — карточки с ключевыми инсайтами, а по ссылке внутри полная запись доклада.
➡️ Канал grok ML
📹 Камера, мотор!
Начали снимать новый сезон подкаста Деньги любят техно.
Первый выпуск обещает быть мощным, как и наш гость — Валерий Бабушкин, Senior Director BP «старший главный начальник 😁» (с).
А пока самое время послушать выпуски предыдущих сезонов:
🔵VK Видео
🔵Аудиоверсии
▶️О чём говорили на Data Fest: запись трансляции
24 мая принимали гостей Data Fest у нас на площадке. Было 4 секции и 17 докладов на разные темы, связанные с ML.
Кстати, все доклады можно посмотреть в записи — ориентируйся на расписание и включай понравившиеся доклады.
А мы подробнее расскажем о секции Data Fusion и докладах спикеров ВТБ:
🔵3:08:30 — Василий Сизов, Лидер кластера «CRM и клиентский опыт» (СМБ)
«RAG для комплексных ситуационных вопросов»
🔵3:25:23 — Николай Кравченко, Data Scientist
«Сервис автоматической обработки обращений для среднего и малого бизнеса
🔵4:02:55 — Игорь Жданов, управляющий директор, и Елена Ковылянская, лидер команды Количественные Финансы
«Применение методов ML в системе расчёта контрагентского риска»
🔵4:26:23 — Никита Трифонов, TeamLead DS
«Uplift- модели в акционных предложениях»
edited
А мы начали наш Data Fest! 🚀
Впереди насыщенный день интересных докладов и нетворкинга.
➡️ 4 секции
➡️ 17 докладов
Полное расписание тут
Смотри онлайн трансляцию по ссылке
ЦИПР: что послушать, если работаешь с данными
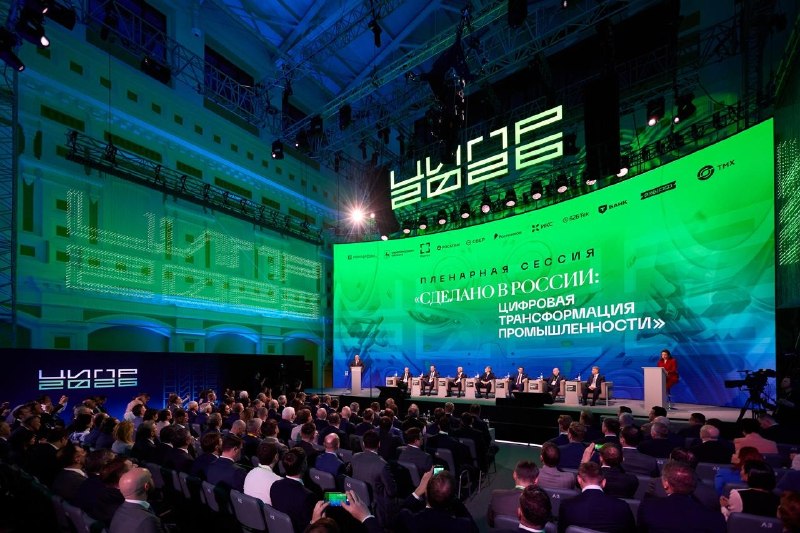
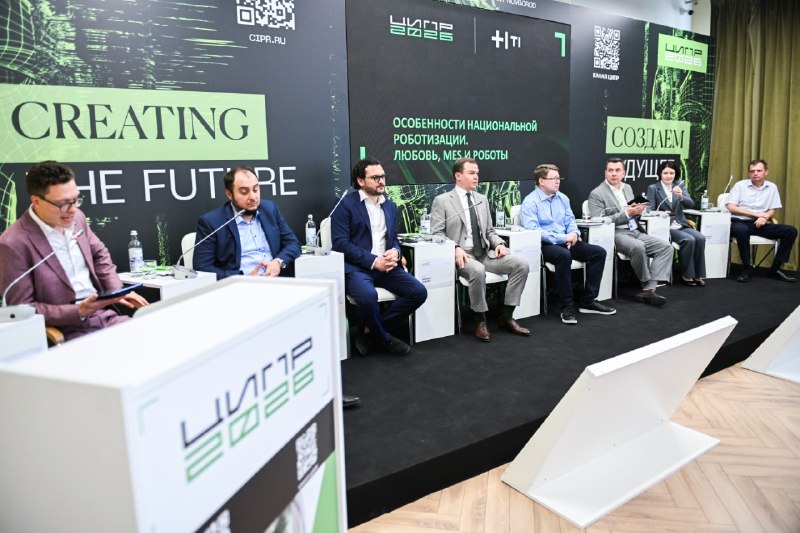
Мы были на ЦИПРе @icipr и заготовили подборку самых крутых сессий (по версии наших DS-ов), которые точно стоит послушать тем, кто работает с данными и ИИ.
🔔Переходи по ссылке, выбирай время и зал и смотри записи трансляций.
🔵18 мая, 14:00 — 15:00 / Зал 8
ЦОДы на пределе. Кто будет развивать инфраструктуру для ИИ
🔵18 мая, 14:00 — 15:30 / Зал 6
Промышленные данные как основа будущей модели развития производства
🔵18 мая, 16:30 — 17:30 / Зал 10
Клетка алгоритмов. Цифровая отмена в экосистемах ИИ
(про рекомендации)
🔵19 мая, 10:00 — 11:00 / Зал 7
ИИ без иллюзий. Технологии для реального сектора
(про ИИ в промышленности и логистике)
🔵19 мая, 11:15 — 12:15 / Зал 2
Экономика ИИ-агентов. Зачем, как и где внедрять эффективно?
🔵19 мая, 11:15 — 12:15 / Зал 6
ИИ как управляемый актив. Почему пилоты не становятся работающими решениями
🔵19 мая, 12:30 — 13:30 / Зал 12
От моделей к машинам. Как превратить исследования в ИИ в технологическое лидерство
Как так вышло, что 71% компаний уже что-то пилят с GenAI, но до реальной эксплуатации доходят лишь 7–10% проектов? Отвечают эксперты, в том числе наш Денис Суржко, вице-президент, зам. руководителя Департамента анализа данных и моделирования Банка ВТБ.
🔵19 мая, 15:00 — 16:00 / Зал 12
ИИ-исповедь. Грехи разработки и внедрения
🔵20 мая, 10:00 — 11:00 / Зал 7
Создание устойчивой отраслевой экосистемы ИИ-креатива в России
(про работу с данными в культуре и креативных индустриях)
🔵20 мая, 12:30 — 13:30 / Зал 1
Почему «умное производство» не дает эффекта
(про фрагментированные IT-системы)
🔵20 мая, 13:45 — 14:45 / Зал 4
Между лабораторией и рынком. Как преодолеть барьер внедрения наукоемкого ИИ
🚀Зачем участвовать в хакатоне и как к нему подготовиться?
В прошлом посте обещали поделиться советами по подготовке к хакатону по теме ИИ.
Обещали — возвращаемся!
Отвечает Елена Куренкова, MLOps ВТБ:
Хакатон – это возможность в моменте создать рабочее решение конкретной интересной задачи. А еще это возможность пообщаться с интересными людьми и перенять опыт друг друга.
Как сделать этот опыт более эффективным?
1. Разберись в теме хакатона до хакатона
Читай описание заранее: тематику, примерное задание, требуемые методы. Если ты совсем не в теме — это пустая трата времени.
2. Подготовь универсальный код заранее
Собери часто используемые скрипты: шаблоны для анализа данных, предобработки, визуализации. На хакатоне время ограничено, и переписывать одно и то же с нуля не имеет смысла. Готовый код экономит часы.
3. Послушай экспертов и задай вопросы
Если на хакатоне есть выступления, особенно от членов жюри, слушай внимательно и уточняй детали. Многие участники не до конца понимают задачу и делают не то, что нужно. Вопросы помогают этого избежать.
4. Собери команду с разными компетенциями
Если можно выбрать команду самим, бери людей с разными навыками: один ищет данные, другой их анализирует, третий строит модель. Кто-то поможет собрать это в презентацию, а кто-то без запинки представит решение жюри. Команда, где участники дополняют друг друга, работает эффективнее.
Ставь реакцию, если участвовал в хакатоне 💙
Какие бы советы еще добавил? Пиши в комментариях
🚀Хакатоним на Весенних школах
— образовательном проекте ВТБ и НИУ ВШЭ.
100 студентов из 43 вузов решают реальную бизнес-задачу, а эксперты ВТБ — Юлий Шамаев, Елена Куренкова и Алексей Пустынников выступают в роли наставников.
Ребята погружают участников в кейс по геоаналитике, дают рекомендации и оценивают решения.
➡️ участникам опыт и наставничество от экспертов
➡️ нам свежий взгляд и новые нетривиальные идеи
В следующем посте поделимся рекомендациями, как извлекать из участия в хакатоне максимальную пользу💡
🔥Как мы провели майские
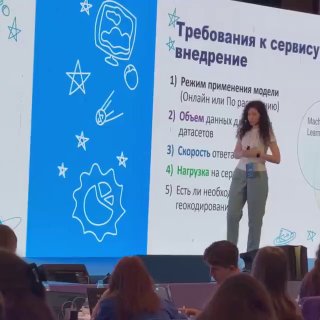
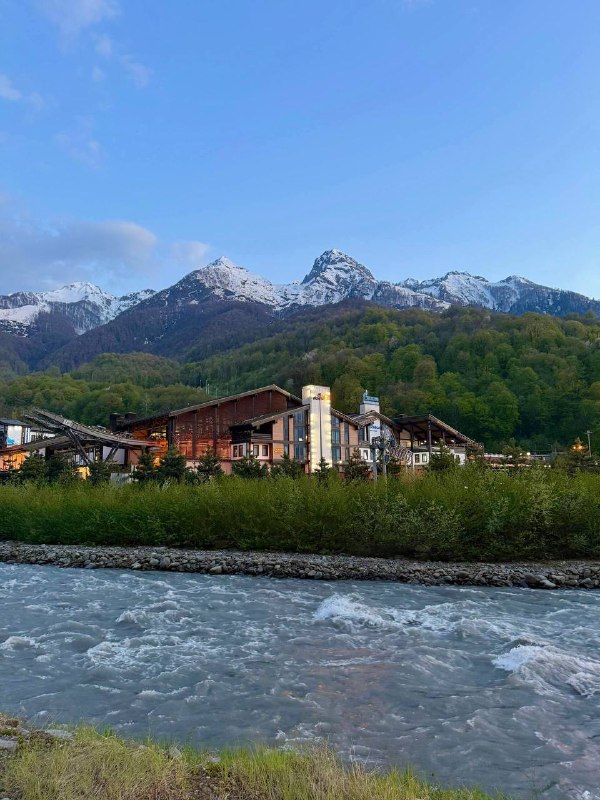
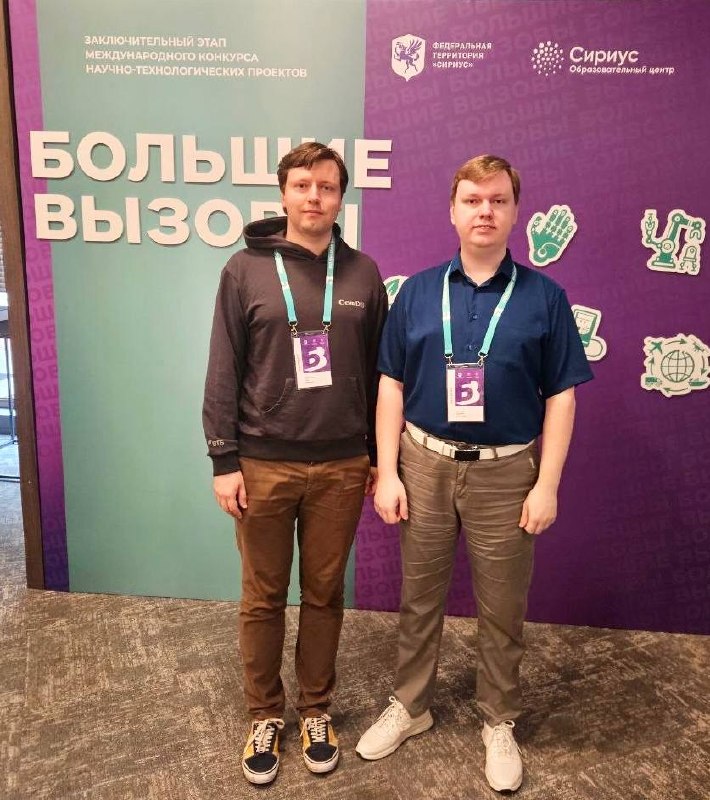
Пока все отдыхали на майских, наши DS-ы отправились в Сочи – в образовательный центр «Сириус».
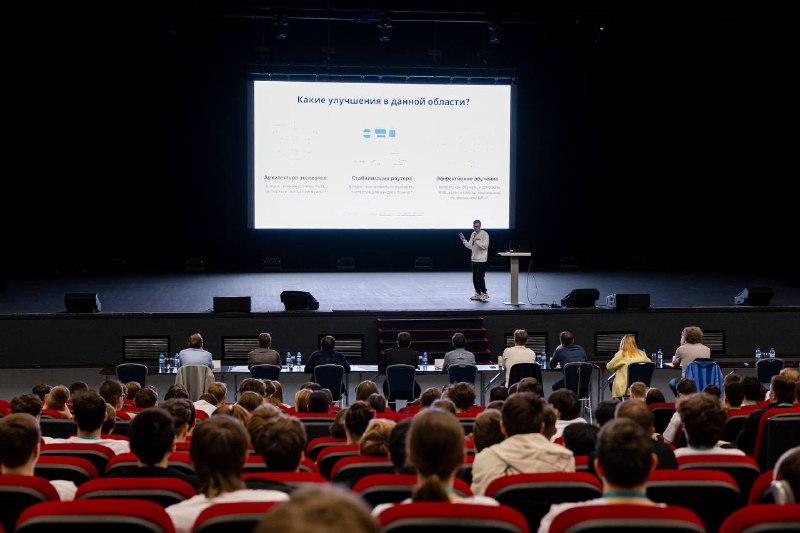
Даниил Ушаков, Алексей Пустынников и Лев Меркушов вошли в экспертное жюри конкурса «Большие вызовы», где школьники 7–11 классов из России, Казахстана и Таджикистана защищали свои научно-технологические проекты. Четверть проектов прошла в финал конкурса, который состоится в июле.
Главное наблюдение — поколение альфа уже вовсю живет в мире ИИ. Ребята активно используют вайбкодинг и собирают сложные решения быстрее, чем их предшественники несколько лет назад.
Благодаря ИИ ребята меньше времени тратят на рутину и больше на идеи, исследования и реальные прикладные задачи.
Главный тренд – технологии становятся доступнее, а уровень проектов — выше.
Для наших экспертов участие в таких проектах — это возможность увидеть, как быстро меняется новое поколение и какие вызовы школьники уже готовы решать самостоятельно.💙
edited
Ждём тебя на Data Fest 2026 в гостях у ВТБ!
По традиции, каждый конец мая мы с DS-специалистами собираемся на Data Fest.
В этом году — 24 мая в Loft Hall на Автозаводской.
В программе:
🔹 Data Fusion (сессия от DS-команды ВТБ) — RAG, uplift-модели и ML в управлении рисками
🔹 Open Career — о карьере в DS
🔹 Mathematics & ML — исследовательская секция для настоящих математиков
🔹 ML in Advertising — ML в маркетинге и рекламе
А ещё интерактивы с призами и крутой нетворкинг.
Подробнее о спикерах и докладах будет позже на странице мероприятия.
📌 Регистрируйся по ссылке, указывай свой опыт в DS/ML и жди подтверждение на почту.
⏰ 24 мая с 11.00 и до вечера
📍ул. Ленинская Слобода, 26, стр. 15 (Loft Hall, зал Ratusha)
edited
📃Как в ВТБ обрабатывают сложные клиентские обращения?
Редко, когда в поддержку поступает один конкретный вопрос, обычно это сразу несколько тем, которые нужно проанализировать и дать ответ, не теряя при этом ни секунды.
Как это сделать, — отвечает Дмитрий Тимохин, лидер команды ML CRM в Банке ВТБ.
Дима рассказал, как DS-команда создала сервис для анализа и категоризации таких обращений в корпоративном инвестиционном бизнесе.
Система определяет тип запроса, фиксирует смену тематики, делает суммаризацию и раскладывает обращение по нескольким уровням и классам.
➡️Подробнее смотри в видео
💡«Бесконечная Полка» — RecSys-модель для ранжирования банковских продуктов
Недавно мы проводили опрос и узнали, что вы хотите видеть больше полезных кейсов в канале.
А нам как раз есть, чем поделиться!
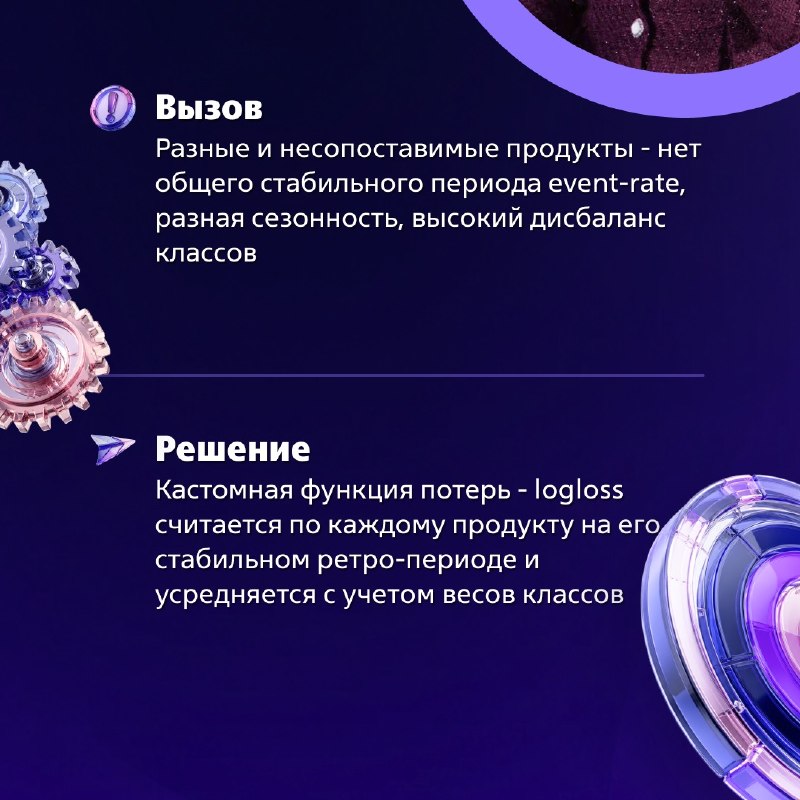
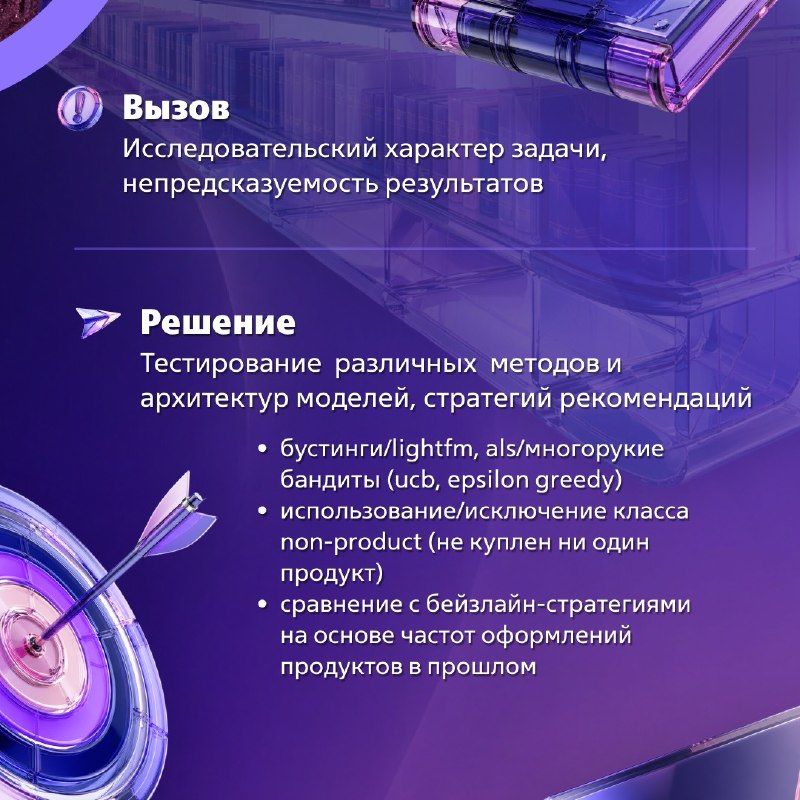
Анна Ширшова, Lead DS ВТБ, рассказала, как за 3 года превратить рекомендательную систему в автообновляемую модель, которая ранжирует 58+ банковских продуктов для разных сегментов клиентов и каналов.
📌Ключевое — в карточках, а полный кейс смотри по ссылке
▶️Время наверстать упущенное
Плотная программа, параллельные сессии и топовые спикеры — жаль, нельзя охватить всё!
Хотя почему нельзя?
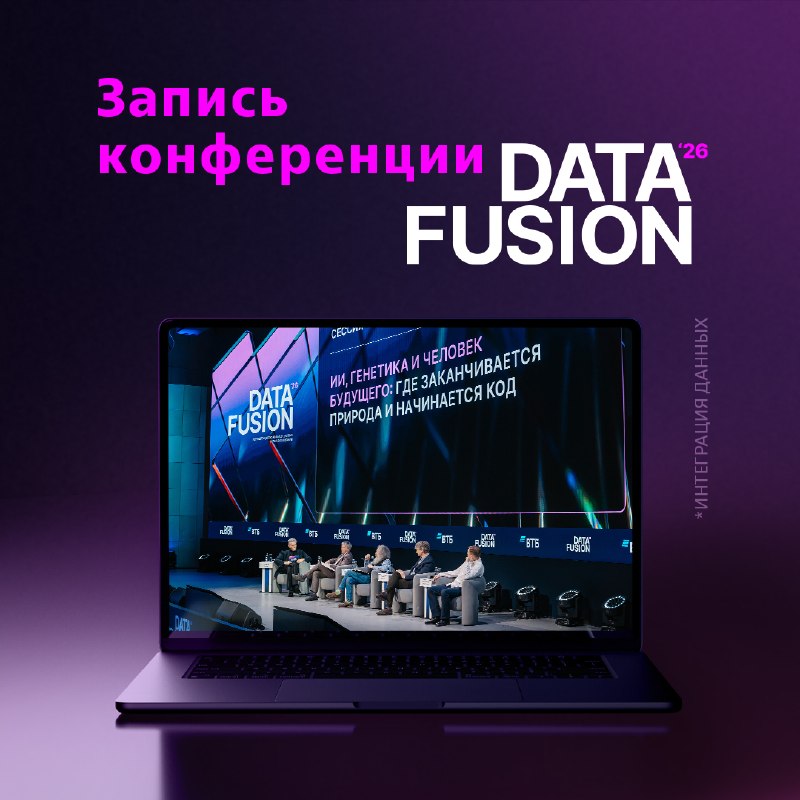
Мы загрузили записи трансляций с Data Fusion — более 90 часов полезного контента, к которому можно возвращаться в любое время.
Переходи в плейлист, смотри и сохраняй понравившиеся сессии.
Теперь точно есть, чем заняться на майские!🔥
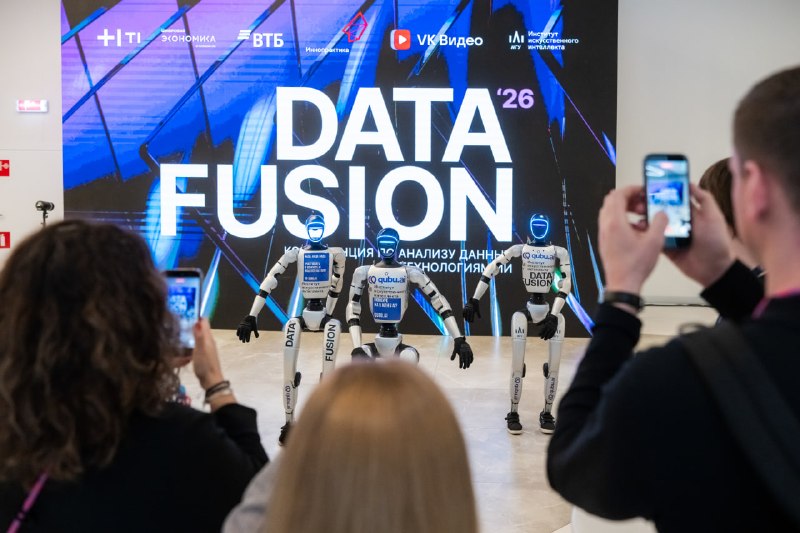
⚡Вы ждали — фотки с DF!
Воспоминания о Data Fusion 2026 начинают постепенно стираться... не дадим этому случиться!
Листай фотоальбомы в нашем сообществе ВКонтакте, чтобы вновь прочувствовать ту атмосферу, ищи себя и забирай лучшие кадры😎