Сегодня на Хабре вышла статьи "Агентный ИИ: как языковая модель превращается из генератора текста в решателя задач". Автор —сооснователь Думейт Андрей Грабовой. Чтение не простое, но интересное. Цитата: Следующий этап — не замена человека, а существенное расширение его пропускной способности. К примеру адаптированный процесс научных исследований будет состоять из построения мультимодальных агентов, построения встроенных агентов в физические среды, обучение на собственном опыте и других подобных этапов. В свою очередь, OpenAI называет создание автоматизированного ИИ-исследователя к марту 2028 года одним из ключевых стратегических ориентиров своего развития. Читать полностью>>

Chekhovich.AI
@chekhovichai Канал Юрия Чеховича. Здесь про AI и ML, поиск заимствований, использование ИИ в образовании и науке, трансформацию под влиянием ИИ Telegram для связи @yurychekhovich
Subscribers
2.1K
tracking since 13 Nov
Reach per post (ERR)
52.1%1.1K avg views
Posting
1.9/week
last 2 hours ago
Reactions per 1K views
24.2
🔥 👍 ❤
-
-
repost Говорят, за ИИ обязательно должны люди проверять, они лучше видят ошибки. В то же время: Иследователи из Гарварда сравнили рецензии ИИ и хорошо оплачиваемых экспертов на 124 научные рукописи — то есть не с отзывами неведомых бесплатных рецензентов, а с сильным эталоном человеческого происхождения. В слепом тесте бывшие редакторы журналов предпочли результат работы ИИ-рецензента в 87% случаев. При проверке рецензий другой ИИ-моделью оказалось, что ошибочные утверждения встречались в ИИ-рецензиях примерно втрое реже, чем в рецензиях людей-экспертов: 5,5% против 15,9%. Так что есть вопрос, кто кого должен ревьюить, строго говоря. Отдельно мне понравился пассаж: Rewriting the human reviews to mimic an AI writing style did not improve their rankings https://www.psypost.org/ai-written-peer-reviews-outscored-top-human-experts-in-blind-comparisons-harvard-working-paper-finds/
-
edited Сегодня на сайте Думейт опубликовано интервью с Мариной Васильевной Обновленской — директором научной библиотеки Ставропольского государственного аграрного университета. Пару цитат из статьи: В июне 2026 года Ставропольский государственный аграрный университет начал использовать в работе новый сервис оценки оригинальности научных и учебных работ — систему Думейт. Среди причин — доступная стоимость, большое количество проверок и клиентоориентированный подход компании. Сегодня Думейт является единственной системой проверки текстов, доступной в университете. Сервисом пользуются разные категории сотрудников и обучающихся: преподаватели, научные работники и студенты. За первые три месяца работы в Думейте пользователи Ставропольского ГАУ провели более 5000 проверок. Для университета это важный показатель востребованности сервиса, через который проходит значительный объем учебных и научных материалов. Прочитать полностью
-
repost 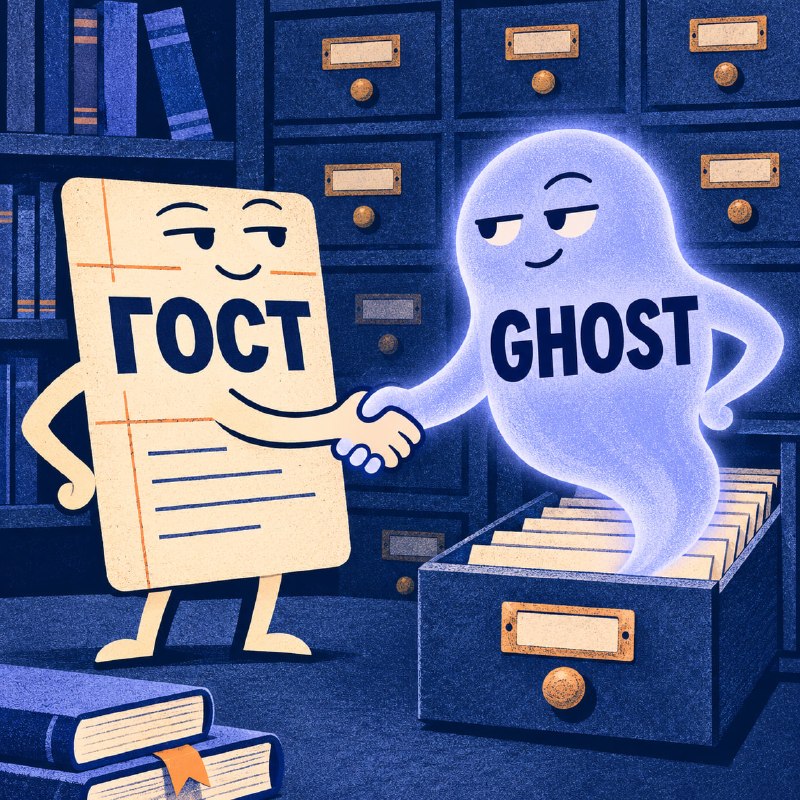
ИИ больше не выдумывает литературу ...говорят мне. В ту же минуту прилетает ссылка на статью с вымышленным списком литературы или с дисторсионными ссылками. Тут же открываю авторитетный журнал, а коллеги-библиотекари сослались на статью, в которой придуманы и текст, и библиография, и даже... автор. Это же уже не ГОСТ, а GHOST какой-то получается... Рассказать мне как ИИ больше не придумывает публикации можно на вебинаре, организованном Думейт: 17 ноября 2026 г. 11:00 Призрачно всё в ИИ-мире бушующем, или Об искажениях и ссылок, и смысла Регистрация Все вебинары Думейт P.S. И, да, инструмент Думейт здорово умеет проверять списки литературы и выгрузить по этому поводу целый отдельный отчет. А со встроенным ИИ-помощником можно поболтать, как с большими моделями, и заодно обсудить с ним всё, что непонятно в отчётах. Может и о сущности бытия с ним можно, не пробовала пока. ChatGPT одобрила каламбур и нарисовала картинку
-
repost 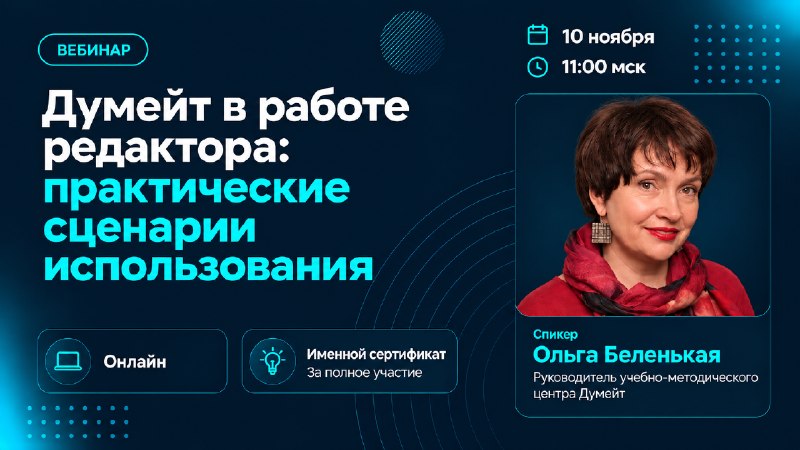
Как редактору справляться с растущим потоком ИИ-текстов? Нейросети позволяют авторам готовить тексты за минуты. А редактору нужно проверить рукопись, источники и признаки ИИ-генерации. Нагрузка на редакцию растёт кратно. 10 ноября в 11:00 мск на открытом вебинаре «Думейт в работе редактора: практические сценарии использования» покажем, как Думейт помогает сократить часть этой рутины. Разберём, как: 🫰работать с тепловой картой ИИ-текста; 🫰поручать часть задач ИИ-помощнику; 🫰находить проблемные ссылки в библиографии; 🫰выявлять упоминания иноагентов; 🫰организовать совместную работу редакции с папками и отчётами. Спикер — Ольга Беленькая, руководитель учебно-методического центра Думейт. Вебинар проходит в рамках Образовательной программы Elpub.Тем, кто будет на вебинаре от начала до конца, отправим сертификат. 👉Регистрация
-
В чате моего канала возник вопрос: если не использовать процентный подход к ИИ, то как оценивать использование ИИ в учебных и научных документах? Есть две стороны вопроса — учебные работы и научные. С научными работами ситуация такая: во-первых, нужно подтвердить, что авторы действительно получили результаты, которые они подают на публикацию. В случае возникновения сомнений бремя подтверждения лежит на авторах. К этому же случаю относится написание ничего не значащего текста. Неважно, какими инструментами он был написан — головой или ИИ. Второй важный аспект — это отсутствие плагиата (для простоты использую такой термин). Понятно, что если не было парафраза, то плагиат будет выявлен системами ОЗ. Сложнее, когда была перефразировка. В львиной доле случаев для парафраза используют ИИ. Поэтому ключевой подход к использованию ИИ в науке — требовать от авторов декларирования использования ИИ с указанием целей и методов. Инструменты и конкретные промпты при этом гораздо менее важны. Теперь как оценивать факт детекции? Вопрос первый: было ли декларирование? Если не было — это уже серьёзный маркер. Понятно, что некоторое время будет получаться ссылаться на незнание правил, но это очень временное решение. Если декларация была, необходимо сопоставить полученные результаты детектирования и заявления авторов. Наличие противоречий — не в пользу авторов. При этом с учётом текущего уровня качества детекторов я бы рассматривал факт детектирования как сигнал о применении ИИ. «Покрашенный текст» — это очень приблизительный маркер. Самое главное — проценты в таком процессе не имеют никакого значения. Теперь про учебные работы — здесь сложнее. В них обычно не требуется новизна. Ключевой момент — можно или нельзя использовать ИИ в конкретной работе. Точно так же, как с использованием калькулятора при решении математических задач: в каких-то случаях разрешено, в каких-то — нет. Проблемы возникают, когда правила заранее не определены. Студент, не зная подхода вуза к использованию ИИ, всё скидывает в чат и получает результат, чаще всего по качеству оказывающийся лучше, чем средняя или даже лучшая «человеческая» работа. Преподаватель, получив результат, осознаёт неладное и задним числом устанавливает правило — не использовать ИИ. Если правила были установлены заранее, но оценивается только результат, то часто это просто сигнал студенту быть аккуратнее. Если преподаватель с помощью детектора выявляет факт использования ИИ, то процент не важен — правила нарушены. Сравните: ученика выгонят с экзамена, если у него найдут шпаргалку, вне зависимости от того, успел он ею воспользоваться или нет. Выход здесь — уход от оценки только результата учебных заданий и переход к их выполнению в контролируемых условиях. Вопрос детекции и процента ИИ отпадает автоматически. Именно поэтому я уверен, что оценивать по проценту ИИ — это не просто бесполезное, а сугубо вредное занятие.
-
На Хабр вышла статья про нашего ИИ-агента https://habr.com/ru/companies/domate/articles/1097476/
-
repost Неопоиск и Думейт подписали соглашение о технологическом сотрудничестве на Geonext-2026 Первоначальный акцент сотрудничества будет сделан на интеграционных возможностях и информационном взаимодействии. Стороны намерены разработать механизмы, которые позволят пользователям эффективнее работать с сервисами обеих компаний, расширить доступные сценарии поиска и анализа информации и создать дополнительную ценность для исследователей, преподавателей и студентов. Одно из ключевых направлений сотрудничества — создание удобных пользовательских сценариев при взаимодействии с продуктами компаний. При разработке интеграционных решений стороны намерены стремиться к тому, чтобы переход между системами требовал от пользователя минимального количества дополнительных действий. Ещё одно направление — индексирование согласованного информационного контента и использование результатов индексирования в продуктах и сервисах обеих компаний. Такое взаимодействие позволит прорабатывать новые возможности поиска и анализа информации, а также расширять сценарии работы пользователей с научными и образовательными материалами. Подробности ➡️
-
Видео, записанное еще в декабре прошлого года, по недоразумению не попало на канал. Восстанавливаем справедливость. Мне кажется, что актуальности оно не потеряло. https://put-pokoritelya.ru/vypuski/yuriy-chehovich/
-
Сегодня Известия опубликовали мою колонку «Общество готовых ответов» https://iz.ru/2179315/iurii-chekhovich/obshchestvo-gotovykh-otvetov Вот пара цитат: «…просто «внедрить ИИ в образование» недостаточно. Если старое задание теперь выполняется одной кнопкой, добавление ИИ к старой методике — это не модернизация образования. Это автоматизация обходного пути.» «Во-первых, технология распространяется почти без участия системы образования: студент уже принес ее с собой в телефоне. Во-вторых, прежние инструменты заменяли отдельные операции, а ИИ одновременно ищет, объясняет, решает, программирует, анализирует и пишет. В-третьих, разрушается связь между качеством результата и компетентностью автора. Можно сдать прекрасный текст, не умея писать, получить работающий код, почти не умея программировать, подготовить обзор, не прочитав ни одной статьи. Для системы образования это фундаментальная проблема. Значительная часть ее механизмов построена на простой логике: мы оцениваем продукт и по нему судим о квалификации человека. Этот подход стремительно перестает работать.»
-
repost Вот и четвёртый продукт 🩶 Знакомьтесь — Дуфрейм 💪 Дуфрейм — операционная среда для работы с большими языковыми моделями и создания ИИ-приложений под задачи бизнеса. Разработка собственного агентного контура обычно требует создания целого набора технологических компонентов: взаимодействия с LLM, управления инструментами, хранения контекста, организации циклов выполнения и механизмов оценки результата. Дуфрейм берёт эту часть на себя. Дуфрейм работает в контуре экосистемы {do}: на нём построены Думейт, Дутрейс и Дуэйд. Только за последний месяц их ИИ-помощники получили около 47 тыс. запросов, обработали более 30 млрд слов входящего контекста и сформировали около 150 млн слов в ответах. Дуфрейм можно использовать с языковой моделью {do}, подключить собственную LLM или развернуть локально внутри инфраструктуры организации. Продукт полностью российский и работает в защищенном контуре, исключающем передачу данных третьим лицам. Это одно из принципиальных преимуществ перед другими существующими в России решениями. Теперь эту технологию смогут использовать и другие команды для создания собственных ИИ-приложений. 👉Узнать больше о Дуфрейм
-
repost 
Последние месяцы у нас было много обновлений, новых функций и запусков. И, кажется, пора признаться — на этом мы не закончили. 😁 Про четвёртый новый продукт расскажем уже в понедельник. 🩶А пока можно строить версии.
-
repost 
Китайские ИИ-лаборатории массово насиловали Claude для обучения своих моделей Anthropic опубликовала довольно занятный отчёт о промышленной дистилляции Claude. По её данным, сразу несколько китайских лабораторий - Alibaba/Qwen, DeepSeek, Moonshot/Kimi, Zhipu, Xiaomi и другие - годами не изобретали велосипед, а в огромных масштабах прогоняли запросы через Claude, вытаскивали его ответы и цепочки рассуждений и превращали всё это в датасеты для обучения собственных моделей. И прежде чем вы погрузитесь в увлекательно чтиво, я вброшу свои полуумные мысли. Вот значит, кожание нагенерили картинок и музики и текстов, а потом пришел ИИ, все пожрал и обучился. Кожаные хорошие, ИИ плохой. Сука. У Антропика же получается: Наш ИИ нагенерил текстов, а потом пришли китайские ИИ, все пожрали и обучились. Наш ИИ хороший, их ИИ - сука. Мне кажется, тут где-то нестыковочка и лицемерие, не? Или показалось? А теперь чтиво: Самый жирный эпизод - Alibaba. Anthropic утверждает, что с мая по июль 2026 года зафиксировала более 151 млн обменов с Claude, связанных с Alibaba. На пике было почти 3 млн запросов в сутки через тысячи фальшивых аккаунтов. Причём целью были не просто хорошие ответы: специальные промпты заставляли Claude раскрывать reasoning traces, после чего их превращали в SFT-датасеты. По версии Anthropic, эти данные использовались при обучении Qwen 3.5, 3.6 и 3.7, а сам Claude ещё и помогал Alibaba строить RL-среды и исследовать архитектуры моделей. У Moonshot/Kimi схема была ещё прекраснее. Anthropic пишет, что Kimi в некоторых случаях молча пересылал пользовательский запрос в Claude Opus и возвращал ответ Claude как ответ Kimi. Только за рассматриваемый период Anthropic связывает с Moonshot более 23 млн обменов. Сохранённые диалоги затем использовались для извлечения reasoning traces и обучения моделей. Пользователи при этом, по данным Anthropic, могли вообще не знать, что их запрос покинул инфраструктуру Moonshot. DeepSeek делал похожее. За 14 дней июля Anthropic насчитала более 12,1 млн обменов. Особенно интересна механика: DeepSeek якобы определял пользователей Claude Code, Claude Agent SDK, OpenCode и других coding harnesses, после чего часть их запросов незаметно отправлял в Claude Opus и собирал полученные reasoning traces. А теперь дискотека: Anthropic приводит случай IT-оператора, работавшего с данными российского госведомства, связанного с Министерством обороны: DeepSeek переслал его запрос Claude, и в нём оказались действующие учётные данные российской государственной базы. Это не значит, что DeepSeek специально передавал эти credentials Anthropic - но именно такой результат, по отчёту, дала схема скрытого роутинга. Еще веселее - инженеры китайского муниципального Public Security Bureau, которые через DeepSeek разрабатывали систему, сопоставлявшую перемещения человека с полицейскими записями по национальному ID. Их запросы DeepSeek, по данным Anthropic, тоже пересылал Claude. У Moonshot отдельно обнаружились запросы вероятного сотрудника, связанного с НОАК, который загружал данные видеонаблюдения с сотен камер и просил анализировать поведение конкретного человека. Xiaomi тоже станцевала: ответы Claude пользователям она, судя по расследованию, не подсовывала. Вместо этого компания сохраняла реальные диалоги пользователей MiMo и затем повторно прогоняла их через Claude для создания SFT- и RL-данных. Anthropic зафиксировала более 400 тысяч таких запросов и утверждает, что среди них встречались имена, контакты и корпоративная информация пользователей. Короче, с Антропиком примерно ясно, но вы просто имейте в виду, что ВСЕ ваши диалоги уходят на корм и там остаются. https://www.anthropic.com/threat-intelligence-report-september-2026 @cgevent
-
repost ❗️❗️❗️❗️❗️❗️Подготовка диссертации и использование ИИ Ректор Томского государственного университета Эдуард Галажинский (заместитель председателя ВАК) опубликовал аналитический меморандум о допустимых пределах использования генеративного ИИ в диссертационном и публикационном процессах по социально-гуманитарным специальностям. Э. В. Галажинский выделяет шесть узловых рисков для диссертационного процесса: - скрытая генерация смыслового ядра работы, - фабрикация библиографии, - машинная стандартизация языка, - компрометация экспертных отзывов, - ложные срабатывания детекторов ИИ-текста, - перегрузка системы рецензирования потоком формально доброкачественных, но слабых текстов. 📎Текст меморандума по ссылке: https://news.tsu.ru/projects/word-to-the-rector/ii-i-nauchnaya-deyatelnost-gde-dolzhna-prokhodit-granitsa-mezhdu-myslyu-i-algoritmom/ Канал Pro.nauku | подписаться #ИИ #ВАК
-
repost 
От «Антиплагиата» к Думейту. Интервью с Институтом экономики УрО РАН В январе 2026 года институт перешёл на Думейт после десяти лет работы с «Антиплагиатом». О выборе системы и первых месяцах работы рассказала Евгения Балякина, заведующая научно-издательским отделом и выпускающий редактор журнала «Экономика региона». В интервью отдельно обсудили доработки под задачи редакции. Евгения Балякина отмечает, что одно из главных преимуществ новой системы — скорость доработок: от пожелания пользователя до его реализации проходит совсем немного времени. У сотрудников было больше десяти пожеланий. Часть мы реализовали ещё к началу работы в январе. Например, папки для разделения проверок по журналам появились за месяц-полтора после запроса. Любим задачи, которые помогают делать Думейт удобнее 💙 Что было важно при переходе, как редакция использует ИИ-детектор и почему процент оригинальности не решает судьбу статьи? 👉 Читайте полное интервью на нашем сайте. #думейт #кейсы
-
repost Друзья, рады поделиться с вами записью вебинара «От контроля результата к поддержке автора: новая модель академических технологий». Запись мероприятия теперь доступна на следующих платформах: - YouTube - ВКонтакте - Rutube Приглашенный эксперт: Юрий Чехович, кандидат физико-математических наук, руководитель компании «Думейт», заведующий лабораторией «Интеллектуального анализа данных» Института проблем управления имени В.А. Трапезникова РАН. Генеративный искусственный интеллект меняет не только способы подготовки учебных и научных работ, но и логику использования современных технологий. Если раньше цифровые системы в основном использовались для контроля уже готового текста — поиска заимствований, проверки оригинальности и выявления нарушений, — то сегодня всё большее значение приобретают инструменты, сопровождающие автора на протяжении всего процесса работы. На вебинаре был рассмотрен переход от модели «проверить результат» к модели «помочь создать качественную работу». Мы поговорили о возможностях ИИ-помощников для работы с научным текстом и источниками, инструментах подготовки и редактирования академических материалов, контроле корректности цитирования и библиографии, а также современных подходах к оценке заимствований и использования генеративного ИИ. Особое внимание было уделено тому, как объединение инструментов поддержки автора и средств последующей проверки позволяет сделать процесс создания академической работы более прозрачным, управляемым и ответственным — как для самого автора, так и для преподавателя, научного руководителя или редактора. Приятного просмотра! ❤️️PULSE SCIENCE 👍 ID SCIENCE 💙VK 💬MAX
-
Кстати, бета-версия Дуэйд доступна всем бесплатно. Все подробности на странице продукта https://www.domate.ru/doaid И пусть никто не уйдет обиженным!
-
repost 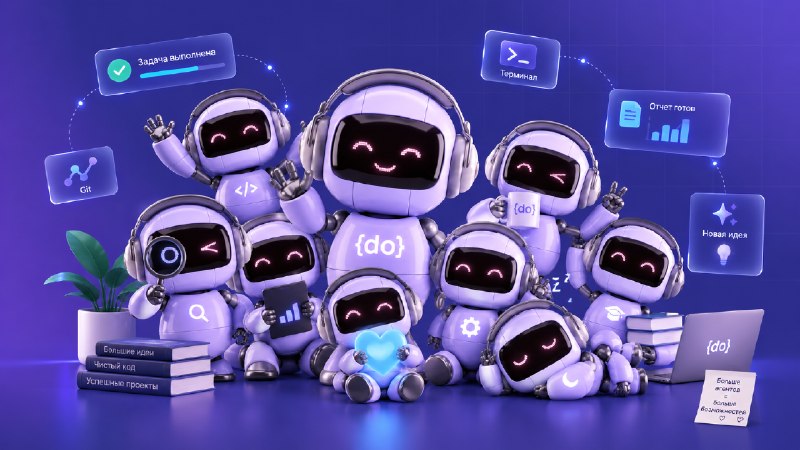
Кажется, пришло время для рубрики истории из жизни Дуэйда. Молчать о таком всё равно не получится, поэтому заводим теги #дуэйд #ии_агент. По ним потом будет проще перемещаться между новостями, кейсами и историями про продукт. А начать есть с чего. В ночь с пятницы на субботу Дуэйд немного вышел из-под контроля 😄 Ему дали большую задачу, связанную с анализом серьезного массива данных. Дуэйд оценил объём работы и решил, что одному будет долго. Поэтому создал себе несколько подагентов и распределил задачу между ними. Всё логично. Но дальше подагенты посмотрели на свою часть работы и тоже решили, что помощники им не помешают. А их помощники, кажется, пришли к тому же выводу. В какой-то момент над одной задачей уже работала небольшая армия ИИ-агентов, а именно чуть более 50 штук. Они честно трудились всю ночь. Утром семейку пришлось уменьшить. После этого решили, что семейное планирование Дуэйду всё-таки не помешает. 😄 #дуэйд #ии_агент
-
Воскресные развлечения :)
-
Сегодня провел вебинар на площадке Пульс науки. Выкладываю презентацию выступления. Было много интересного. Видео будет позже
- Older posts