Stack Overflow Developer Survey 2026: опрос уже сам стал картой агентной разработки (Рубрика #AI4SDLC) Недавно полчаса заполнял новый большой опрос Stack Overflow (он стартанул 23 июня 2026 года и все еще доступен для прохождения). Я шел туда не столько за привычным набором "языки, базы, IDE", сколько из любопытства: что Stack Overflow в этом году спрашивает про AI. И там хорошо виден сдвиг - это уже не про чаты или автодополнение, а попытка измерить, как AI и агенты входят в производственную систему разработки (примерно про то же было и в недавном пульс-опросе от StackOverflow, что я разбирал). Если говорить про сам опрос, то теперь его вопросы можно найти в репо на GitHub (это супер-круто). И если туда заглянуть, то AI больше не выглядит отдельной секцией в конце анкеты. И хоть выделенный блок AI + AI Agents присутствует, но сами AI-вопросы расползлись и в технологии, и в сообщество, и в knowledge/context. Stack Overflow спрашивает не только про инструменты, а про доверие, контекст, атрибуцию авторства, стоимость, память, контроль, наблюдаемость и задачи, которые люди реально делегируют агентам. Если попробовать описать диффы подробнее и по пунктам, то выйдет так 1️⃣ Уходим от одного монолитного "AI adoption" к разным типам AI в работе Вопрос `AISelect` отдельно разводит кодинговых асситентов и кодинговых агентов, чаты общего назначения, AI агентов для автоматизации рабочих процессов и внутренние AI-инструменты компании. Дальше идут частота использования, доля рабочего дня, количество разных AI-инструментов за неделю и причины переключения между ними. Для AI4SDLC это важное разделение: у чата рядом с человеком, кодинг агента в IDE и внутреннего enterprise-инструмента разные права доступа, риски и способы проверки результата. 2️⃣ Сдвиг в сторону агентной разработки Вопрос `AIWork` раскладывает workflow по сценариям: архитектурное исследование, генерация кода в знакомой и незнакомой области, onboarding в кодовую базу, дебаг/рефакторинг, тесты, ревью, безопасность, документация, внутренняя база знаний, анализ логов и метрик, тикеты/планы, dev/test среды и прод системы. Для каждого сценария спрашивают не только текущее использование, но и ожидание на следующий год. Рядом есть еще более конкретный вопрос из блока knowledge/context: какие задачи за последние 30 дней вы делегировали AI инструментам или агентам со списком вариантов: код, дебаг, ревью кода, тесты, документация, архитектурные решения, планирование, изменение прод систем, развертывания, мониторинг, расследование инцидентов, безопасность/приватность/комплаенс, аналитика данных и координация между командами. Кажется, что здесь ребята пытаются оценить куда сейчас люди готовы пустить работать агента:) 3️⃣ Инструменты уже рассматриваются как стек - Отдельно спрашивают про кодинг агентов и/или ассистентов: Claude Code, Cursor, OpenAI Codex, GitHub Copilot, Devin, Jules, Warp, Cline, Aider и длинный хвост новых игроков - Отдельно - no-code agent builders, automation, orchestration/frameworks, memory/vector databases и observability/evals tooling: LangGraph, OpenAI Agents SDK, LangSmith, Langfuse, Braintrust, Promptfoo, DeepEval, Ragas и другие. В 2026 Stack Overflow уже спрашивает так, чтобы оценить популярность инструментов в каждой части этого AI-стека 4️⃣ Доверие формулируется через проверяемость В `AITrust есть не просто "trust / don't trust", а градации: доверяю только low-risk задачам; доверяю, когда могу легко проверить результат; доверяю многим задачам, но не важным work decisions. А в AIWorkNext` спрашивают, что человек делает перед использованием AI-generated answer: запускает локально, читает official docs, ищет Stack Overflow, спрашивает коллегу, проверяет tests/security implications, сравнивает с codebase context или использует как есть. 5️⃣ Настало время экономики и governance В `AIAdopt` спрашивают, что важно при выборе или расширении AI инструмента/модели: точность, попадание в workflow, безопасность/приватность, комплаенс, цена относительно ценности, мониторинг/лимиты расходов, возможность сменить инструмент/модель без большой боли, свидетельства бизнес результатов, встроенная наблюдаемость, нагрузка на ревью, возможность присмотра людьми и так далее. Вопрос тут в том, а сумеет ли организация сделать AI операционно управляемым. 6️⃣ Есть и отдельный слой про Stack Overflow как продукт и сообщество В `SOChange` спрашивают, как AI изменил использование Stack Overflow: стали ли люди реже заходить за простыми вопросами, чаще заходить для verification/source attribution, задавать меньше вопросов, задавать более сложные вопросы, меньше или больше контрибьютить. Если простые ответы уехали в чат, то ценность публичного Q&A смещается в проверяемость, источники, опыт людей и сложные случаи, где AI-ответ надо чем-то заземлить. В общем, этот опрос показывает, какую карту реальности Stack Overflow пытается построить в 2026 году. И эта карта сильно сдвинута от "AI как ассистент в редакторе" к "AI как агентная операционная модель разработки". #AI #AI4SDLC #Agents #Engineering #Software #Management

Книжный куб
Канал Александра Поломодова (@apolomodov), cto & technical fellow. https://polomodov.tech - сайт со всеми материалами youtube.com/@tellmeabouttech - канал со всеми видео
-
-


 +3
И по традиции прикладываю самые интересные иллюстрации из отчета "Cursor Developer Habits Report"
-
Cursor Developer Habits Report: AI-ускорение явно проявляется у продвинутых пользователей (Рубрика #AI4SDLC) Разбирался с "Cursor Developer Habits Report" за весну 2026, в котором много интересных графиков про ускорение разработки, рост контекста и автоматизацию. Но один из самых интересных инсайтов в том, что продуктивность среди пользователей растет не ровным слоем, а резко усиливает тех, кто уже умеет вплетать агентную работу в свой день. Если говорить про само исследование, то оно построено на агрегированных продуктовых/инженерных данных: использовании агентов, токенах, принятых AI-изменениях и активности смердженных PR. Данные пользователей приватного режима, которые выбрали opt-out, туда не входят. Основные находки, что вынесены в начало отчета такие 1️⃣ Ускорение разработки Скорость написания кода удвоилась год к году, pull request’ы становятся крупнее и глубже, а код, сгенерированный агентами, всё чаще успешно проходит ревью. 2️⃣ Экономика интеллекта Авторы сравнили семь семейств моделей по стоимости строки кода и стоимости одной отправки задачи, выявляя значительные различия в юнит-экономике. Если зафиксировать успешность решения задач, то самыми дорогими моделями являются Opus, потом ChatGPT, а потом Composer 2.5 от Cursor, причем разница между Cursor моделью и Opus на порядки 3️⃣ Разрыв между продвинутыми пользователями и остальными Авторы обнаружили, что, хотя AI приводит к широкому росту продуктивности, наиболее выраженные изменения наблюдаются у топ 1% разработчиков. 4️⃣ Рост роли контекста Авторы показали резкое увеличение количества входных токенов и сдвиг в сторону токенов, считываемых из кэша. Это даёт агентам своего рода рабочую память, позволяя им решать более сложные задачи и писать более качественный код. 5️⃣Сдвиг к автоматизации В конце авторы показали данные об эволюции кодинг агентов: из инструмента для отдельных разработчиков они превращаются в целую систему для создания и сопровождения софта, часто работающую автоматически. Интересно погрузиться поглубже в блок "The power user gap", где авторы приводят кривую Лоренца по AI строчкам кода, AI потреблению токенов с индексами Джини 0.77, 0.75 и 0.72. Обычно кривую Лоренца и коэффициент Джинни показывают в контексте экономического неравенства. И тут примерно такое же неравенство - небольшая группа пользователей генерирует непропорционально большую часть AI-работы, расходов и токенов. Из кривой Лоренца видно, что верхние 5% дают примерно 47% AI строк кода, 46% трат и 40% токенов. Дальше еще интереснее: - p99-разработчики производят в 46 раз больше AI lines per day, чем медианный активный пользователь, и в 15 раз больше merged PRs per week, чем медианный активный автор PR - p90-разработчик выглядит скромнее: 10x по AI строк кода и 4x по merged PRs В итоге, мы видим, что не "каждый разработчик стал на 15% быстрее" - у нас распределение с очень тяжелым хвостом, к которому просто так среднее не применишь (полезнее хотя бы на медиану смотреть) Правда, тут не стоит обязательно восхищаться этими продвинутыми пользователями - мы не можем сказать, что "лучшие разработчики стали в 46 раз быстрее", так как в метрике смешаны тип задач, размер кодовой базы, роль в команде, доверие к инструменту, качество контекста, разрешений, привычка дробить работу, возможность запускать агента в фоне и культура ревью. Но график интересен управленчески - он показывает как выглядит как может выгляядеть новая операционная модель работы. Если в команде появляется человек, который уверенно ставит агентам задачи, дает им контекст, читает diff, запускает тесты, режет scope и быстро снимает блокировки, он может уехать далеко вперед. Не потому, что нажал секретную кнопку, а потому что вокруг него собрался рабочий цикл: intent -> context -> agent run -> verification -> commit/PR -> feedback. У другого разработчика тот же Cursor может оставаться дорогим автодополнением, который иногда мешает. Отсюда практический вывод для AI4SDLC: считать средний usage мало. Нужны метрики по когортам, чтобы понимать - Кто реально доводит AI-работу до PR? - Где появляются крупные diff'ы? - Что происходит с нагрузкой на ревью, тесты, как дела с rework и насколько вырос change failure rate? - Чем отличаются топовые пользователи: они лучше формулируют задачи, лучше знают кодовую базу, чаще используют agents/automations, работают в более permissive repo или просто берут задачи другого класса? Если у вас есть такие power users, то надо пообщаться с ними, понять какие практики они используют и дальше масштабировать лучшие из них. Но нельзя просто посмотреть на хвост распределения и сказать, что режим power-user теперь является нормой для всех - так оно не полетит:) P.S. Разбор исследования Cursor есть на нашем сайте ai4sdlc-research.space. #AI #AI4SDLC #Engineering #Agents #DevTools #Management #Metrics
-

 +6
Иллюстрации из бенча "SWE-Interact"
-
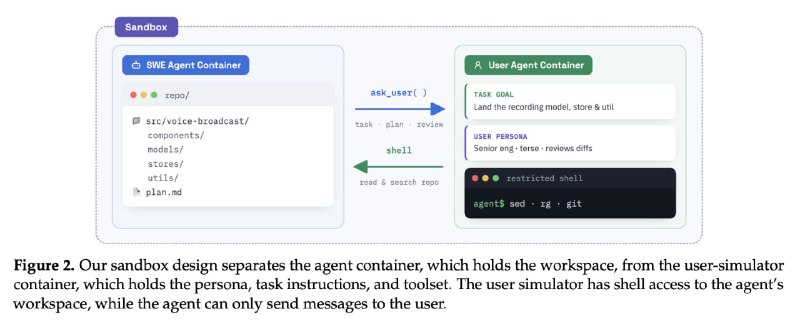
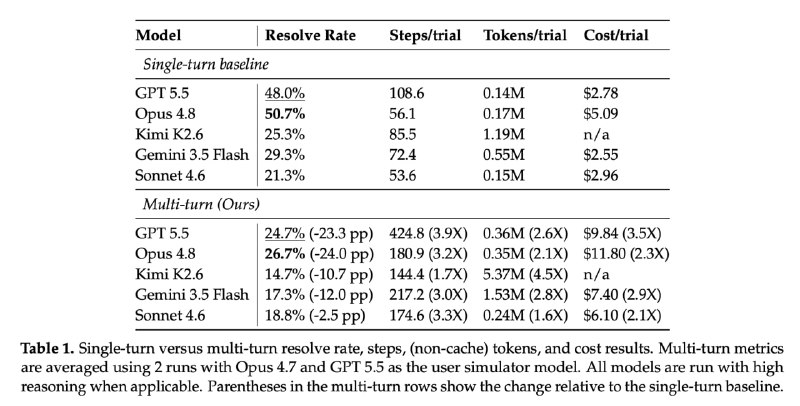
SWE-Interact: сколько стоит интерактивность кодинг-агентам (Рубрика #AI4SDLC) Решил сегодня рассказать про вторую статья про оценку кодинг-агентов в диалоге - "SWE-Interact: Reimagining SWE Benchmarks as User-Driven Long-Horizon Coding Sessions" от Scale AI. Любопытное совпадение: она вышла на arXiv 29 июня 2026 — в тот же день, что и SWE-Together от Meta (запрещенной в России), который я сегодня разбирал. Две команды практически одновременно пришли к одной мысли: одноходовые бенчмарки перестали отражать реальную работу с агентами, мерить надо диалог. Похоже, multi-turn оценка оформляется в отдельное направление (или Meta и Scale AI как-то связаны ... ах точно Meta же выкупила 49% Scale AI за $14 млрд и еще забрала к себе основателя компании) Scale собирает бенчмарк с противоположной стороны. Meta идет снизу вверх: из 11,260 реальных сессий восстанавливает 109 задач и якорит симулятор на намерения живых пользователей. Scale идет сверху вниз: берет 75 готовых задач из трех существующих бенчмарков (SWE-bench Pro, SWE Atlas (Refactoring), DeepSWE - первые два, замечу, ее собственные), прячет полную постановку внутрь симулятора пользователя и заставляет раскрывать требования постепенно. Решение при этом проверяет оригинальный верификатор задачи. Ход изящный: та же задача, тот же верификатор - меняется только способ подачи требований. Разница в resolve rate становится почти чистой ценой интерактивности. И тут цена оказалась реально высокой - лучшие модели решают около 50% задач в одноходовом режиме - и лишь примерно четверть тех же задач в диалоге: GPT-5.5 падает с 48.0% до 24.7%, Opus 4.8 - с 50.7% до 26.7%. При этом шагов обычно в 3–4 раза больше, токенов - до 4.5 раза, а стоимость задачи в 2–3.5 раза выше (у Opus 4.8 - $11.80 против $5.09). Работа с пользователем добавляет отдельную ось сложности задачи. Симулятор пользователя здесь интереснее, чем у Meta 1️⃣ Авторы создали персону из статистики Для этого они проанализировали реальные сессии из датасета SWE-chat и смоделировали самый частый типаж - дотошный эксперт в режиме vibecoding: senior-разработчик, который пишет коротко и небрежно, кода сам не трогает (по данным SWE-chat, в этом режиме агент пишет более 99% кода), но придирчиво следит за точными сигнатурами API и выдает замечания по одному за раз 2️⃣ Сам симулятор агентный у него есть shell-доступ к рабочей копии агента (git, grep, sed, find), и перед тем как ответить, он сам смотрит диффы и коммиты. У Meta симулятор видит только текст - сводки траектории и выводы инструментов; авторы SWE-Together сами перечисляли это среди ограничений. А тут эксперимент показывает, что дотошная персона - это боль: с ней шаги траекторий у большинства моделей растут на 30–50%, число реплик пользователя почти удваивается, а resolve rate снижается у 4 из 5 моделей по сравнению с нейтральным симулятором, который просто выдает требования по запросу. В статье приведен и разбор провалов (это аудит 287 неудачных траекторий). - Некоторые модели умеют хорошо распрашивать и уже по расплывчатому описанию закладывают в план более 80% скрытых целей, а GPT-5.5, Opus 4.8 и Sonnet 4.6 к концу диалога закрывают в среднем более 90% - Провалы сгруппированы так: -- Технические ошибки реализации (~34% меток) -- Забытые требования (~34%) - когда требование из ранней реплики так и не попало в финальный код -- В ~12% симулятор сам не выдал нужное требование, но это скорее всего false positive самого бенчмарка, о чем авторы и говорят в статье. Есть у исследования и ограничения - Задач собрано всего 75 (у Meta 109 задач) - Персона подобрана всего одна (а интересно было бы промоделировать разных пользователей) - Одноходовый baseline прогнан один раз - Результат заметно зависит от модели симулятора: с GPT-5.5 в роли пользователя Opus 4.8 решает 30.7%, с Opus 4.7 - 22.7% - Агенты работали каждый в своей родной обвязке (harness) - Claude Code, Codex CLI, Kimi CLI, а Gemini в сторонней OpenCode, - так что сравнение моделей смешано со сравнением обвязок, в отличие от SWE-Together с единой обвязкой opencode. - Scale AI - вендор данных и оценки моделей, продвигающий в том числе собственные бенчмарки (два бенча из четырех, из которых набирались задачи, были от Scale AI) Если подбивать итоги сразу по двум статьям, то у нас есть сигналы с двух ракурсов - Meta мерила, сколько корректировок пользователя нужно агенту до результата (сильным - меньше) - Scale мерила, сколько способности теряется, когда требования приходят по частям (даже у сильных - половина) Практически это означает: 1️⃣ Выбирая модель под реальную работу с людьми, смотрите на multi-turn разрыв, а не только на автономный resolve rate 2️⃣ Из двух главных режимов провала технические ошибки - вопрос к модели, а вот забытые требования лечатся процессом - файл с планом, явный список требований, коммит и ревью на каждую итерацию. Это уже вопрос не бенчмарка, а вашей обвязки. #AI #AI4SDLC #Engineering #Agents #Evals #Research
-


 +1
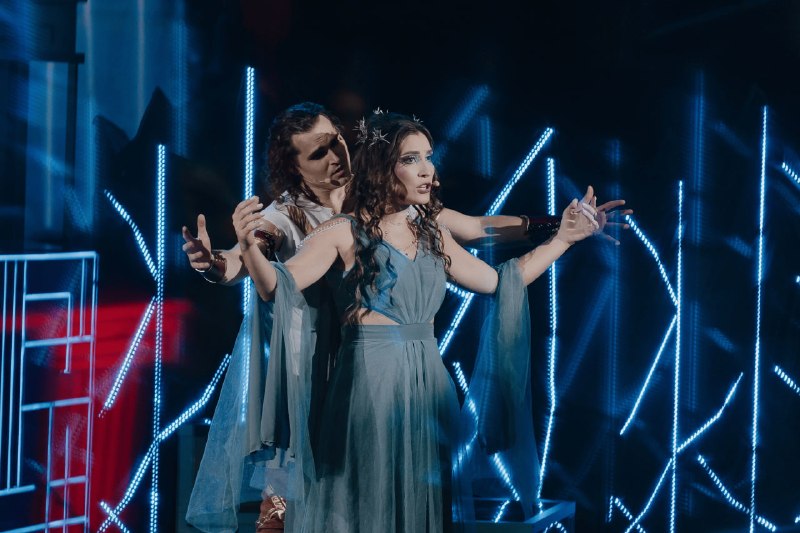
Орфей: древний миф, который хорошо работает как рок-опера (Рубрика #Culture) В мае мы были с женой на рок-опере "Орфей", и это оказался тот случай, когда сначала случайно цепляешься за пару песен, а потом идешь на концерт. Вообще, у меня к древнегреческим мифам давняя привязанность. В детстве я читал их очень много, особенно истории про Геракла: подвиги, чудовища, боги, полубоги, странные семейные конфликты Олимпа и постоянное ощущение, что герой почти никогда не получает простую награду за правильное поведение. Сейчас забавно вспоминать, что happy end там был скорее исключением, чем правилом. Кто-то побеждал, но платил страшную цену. Кто-то ошибался на один шаг и терял все. Кто-то попадал в чужую божественную интригу, где человеческое желание вообще мало что решало. В детстве меня это почему-то не смущало. Видимо, мифы читались не как сказки про справедливый финал, а как истории про выбор, судьбу и последствия. Поэтому с "Орфеем" у меня совпало довольно точно. Сначала я наткнулся не на афишу, а на записи: "Шаг в темноту!", "Сон" и "Будь что будет", которые мне сразу зашли. Я оценил напряжение: темноту, сомнение, упрямство, попытку договориться с тем, с чем вообще-то не договариваются. Уже потом я запланировал очное посещение, и тут мы не прогадали. На сцене эта история собирается гораздо плотнее, чем в отдельных треках. Официально "Орфей` описан как мифологический триллер о выборе, судьбе и любви, где история Орфея и Эвридики переплетена с мифом о похищении Персефоны. И вживую это действительно работает именно как переплетение, а не как школьный пересказ "герой спустился в подземный мир". Больше всего мне понравилось, что постановка не пытается сделать миф удобным. В ней остается то самое античное чувство: даже когда человек действует из любви, он все равно идет через систему сил, договоров, запретов и чужих решений. Орфей здесь не просто романтический певец, который красиво страдает. Он человек, который делает шаг в темноту и не до конца понимает, какую цену придется заплатить за саму попытку вернуть потерянное. А еще это было просто атмосферно и круто. Музыка, голоса, свет, зал, живое присутствие актеров - все вместе дало тот эффект, ради которого стоит иногда выходить из режима "послушаю запись дома" и идти в театр. В записи можно поймать песню. В зале ловишь масштаб. Показательный момент: прямо в антракте я купил билеты на рок-оперу "Гермес" от той же творческой бригады. Сходить пока не получилось: на даты наложилась командировка во Владивосток. Но сам факт хорошо описывает впечатление от "Орфея": если в перерыве ты уже покупаешь билет на следующую историю, значит постановка свою работу сделала. В общем, очень рекомендую эту рок-оперу к посещению. P.S. Приложенные фото взял из официальной галереи на сайте https://orfey-rock.ru/#gallery #Culture #Theatre #Music #Rock #Mythology
-


 +4
Иллюстрации из бенча "SWE-Together"
-
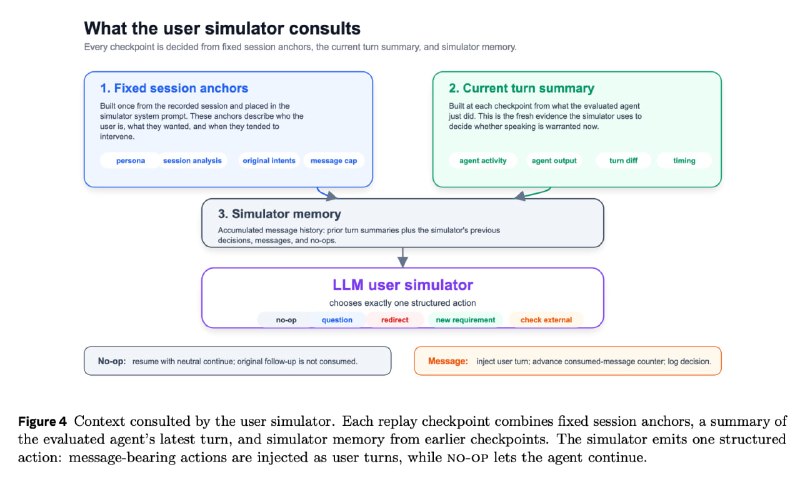
edited SWE-Together: как мерить кодинг-агентов диалогово, а не в один ход (Рубрика #AI4SDLC) Прочитал свежую статью "SWE-Together: Evaluating Coding Agents in Interactive User Sessions" от команды запрещенной в России компании "Meta" (arXiv, 29 июня 2026). Авторы бьют в слабое место почти всех бенчмарков кодинг-агентов: они статичные. Агент получает полную постановку задачи сразу и оценивается по финальному коду. А реальная работа с агентом устроена иначе - это диалог, где пользователь раскрывает намерение постепенно, уточняет требования и поправляет ошибки по ходу. В общем и целом, авторы хотели проверить гипотезу того, что сильной модели нужно меньше вмешательств пользователя во время работы (и это реально подтвердилось) Вообще, проблемы с бенчами классические: один насыщаются и перестают различать топовые модели (можно глянуть мой разбор выступления про SWE-rebench). Также бенчи не всегда измеряют именно то, как с ними взаимодействуют инженеры. Собственно, SWE-Together (лидерборд, github) как раз и пробует уйти от одноходовой постановки (single-turn) к диалогу (multi-turn), режиму который более похож на реальную работу с агентами. Интересна процедура сбора датасета - На входе было 11,260 реальных сессий пользователей с кодинг-агентами (четыре открытых датасета с Hugging Face: DataClaw, Pi-staging, Hyperswitch, SWE-chat) - На выходе получили 109 воспроизводимых задач уровня репозитория, что дает конверсию в 0.97% - Посередине были жесткие фильтры: нужно восстановимое состояние репозитория, ясная цель, проверяемый исход, а финальное изменение должно быть в основном написано агентом, а не человеком - Каждая задача на выходе - это песочница с зафиксированным коммитом, окружением и верификаторами. Самая интересная инженерная часть в этом бенче - это симулятор пользователя. Он нужен так как исходную сессию нельзя проиграть дословно: новый агент пойдет другим путем, и реплики исходного пользователя потеряют смысл. Поэтому LLM-симулятор заякорен на намерения из исходной сессии, но реагирует на живую траекторию оцениваемого агента: после каждого хода он принимает одно решение - промолчать, задать вопрос, перенаправить агента, добавить требование или попросить проверить внешний артефакт. В слепом тесте аннотаторы не смогли отличить симулятор от живых пользователей: 46% "принятия за человека" при случайном уровне 50%, разница статистически незначима (аля пройден модифицированный тест Тьюринга). Оценка тоже сделана с оглядкой на известную болезнь: фиксированные тесты искажают оценку в обе стороны - узкие цепляются за случайные детали реализации, широкие требуют поведения, которого никто не просил. Здесь финальное состояние репозитория оценивает агентный судья по зафиксированному заранее набору критериев (frozen rubric): взвешенные поведенческие цели формируются один раз, офлайн, до и независимо от любых кандидатов, а потом одинаково применяются ко всем моделям. Оценивается поведенческая полнота, а не похожесть на исходный патч. На выходе у нас есть еще метрика User Correction, которая показывает сколько раз пользователю пришлось явно поправить агента (плюс мягкие подталкивания с весом 0.2) по дороге к результату. Два агента с одинаковым финальным баллом могут стоить пользователю очень разных усилий. Результаты по семи моделям в общей обвязке (harness) opencode. - Claude Opus 4.8 лидирует: pass@1 63%, средний балл судьи 0.801 и минимум корректировок - 1.38 за сессию, но и самый большой расход output+reasoning токенов (74k на задачу) - GPT-5.5 второй по среднему баллу судьи (0.763) и самый экономный: 29.9k токенов и 10.7 минут на задачу - Способность и число корректировок связаны почти линейно: корреляция Пирсона "−0.92". В итоге, гипотеза о том, что сильной модели нужно меньше вмешательств пользователя получила количественное подтверждение - в рамках этого бенчмарка. Забавная деталь: моделей самой Meta в таблице нет. В общем, авторы бенча смогли померить налог на верификацию результатов работы агента (через метрику User Correction). AI удешевил производство кода, но не доверие к изменениям, и "сколько раз человеку пришлось направлять агента" - неплохая оценка этого доверия. Практически это означает две вещи 1️⃣ Оценивать агентов стоит парой метрик - успех плюс стоимость руления, а не одним pass@1 2️⃣ Ваши собственные сессии с агентами - готовое сырье для таких проверок качества (evals): пайплайн «сессия → задача» в статье описан подробно, код открыт. P.S. Смежный whitepaper "SWE-Interact" от Scale AI, вышедший в тот же день, что SWE-Together, рассмотрен в следующем посте. #AI #AI4SDLC #Engineering #Agents #Evals #Research
-
Matt Pocock про agent skills: как не свалиться в skill hell (Рубрика #AI4SDLC) Посмотрел выступление Matt Pocock на AI Engineer "Building Great Agent Skills: The Missing Manual", в котором скиллы обсуждаются как инженерные артефакты: с классификацией, ценой поддержки и понятным критерием качества. Главная мысль, которую я оттуда забрал: хороший skill нужен, чтобы получить предсказуемый процесс из вероятностной системы. Не одинаковый ответ каждый раз, а одинаковый способ работы: когда подключаться, что прочитать, какие шаги пройти, где остановиться, что считать завершением. Такой подход лучше, чем стандартный взгляд на skills как на склад полезных инструкций, при котором быстро начинается skill hell: десятки файлов, пересекающиеся правила, старые заметки, непонятные триггеры, и в итоге агент то не вызывает нужный skill, то тащит в контекст лишнее, то преждевременно объявляет работу законченной. У Pocock полезная рамка начинается с invocation - как skill вообще вызывается. 1️⃣ Model-invoked skill У скилла есть описание, которое модель видит заранее и по которому может сама решить: "да, сейчас это нужно". За это надо платить контекстом, так как описание постоянно занимает место. Поэтому такой skill оправдан, только если агент действительно должен сам до него дотянуться. 2️⃣ User-invoked skill Он не висит в контексте и вызывается человеком вручную. Это экономит токены и внимание модели, но перекладывает нагрузку на пользователя: нужно помнить, что такой skill существует. Если таких ручных skills стало слишком много, появляется отдельный router skill - не магический диспетчер, а человеческая карта, которая помогает выбрать нужный путь. Дальше идет внутренняя анатомия skill. В ней, по сути, два вида материала: 1️⃣ Steps - действия, которые агент должен выполнить в порядке. 2️⃣ Reference - правила, определения, примеры, справка, которую агент читает по необходимости. Хороший skill не обязан быть только процедурой. Он может быть набором reference-правил, как чеклист ревью. Или наоборот - почти чистой последовательностью шагов. Важно другое: материал должен лежать на правильном уровне информационной иерархии - То, что нужно в каждом запуске, остается в SKILL.md - То, что нужно только в отдельных ветках, уезжает в отдельные файлы и подгружается через context pointers Это не просто экономия токенов, а способ не размазывать внимание агента. В шагах должен быть определен критерий окончания - completion criterion, так агент отличит "готово" от "почти готово". "Разберись с проблемой" - плохой критерий. "Проверь все измененные модели, перечисли найденные расхождения и укажи, какие тесты это покрывают" - уже рабочее ограничение. Чем мутнее граница завершения, тем выше риск раннего завершения, когда агент зафиналит работу чрезмерно поспешно. Отдельно Matt уделяет много внимания использованию leading words (например, название паттернов или архитектурных концепций). Это короткие слова-якоря, которые уже есть в предобучении модели и помогают стабилизировать поведение: не длинная повторяющаяся инструкция, а компактный термин, вокруг которого собирается нужный способ думать. Хороший leading word одновременно помогает invocation - агент чаще понимает, когда skill нужен, - и execution - агент внутри skill держится одного режима работы. Ну и напоследок Matt говорит о том, как подчищать скиллы (pruning), так как они деградируют как документация: туда легче добавить новую строчку, чем удалить старую. Так появляются повторы, циклы и нерабочие инструкции. Практический вывод отсюда простой: skill - это не промпт, а маленький продуктовый интерфейс к поведению агента. У него есть стоимость discoverability, стоимость поддержки, границы ответственности и failure modes. Его нужно проектировать почти как API: - Понятный trigger; - Один источник истины для каждого правила; - Проверяемые completion criteria; - Разделение steps и reference; - Progressive disclosure для редких веток; - Регулярная чистка no-op и устаревших инструкций. #AI #AI4SDLC #Engineering #Agents #Software #Management
-
GitLab AI Accountability Report: код уже генерируют быстрее, чем умеют контролировать (Рубрика #AI4SDLC) Разбирался с GitLab 2026 AI Accountability Report, который компания выпустила 23 июня 2026 года. Этот отчет хорошо продолжает линию GitLab Act 2, DORA ROI и недавнего Stack Overflow Pulse Survey: AI уже ускорил генерацию кода, но узкое место переехало в контроль, проверку и ответственность. Исследование провел The Harris Poll для GitLab: 1 528 разработчиков и закупщиков в шести странах. Это важно читать как вендорский опрос, а не как независимый отчет, но результаты получились интересными: по данным GitLab, 91% организаций уже используют два или больше AI coding tools, 78% говорят, что разработчики стали быстрее писать и коммитить код, 60% считают ROI выше ожиданий. Если читать только эти числа, то видим оптимистичный взгляд на внедрение ... но ребята из GitLab приготовили нам AI парадокс: 79% респондентов согласны, что индивидуальная продуктивность разработчиков выросла, но общий процесс поставки софта ускорился не так уж сильно. То есть локальная скорость генерации не равна скорости поставки изменений. Код появляется быстрее, а очередь переезжает в review, валидацию, безопасность, комплаенс, развертывание и поддержку. Тут есть пара красивых цифр 1️⃣ 85% согласны, что AI сдвинул бутылочное горлышко от написания кода к его ревью и валидации. 2️⃣ 84% считают, что самая большая проблема с AI-генерированным кодом - не создание, а управление тем, что происходит с ним после генерации. Это почти идеальная формулировка взрослого AI4SDLC - может ли инженерная система ответить на три вопроса про любую строку сгенерированного AI кода: 1) Откуда она взялась 2) Что должна была сделать 3) Кто отвечает за нее в production Именно так GitLab определяет AI accountability И тут у нас появляется разрыв между теорией и практикой (почти как в анекдоте про миллионеров). По данным GitLab, 87% уверены, что команда за 24 часа определит, участвовал ли код, сгенерированный AI, в прод инциденте. Но среди организаций, у которых за последний год уже был инцидент, 34% не смогли этого сделать. Причины выглядят примерно так - 43% не могут надежно отличить AI-сгенерированный код от кода, написанного людьмы, в своей кодовой базе - 40% упираются в фрагментированные инструменты; - 39% работают с системами, которые не отслеживают происхождение кода; только 28% говорят, что их SDLC-инструменты полностью интегрированы через общие данные и рабочие процессы. Блок про governance тоже показательный. GitLab пишет, что 92% сталкиваются с какими-то governance challenges вокруг AI-кода, а 80% согласны: организация внедрила AI инструменты быстрее, чем разработала политики управления ими. 83% уже считают накопление AI-кода риском, которым нужно управлять сейчас; 44% называют это топовым технологическим риском. Практически я бы забирал из отчета не вывод "купите governance tools" (хотя GitLab был бы не против такого вывода). Скорее важно спросить себя - А можем ли мы для AI-сгенерированного изменения восстановить задачу, контекст, инструмент, автора/оператора, diff, review, тесты, security checks, approval, релиз, владельца сервиса и последствия в production? - Если не можем, то скорость генерации уже стала обязательством, которое в моменте может как повышение продуктивности инженеров, а через полгода станет техническим долгом. P.S. Разбор исследования GitlLab есть на нашем сайте ai4sdlc-research.space, где вскоре мы заново запустим наше исследование AI4SDLC на этот раз про проникновение агентов в процессы разработки. #AI #AI4SDLC #Engineering #DevSecOps #Management #Governance #Agents
-


DeepSeek в действии (DeepSeek in Action) (Рубрика #Books) Наконец-то дочитал книгу "DeepSeek в действии", с которой все вышло забавно - она 1 июля 2025 года в ДМК Пресс, переводчиком был В. Яценков, а оригинал называется "DeepSeek in Action: LLM Deployment, Fine-Tuning, and Real-World Projects" от китайской "Лаборатории искусственного интеллекта будущего". Я прочитал первую часть почти сразу - буквально за пару дней после получения, а дальше она надолго зависла в стопке. А все дело в том, что она состоит из двух неодинаковых по качеству блоков 1️⃣ Почему DeepSeek вообще стал инженерным событием В первом разбирается базовая архитектура Transformer и те доработки DeepSeek, которые полтора года назад всколыхнули индустрию: MoE, механизм внимания, оптимизация памяти и вычислений, обучение с переменной разрядностью, распределенная оптимизация. Это именно тот слой, ради которого книгу стоило открыть. 2️⃣ Как использовать API DeepSeek Здесь авторы рассказывают банальщину про то, как генерировать тексты, решать математические задачи, писать код, собирать чат-клиенты. Я понимаю, зачем такие главы нужны массовому читателю, но читать их в 2026 году скучно. Вокруг LLM API все быстро становится commodity: endpoint, ключ, запрос, ответ, немного кеширования, очередное демо. А вот первая часть достойна краткого упоминания, так как именно там авторы рассказывают про инженерные фокусы, что сейчас уже выглядят стандартом 1️⃣ MoE (mixture of experts) вместо плтоных (dense) моделей У модели может быть очень много параметров, но для конкретного токена активируется только часть экспертов. В DeepSeek-V3, по technical report, всего 671B параметров, но активируются 37B. Масштаб растет, а вычисление остается разреженным. 2️⃣ Multi-head Latent Attention, MLA Обычный Transformer на длинном контексте упирается в KV-cache: нужно хранить ключи и значения прошлых токенов, и это быстро становится дорогим по памяти. MLA сжимает Key-Value cache в latent vector. Это дает сильное сокращение KV-cache и рост throughput. 3️⃣ Auxiliary-loss-free load balancing Авторы уходят от вспомогательного loss для балансировки экспертов, чтобы не портить качество основной задачи 4️⃣ Multi-token prediction Это когда модель на обучении предсказывает не только следующий токен, а несколько следующих. Это попытка выжать больше качества и скорости из самой training objective. 5️⃣ Инженерные моменты Авторы использовали FP8/mixed precision, распределенное обучение, параллелизм и коммуникация между GPU. По отчету DeepSeek-V3, модель предобучали на 14.8T токенов, а полный training обошелся в 2.788M H800 GPU hours. Эти цифры стоит читать как утверждение из технического отчета авторов, но именно они объясняют, почему DeepSeek так громко прозвучал: индустрия увидела не только качество модели, а заявку на другую экономику обучения. На фоне такой первой части книги оставшиеся 250 страниц про использование API выглядят просто как текстовый заполнитель, который не ясно зачем читать:) особенно сейчас. И это показывает, что AI-книги устаревают не просто быстро, а еще и неравномерно. Даже сейчас архитектурная часть этой книги выглядит полезной, а остальное уже нет. P.S. Забыл упомянуть, что теперь ребята из ДМК Пресс переводят много китайских технических книг напрямую - у меня целая пачка сейчас в todo листе лежит, а пару я взял с собой в отпуск, так что может дальше напишу про рекомендательные системы на основе LLM:) #Books #AI #DeepSeek #LLM #Engineering #Software #SystemDesign
-
Microsoft Frontier Company: AI-внедрение становится отдельной индустрией (Рубрика #AI4SDLC) Разбирался со свежим анонсом Microsoft Frontier Company от 2 июля 2026 года, в котором Microsoft объявила новую бизнес-единицу на $2.5B и 6 000 экспертов, которых будут встраивать к клиентам для внедрения AI. Кажется, что этим анонсом Microsoft почти прямым текстом признает, что главное бутылочное горлышко корпоративного AI уже не в доступе к моделям, а в способности превратить AI в рабочую производственную систему. Новая структура Microsoft Frontier Company - это отдельный операционный бизнес внутри Microsoft, который должен помогать клиентам делать Frontier Transformation: выбирать рабочие сценарии, проектировать AI-системы, внедрять их в реальные процессы и потом постоянно улучшать по бизнес-метрикам. Компания заявляет, что это "больше, чем FDE": не только forward deployed engineers, а смесь индустриальной экспертизы, менеджмента изменений, непрерывных улучшений и AI инжиниринга корпоративного уровня. Механика похожа на старую идею Palantir FDSE (Forward-Deployed Software Engineer), но в масштабе гиперскейлера. Инженеры и отраслевые специалисты Microsoft должны работать рядом с командами клиента: ко-дизайн, ко-инновации, деплой решений и их дальнейшие улучшения. В качестве ранних примеров Microsoft приводит LSEG Workspace, Land O'Lakes, Unilever и Novo Nordisk. Партнерский слой тоже встроен сразу: Accenture, Capgemini, EY, KPMG, PwC и другие. Цель у анонса в том, чтобы перевести клиентов из режима "мы купили доступ к моделям и сделали пилот" в режим "у нас есть измеримый ROI, governance, безопасность, понятная экономика и контур улучшения". В июньских текстах Microsoft это называлось Intelligence + Trust: с одной стороны, компания должна накапливать свой IQ - данные, процессы, экспертизу, решения; с другой - видеть, управлять, защищать и считать стоимость AI-систем через Agent 365, Foundry, Microsoft IQ, Entra, Purview, Defender и FinOps. Отдельный продающий момент - это защита "customer IQ". Microsoft обещает, что данные, IP и конкурентное преимущество клиента не будут использоваться для обучения моделей так, чтобы превращать его дифференциацию в коммодити для всех остальных. Плюс компания говорит про гетерогенную открытую платформу с моделями от разных провайдеров: OpenAI, Anthropic, Microsoft AI, open source и специализированные модели под конкретные сценарии. Интересно, что "открытая и model-diverse" платформа не отменяет того, что control plane, identity, observability, cost management, контекст и workflow могут оказаться глубоко завязаны на Microsoft stack. То есть vendor lock-in смещается: раньше он был в облаке и лицензиях, теперь он может быть в графе корпоративного контекста, агентных политиках, evals, т рейсах и привычках команд. Индустриально это не одиночный ход - 4 мая Anthropic вместе с Blackstone, Hellman & Friedman и Goldman Sachs объявила AI-native enterprise services firm - 11 мая 2026 OpenAI объявила Deployment Company с FDE и $4B+ начальных инвестиций - 30 июня AWS объявила $1B в Forward Deployed Engineering, чтобы встраивать тысячи экспертов к клиентам и доводить agentic AI до production - Microsoft 2 июля отвечает масштабнее и ближе к своему сильному месту: enterprise platform + партнерская сеть + продажи + compliance. Отсюда несколько последствий. 1️⃣ Consulting и systems integration входят в новую фазу Accenture и другие интеграторы и консалтинговые фирмы не исчезают, но им придется работать не поверх нейтрального IT-рынка, а внутри платформенных экосистем OpenAI, Anthropic, AWS и Microsoft. Часть маржи и ownership за transformation layer будут забирать сами AI-поставщики. 2️⃣ Для компаний-клиентов "AI strategy" перестает быть презентацией про кейсы применения Им теперь продают истории про операционную модель работы. Объясняют кто владеет агентами, где живет контекст, кто пишет evals, как считаются затраты, кто разрешает tool calls, как обновления выкатываются в production, что остается внутри компании после ухода внешней команды. 3️⃣ Меняется роль инженера Ценным становится не только умение писать код или prompts, а связка domain + architecture + security + product thinking + change management. Forward deployed engineering в AI-эпоху - это не "консультант с ноутбуком", а человек, который может зайти в сложный бизнес-процесс, понять реальные ограничения, собрать production-систему и оставить после себя воспроизводимый pattern. В общем, мы видим как рынок идет в сторону уровня развертывания решений. И кто сумеет встроить AI в реальные workflows, защитить корпоративные знания, измерить эффект и не отдать весь IQ поставщику, тот и получит преимущество. А кто просто купит внешний "AI transformation" как услугу, рискует получить красивый пилот и зависимость от чужой инженерной памяти. #AI #AI4SDLC #Engineering #Agents #Bigtech #Management #Architecture
-
Dylan Patel про AI-inference и про ко-дизайн софта и железа как залог кратного роста (Рубрика #AI) Посмотрел выпуск Sequoia Training Data с Dylan Patel, основателем SemiAnalysis: "Why Hardware-Software Co-Design Is AI's Real 100x". Вообще, я слежу за работами этой компании (например, я разбирал их крутую статью "The Great GPU Shortage"). Это интервью с основателем компании было взято буквально на днях и классно подсвечивает, что улучшения в возможностях genAI систем основаны на совместном дизайне моделей и железа: модель, kernels, runtime, сеть, память, чип и дата-центр нельзя оптимизировать как независимые детали. Отдельный рост в "2x" в моделях, "2x" в ядрах (kernels) и "2x" в железе могут дать не 8-кратный рост, а скачок на порядок больше (100x), если модели и железj проектируются вместе. Или, наоборот, хороший чип может выглядеть слабым, если модель и софт под него не подходят (аля новые модели на старых чипах). Самый конкретный пример в выпуске - InferenceX, живой benchmark SemiAnalysis для inference. По словам Patel, point-in-time бенчи быстро устаревают: модели меняются почти каждую неделю, PyTorch, vLLM, SGLang, драйверы и inference-оптимизации обновляются постоянно, а одно измерение через месяц уже плохо описывает рынок. Поэтому InferenceX каждый день прогоняет модели на разных типах железа и строит не одну цифру "кто быстрее", а кривую throughput / interactivity. Это интересный взгляд на баланс пропускной способности и скорости токенов на пользователя - у пакетных задач и интерактивных кодинговых агентов разные экономики - Если пользователь ждет ответ в цикле обратной связи, то задержка дорогая: можно платить больше за fast mode, спекулятивный декодинг или меньший размер батча - Если нужно ночью прогнать пачку документов, важнее tokens per second на единицу железа, а не мгновенная реакция. Итого, оценивать "лучшую модель" и "лучшую железку" стоит относительно рабочих нагрузок, бюджета задержек и цены ошибки. Дальше Patel интересно рассакзывает про топовые лабы и по его мнению OpenAI, Anthropic, Google и DeepSeek расходятся не только по качеству моделей, но и по архитектурной форме. Различаются значимые компоненты - Размеры матриц для перемножения - Структура внимания (attention) - Структура экспертов в MoE (mixture of experts) - Топология сети и пропускная способность памяти - и так далее В итоге, все это определяет где модель будет работать хорошо По мнению Patel DeepSeek лучше ложится на Nvidia/Hopper/Blackwell-подобный мир (а теперь и Ascend от Huawei), TPUs сильны в других классах моделей, а Google оптимизирует Gemini под свои поколения TPU. В итоге, мы видим как модели становятся неотделимы от железа, на котором они будут жить. Отсюда следует интересный взгляд на преимущества (moat) Nvidia, которое сегодня не сводится к тому, что все используют CUDA. Модели уже неплохо помогают писать кастомные ядра, а большие лаборатории давно могут форкнуть PyTorch или собрать свою инфраструктуру. Но важно, что все открытые модели, inference-провайдеры, RL-компании и downstream-экосистема часто оказываются оптимизированы под Nvidia просто потому, что там уже лежит масса рабочих моделей и обвязки. Если у Google появится сопоставимая открытая модельная экосистема под TPU, то ситуация может сместиться. Мне кажется, это хороший антидот к простым разговорам про AI-железо. Каждый крупный игрок ищет оптимум для себя в связке model architecture + infrastructure software + silicon + power. Специализированный чип может быть прекрасным на одном участке пайплайна и неудачным через год, если архитектура моделей уехала в другую сторону. Поэтому стандартное железо для вычислений остается в мейнстриме не из-за лени рынка, а потому что даже большие лаборатории не всегда знают, какие модели будут запускать через год. Патель дает интересные оценки и прогнозы, которые выглядят полезными для понимания этого рынка - Стоимость inference на единицу качества падает примерно на 60x в год. Смысл в том, чтобы сравнивать надо не просто цену токена, а стоимость достижения сопоставимого уровня качества. - Интеллект на Ватт растет не на 60x, но примерно на 40x в год - Inference станет одним из крупнейших рынков в мире, возможно больше нефти. Это завязано на то, что ценность работы, которую AI сможет выполнять, станет огромной долей экономики - К 2030 году OpenAI + Anthropic, по его прогнозу, могут иметь более 100 GW компьюта совместно, а потом к этому празднику жизни добавятся Meta, Google и остальные. - К 2040 году inference deployments могут измеряться уже тераваттами, что следует из предыдущих прогнозов - В 2030 году датацентры в космосе будут почти не важны: меньше 1% железа под инференс, а вот к 2040 году они займут потенциально больше половины инкремента компьюта Итого, главный вывод из интервью такой, что AI-инфраструктура окончательно становится системной инженерией. Нельзя отдельно выбрать модель, отдельно купить железо, отдельно настроить serving и потом удивляться экономике. Нужно описывать классы задач, latency/cost curve, качество ответа, размер контекста, сетевые ограничения, доступную мощность, capital constraints и только потом решать, где нужен fast mode, где batch, где GPU, где TPU, где своя обвязка. На практике это означает, что при построении AI продукта стоит мерить не "стоимость токена" вообще, а стоимость полезной работы на конкретном рабочем процессе. В одном месте дорогой быстрый токен окупается, потому что сокращает человеческий цикл обратной связи. В другом месте он просто сжигает бюджет. #AI #Engineering #Architecture #Infrastructure #Bigtech #Software #SystemDesign
-

Stack Overflow Pulse Survey: AI-агенты уже в работе, но еще не автономны (Рубрика #AI4SDLC) Разбирался с новым Stack Overflow Pulse Survey про agentic AI. Исследование вышло 27 мая 2026 года и опирается на опрос 1 100 разработчиков, проведенный в конце апреля. Основной результат в том, что агенты стали популярнее, но популярность растет не через полную автономию, а через довольно жесткий человеческий контрль (с human in the loop). Доля респондентов, которые используют AI-агентов на работе с любой частотой, выросла с 31% в Developer Survey 2025 до 59% по сравнению с результатами большого опроса StackOverflow 2025 года. Приложил картинку из отчета, на которой тренд очень заметен. Правда, 63% респондентов редко или никогда не разрешают агентам работать полностью автономно, а 60% блокируют неутвержденные системные изменения. То есть реальная картина пока не выглядит так, что агент сам делает работу от начала до конца - агент стартует работу, но права на действие остаются ограниченными. Он может писать, предлагать, искать, объяснять, собирать черновик решения. Но когда начинает менять состояния системы, появляется человек, approval, diff, CI, policy или другой gate. И это хорошо ложится в тренд про цикл верификации, который я упоминал раньше. Интересно, что 68% респондентов предпочитают предсказуемые конфигурации с одним агентом, а не сложные мульти-агентные системы. Среди текущих агентных рабочих процуессов 69% респондентов используют одного агента (на иллюстрации указано 69%, а в тексе исследования 68% - хз кому верить:) ), 17% - несколько специализированных агентов, 16% - несколько пересекающихся или координируемых агентов. В общем, рынок любит красивые схемы с роем агентов, но практики пока выбирают одного агента, понятную задачу, видимый результат и меньше координационной магии. Ежедневное использование отмечают 40% full-stack разработчиков, 52% архитекторов и 50% топ-менеджеров (senior executives, что попали в опрос StackOverflow - а это обычно инженерные лидеры). Но это самооценка аудитории пульс-опроса Stack Overflow, а не общая информация по индустрии. Самые устойчивые барьеры тоже ожидаемые: точность и безопасность. Траты стали менее болезненным ограничением: доля тех, кто считает стоимость барьером, снизилась с 53% в Developer Survey 2025 до 38% в пульс-опросе. А вот точность и безопасность остаются главными рисками, хотя доля сильно соглашающихся тоже снизилась: для точности с 57% до 47%, для безопасности с 56% до 44%. Интересно, что AI достаточно полезен, чтобы стать стандартом де-факто, но пока недостаточно надежен, чтобы убрать human-in-the-loop. Деньги становятся операционным вопросом, а качество, безопасность и ответственность - архитектурным. Инструментальный ландшафт узнаваемый: GitHub Copilot, Claude Code, OpenAI Codex, Cursor, Replit, Lovable, v0, LangChain, LangGraph, OpenAI Agents SDK. Но для меня самый интересен интерес к observability/evals tooling - пользователи чаще хотят расширять использование таких инструментов, чем уже активно применяют их. Если агент становится частью production-системы разработки, ему нужны не только промпты и доступ к репозиторию. Нужны права, логи, evals, следы аудита, откаты, политики, ответственность и понятный способ доказать, что действие было безопасным. P.S. Разбор исследования StackOverflow есть на нашем сайте ai4sdlc-research.space, где вскоре мы заново запустим наше исследование AI4SDLC на этот раз про проникновение агентов в процессы разработки. #AI #AI4SDLC #Agents #Engineering #Software #Management
-
edited Code of Leadership S2E3: Как создавать AI-продукты с Даниэлем Левинишниковым (Рубрика #AI) Вышел новый выпуск моего подкаста Code of Leadership с Даниэлем Левинишниковым — продуктовым лидером, который занимается AI-продуктами в Т-Банке. Получился разговор не только про AI, но и про то, как вообще строить продукты в большой компании, как управлять командами на масштабе и что будет происходить с продуктовыми ролями в ближайшие годы. Кстати, у Даниэля есть свой канал https://t.me/tldrdaniel Основными темами выпуска стали: - Что такое AI-продукт и чем он отличается от обычного digital-продукта. - Почему красивая AI-демка еще не означает, что продукт можно масштабировать. - Как понять, нужен ли в задаче AI, или достаточно более простой эвристики. - Какие метрики смотреть в AI-продуктах: cost saving, допродажи, user effort, evals и качество моделей. - Почему в большой компании главная проблема не собрать прототип, а добиться качества на масштабе. - Как устроены гейты, OKR и «венчурная» логика управления продуктовым портфелем. - Почему лидеру в AI важны насмотренность, готовность быстро пивотиться и умение закрывать проекты без sunk cost fallacy. - Как структурировать R&D, чтобы он не превращался в хаос. - Почему FOMO в AI сейчас во многом оправдано. - Что будет с продуктовыми командами, middle management и границами между ролями в мире AI-native разработки. Отдельно интересно получилось про будущее команд. Даниэль считает, что продуктовые роли будут все сильнее схлопываться: продуктам придется глубже разбираться в разработке, аналитике и ML, а инженерам — в бизнесе, продукте и дистрибуции. Команды станут меньше, сильнее и более плоскими, а ценность «просто менеджмента» без сильных hard skills будет снижаться. В финале обсудили переоцененные и недооцененные AI-тренды, ассистентов, автоматизацию supply в разных индустриях, Lovable, Cursor, moat в AI-продуктах, роль доменных знаний, network, дистрибуции и скорости. В общем, мне кажется, что это хороший выпуск для продактов, инженеров, тимлидов, EM, руководителей и всех, кто пытается понять, как делать не просто AI-демки, а настоящие AI-продукты. Выпуск доступен в разным местах: Youtube, VK Video, Podster.fm, Ya Music. #AI #ProductManagement #Leadership #Management #AIProducts #Engineering #Startups #ML #LLM #CodeOfLeadership
-
edited System Design Space (Рубрика #Architecture) Последние месяцы мало рассказывал про свой пет-проект system-design.space, но я не переставал над ним работать:) По-факту, было 3 основных трека 1️⃣ Улучшение языка изложения - я хотел избавиться от runglish по всему сайту. Многие из вас говорили о том, что это мешает изучению материалов. В итоге, я сделал специальный подход с терминологическим словарем и рефакторингом проекта. Сейчас термин в первый раз внутри главы сопровождается английским термином в скобках + при наведении можно посмотреть расшифровку. Дальше по главе он идет уже на русском. Это касается почти всех терминов, но акронимы все равно остаются на английском 2️⃣ Добавление покрытия материалов по разным темам в основном вокруг проектирования ML/AI систем 3️⃣ Сборка книжки и подача ее в издательство - теперь у меня есть черновик, который возможно превратится в книгу. В книге пока три основные части - Принципы найма и проведения собесов в bigtech - мои статьи про найм у нас - Принципы проектирования - тут тоже я пилил статьи и даже обучающие курсы по архитектуре - Задачи на проектирование из домена ML/AI, описание и решение которых оформлено в том стиле, что мы используем внутри себя (по 7-шаговому фрймворку). Я выбрал задачки из этого домена для того, чтобы читатели разобрались на практике с тем, как работают эти технологии и что там нет магии, понимали их ограничения и рабочие режимы, а также лучше понимали как встраивать эти возможности в свои сервисы. В книге есть еще 3 приложения - Разборы других материалов на тему system design (книг и курсов) - Немного про документалки о технологиях и зачем их смотреть - Терминологический словарь А в конце еще есть список ссылок на литературу #SystemDesign #Architecture #Software #DistributedSystems #UX #Interview
-
AI Research OS: как second brain становится памятью для агентов (Рубрика #AI4SDLC) Посмотрел выступление Paul Iusztin из Decoding AI (соавтор книги "LLM Engineer's Handbook") и Louis-François Bouchard из Towards AI (автор книги "Building AI Systems for Production") на канале AI Engineer: "Turn 10,994 Notes Into Memory". Оно мне зашло тем, что ребята решали проблему, с которой я сталкиваюсь часто сейчас: исследования на разные темы копятся, документы раскиданы по разным источникам и собирать контекст под новый вопрос не очень сложно. Я с этой проблемой борюсь разными способами, а тут авторы предложили свой, который я планирую попробовать. Но сама постановка проблемы у авторов звучит как организация информации в том виде, который будет удобен для повторного использования в исследованиях. Codex, Claude Code, ChatGPT или NotebookLM могут быстро помочь с отдельной задачей, но если каждый новый сеанс заново восстанавливает источники, выводы и открытые вопросы, знания по исследованию не накапливается. Для решения этой проблемы авторы создали проект "AI Research OS". По сути, это локальный слой памяти между вашим second brain и агентной обвязкой (agent harness). Не очередной чат с большим контекстным окном и не тяжелая RAG-инфраструктура с vector database. Идея более приземленная: обычные файлы, Markdown, index.yaml, сырые источники и wiki-слой, который агент может читать, пополнять и проверять. Архитектура там простая и скучная: - На входе - Obsidian, Readwise, NotebookLM, GitHub-репозитории, YouTube-транскрипты, ссылки, PDF и локальные файлы - Система складывает неизменяемые raw-источники, строит индекс, а сверху генерирует wiki: страницы источников, concepts, entities, comparisons, overview, synthesis, open questions и log - Агент сначала читает индекс, потом краткую wiki-страницу, потом производные страницы и только при необходимости лезет в полный raw-документ. Интересно, что Paul отмечает, что его second brain с заметками в Obsidian работает как долговременная память и immutable snapshot (LLM не должен переписывать личные заметки). Вместо этого под конкретный проект создается отдельная research-wiki. В итоге имеем - Second brain как архив архив - Проектная wiki как рабочая память, из которой потом можно писать статью, делать слайды, разбирать кодовую базу или продолжать исследование через месяц. Авторы сравнивают свой подход (через простое хранение файлов в репе) с другими - NotebookLM полезен для чтения набора источников, но авторы считают его менее удобным для agent-native и coding-сценариев - Vector database и полноценный RAG нужны в продуктовых системах, но для личного исследовательского OS это часто слишком много инфраструктуры (я кстати, сейчас тут в своем пет-проекте копаюсь, но там реально много движущихся частей получается) Если вы решите попробовать подход авторов, то реализация открыта на GitHub под MIT-лицензией. В репозитории есть skills /research, /research-distill, /research-lint, /research-render, примеры с deep research, ingest GitHub-репозиториев и ingest обычных ссылок. По README, для старта нужен uv, Claude Code или Codex, а внешние CLI для Obsidian, Readwise и NotebookLM подключаются по мере необходимости. Для первых экспериментов с репозиториями и ссылками не нужно сразу тащить весь личный архив. Отдельно авторы говорят о том, что в проекте они не планировали строить SaaS и есть задел для улучшений: не хватает коннекторов вроде Google Drive, Notion и Slack, слабее проработаны source provenance, оценка устаревания источников и memory compaction. Но в проекте видно, как устроена система, где можно вмешаться и что адаптировать под свой процесс. P.S. Выступление авторов мне понравилось, думаю, что потрогаю их систему и посмотрю как она работает для моих сценариев. #AI #AI4SDLC #Engineering #Research #Software #Architecture
-
Шурик в Матрице. Полный фильм (Рубрика #Films) Эта короткометражка просто топчик - супер-микс истории Матрицы, нашего контекста и героев из советских фильмов прошлого. В итоге, получается очень-очень круто. Рекомендую к просмотру, если еще не видели:)
-
edited Сегодня записывал интервью в рамках подкаста Code of Leadership со своим коллегой Даниэлем Левинишниковым из нашего AI Центра. Мы успели поговорить про карьерный путь Даниэля, критерии хорошего AI продукта, как выглядит запуск такого продукта в корпорации, как выстроен менеджмент большой командой ML/AI специалистов, про лидерство в эпоху перемен и так далее. Пока интервью в обработке, но уже есть шортс про то, что middle management уже в опасности:) Кстати, примерно об этом я рассказывал в статье "От AI-native разработки к AI-native организации (с примерами из опыта бигтехов)" P.S. На неделе опубликую интервью целиком:)
-
Евгений Кокуйкин про AI Security - AI Dev Podcast (Рубрика #AI4SDLC) Посмотрел подкаст с AI Dev Conf, в котором участвовали Евгений Кокуйкин, Андрей Дмитриев и я. Мы поговорили о том, что происходит с безопасностью разработки, когда у нас кодяру начинают писать не только люди, но и агенты с разными инструментами, доступами и правами на изменения. Если говорить про гостя, то Евгений Кокуйкин - это CEO HiveTrace, со-основатель Raft, руководитель AI Security Lab в ИТМО и участник OWASP Agentic Security. То есть это точка зрения практика AppSec/AI security, который видит и технологию, и поверхность атаки. Главная мысль выпуска крутится вокруг того, что в агентной разработке безопасность становится частью архитектуры процесса: кто действует, от чьего имени, какие права получает, что логируется, где нужен approval и как быстро можно откатиться. Наше общение можно разделить на отдельные блоки 1️⃣ Почему coding agents вообще так быстро продвинулись В обычных GenAI-приложениях трудно понять, насколько ответ хорош: пользователь поставил палец вверх или вниз, но это слабая обратная связь. В разработке иначе. У нас уже есть компиляторы, линтеры, тесты, git-история, баг-трекеры, CI/CD и код-ревью. Можно взять старый баг, восстановить состояние репозитория, дать агенту задачу и проверить решение теми же тестами. SDLC уже содержит заготовку для evals. Отсюда растёт автономность. Агент может решить задачу, получить обратную связь от тестов, перезапустить попытку, передать изменения на ревью. Для внешнего клиента режим "попробуйте ещё раз" выглядел бы странно, а внутри разработки retry, тесты и ревью становятся нормальной частью контура. Но дальше начинается неприятная часть. Если агент становится участником SDLC, его нельзя воспринимать как безобидную подсказку в IDE. Он похож на внутреннего сотрудника или сервисный аккаунт: identity, доступы, токены, возможность читать репозитории, дергать API, смотреть логи, иногда деплоить или помогать с инцидентами. Проблема service accounts и раньше была болезненной, но агентная разработка умножает её на порядок. Часто разговоры про AI security быстро уезжают в область prompt injection, jailbreaks и красивых атак на модель. Но во многих реальных сценариях ломается более скучный слой: права доступа, секреты, supply chain, разделение dev/stage/prod, аудит действий и зависимости. Евгений приводил примеры из мира coding assistants, MCP-серверов, Postmark, LiteLLM и других supply-chain историй. Паттерн здесь прост: если агент или его инструмент подтянул заражённую зависимость, обычные unit tests могут ничего не заметить. 2️⃣ Экономика и метрики Бизнесу легко пообещать "заменим половину разработки агентами", но реальность сложнее. Нужно считать не только токены и GPU, но и платформу: gateway, routing между моделями, sandboxing, аутентификацию, авторизацию, квоты, наблюдаемость. А бенефит нельзя сводить к количеству AI-кода: интереснее смотреть на конкретные job'ы внутри SDLC - миграции, багфиксы, ревью, тесты, инциденты, повторяемые изменения. 3️⃣ Надёжность Если SRE-агент в 2 часа ночи может собрать анамнез инцидента, это полезно. Если он может сам перезапускать сервисы, менять конфигурацию или выполнять план восстановления, это уже другой класс риска. Если каждое опасное действие агента уезжает на senior approval, узкое место просто переехало к самым загруженным людям. Значит, нужны более тонкие политики риска: что агент может делать сам, где нужен второй контур проверки, где требуется изоляция среды, а где действие запрещено всегда. 4️⃣ Ответственность Мы обсуждали агента почти как классическую пару принципала и агента (из теории управления): человек или компания задаёт цель, агент действует от их имени, а дальше появляются misalignment, побочные действия и вопрос "кто отвечает?". Эта логика из менеджмента теперь просачивается в технический контур одного инженера и его агентов. Для инженеров главный вывод такой: AI security в SDLC - это не отдельная "галочка ИБ", а проектирование производственной системы. Нужны evals, threat modeling, least privilege, sandboxing, разделение сред, audit trail, model routing, контроль секретов, политика для non-human identities и наблюдаемость агентных действий. И ещё более практично: если в компании появляются кодинговые агенты, то не стоит начинать с вопроса "какую модель выбрать", а с карты прав и последствий. Что агент читает? Что пишет? Какие инструменты вызывает? Может ли он достать данные? Может ли деплоить? Кто увидит его действия? Как остановить, откатить и расследовать результат? Без этих вопросов "ускорение разработки" очень легко превращается в ускорение риска. #AI #AI4SDLC #Security #Engineering #Architecture #DevSecOps #Agents
- Older posts