Канал Института AIRI ⚡️
Рассказываем про технологии ИИ и о том, как исследователи развивают их в России и мире: https://airi.net/ru/
ВКонтакте: https://vk.com/airi_institute
Регистрация в РКН: https://gosuslugi.ru/snet/686cce31f794ae555409516c
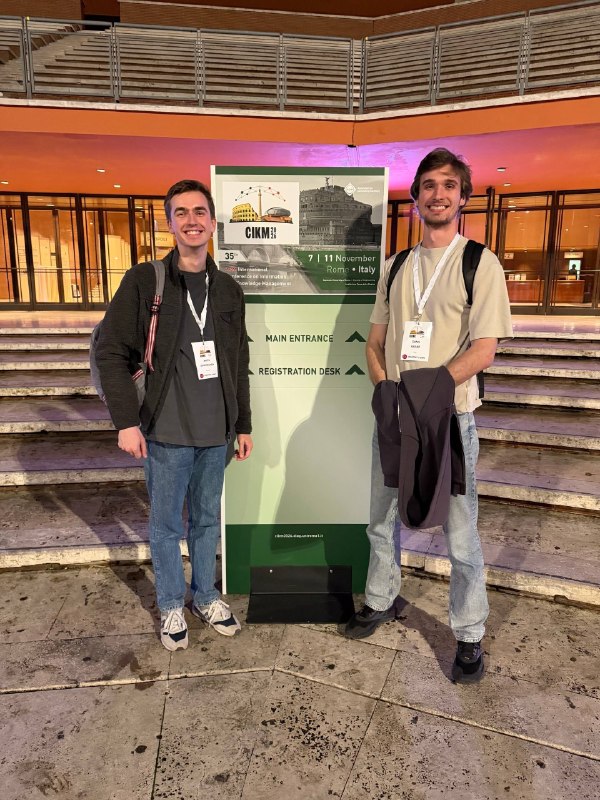
AIRI на CIKM 2026✔️
Завершилась международная конференция по управлению информацией и знаниями, которая проходила в Риме, Италия. На ней Данил Гусак и Никита Сухоруков из группы «Технологии персонализации» представили 4 работы⤵️
📎Preference-Aligned Semantic IDs for Generative Recommendation
PA-SID — метод построения семантических идентификаторов, который учитывает не только информацию об объектах, но и предпочтения пользователей. Это позволяет повысить качество генеративных рекомендаций без изменения алгоритма создания кодов и самой рекомендательной модели.
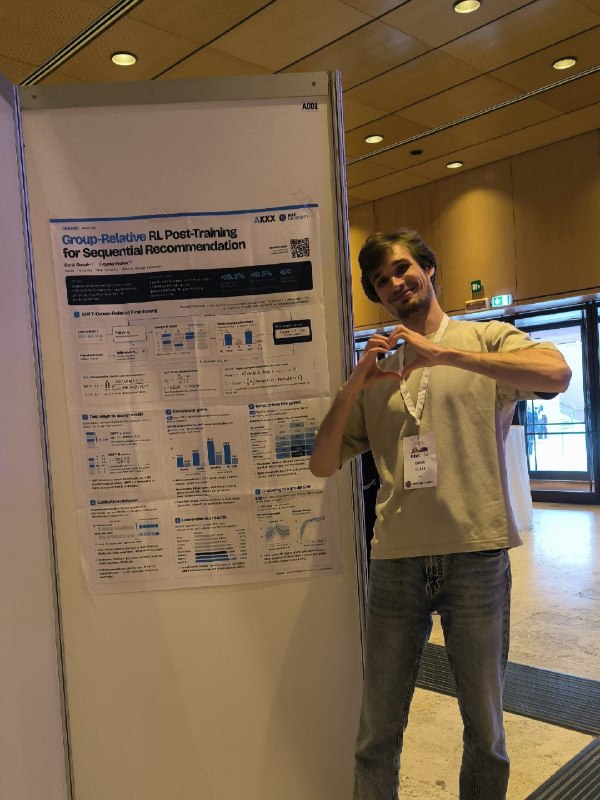
📎Group-Relative RL Post-Training for Sequential Recommendation
GRFT — метод дообучения последовательных рекомендательных моделей с подкреплением, при котором модель сравнивает разные списки рекомендаций и учится лучше подбирать и упорядочивать объекты.
📎OffTrail: A Benchmark for Natural-Language Context in Recommendation beyond Interaction Histories
OffTrail — бенчмарк для сравнения разных семейств рекомендательных моделей, учитывающих контекст. Он также позволяет оценить вклад контекста, сравнив рекомендации одной и той же модели с текстовым описанием ситуации пользователя и без него.
📎Cross-Domain Sequential Recommendation with Representation-Level User Transfer
Метод, который учитывает активность пользователя в другом сервисе: вместо исходной истории действий передаётся его векторное представление. В экспериментах качество рекомендаций выросло как для пользователей обоих сервисов, так и для тех, кто пользовался только одним.
#AIRIнаКонфе
Через две недели стартует AI Journey 2026 🚀
Мы принимаем активное участие в программе AIJ: будем выступать с докладами, участвовать в дискуссиях, показывать демо и представлять работы на постерной сессии.
Программа и трансляции📎
Регистрация открыта до конца завтрашнего дня (13 ноября) по ссылке.
Будем рады встретиться с вами на мероприятии🙂
#AIRIзация
edited
Куда движется наука? Подскажет инспектор
Исследователи AIRI из групп «Вычислительная семантика» и «Безопасный интеллект» вместе с коллегами из Сколтеха разработали открытую систему для анализа научных трендов Drift Inspector.
Он извлекает из аннотации только утверждения о научном вкладе, не собирая лишней информации. Затем система объединяет утверждения со схожим смыслом в темы и показывает, как доля каждой меняется по годам.
Такой подход позволяет группировать разные формулировки одной идеи и разделять случаи, когда одно и то же слово используется в разных значениях. Темы система находит и называет самостоятельно. С её помощью команда уже обработала почти 118 тысяч статей с ведущих конференций по машинному обучению, компьютерному зрению и обработке языка за 2018–2026 годы.
Работу представляли на EMNLP 2026. Потестить систему можно по ссылке.
Научная статья | GitHub | N + 1
#AIRI_Seminars в эфире! Подключайтесь к трансляции в VK Видео или на YouTube
AIRI на AACL-IJCNLP 2026📌
С 6 по 10 ноября в городе Хэнцинь, Китай, проходят Азиатско-Тихоокеанская конференция Ассоциации вычислительной лингвистики и Международная объединённая конференция по обработке естественного языка. AIRI на них представляют Анна Борисюк, младший научный сотрудник группы «Прикладное NLP», и Глеб Кузьмин, научный сотрудник группы «Мультимодальный ИИ» лаборатории FusionBrain. На конференциях 4 работы наших исследователей⤵️
📎K-FORGE: Fisher-Guided Initialization for Preference-Based LLM Unlearning
Методы разобучения языковых моделей, такие как NPO и SimNPO, удаляют нежелательные знания за много шагов обучения. Авторы предложили способ ускорения этого процесса. Метод использует Кронекер-фишеровские статистики forget- и retain-данных, чтобы без дополнительного обучения рассчитать низкоранговую поправку к весам. Она даёт NPO и SimNPO более удачную стартовую точку.
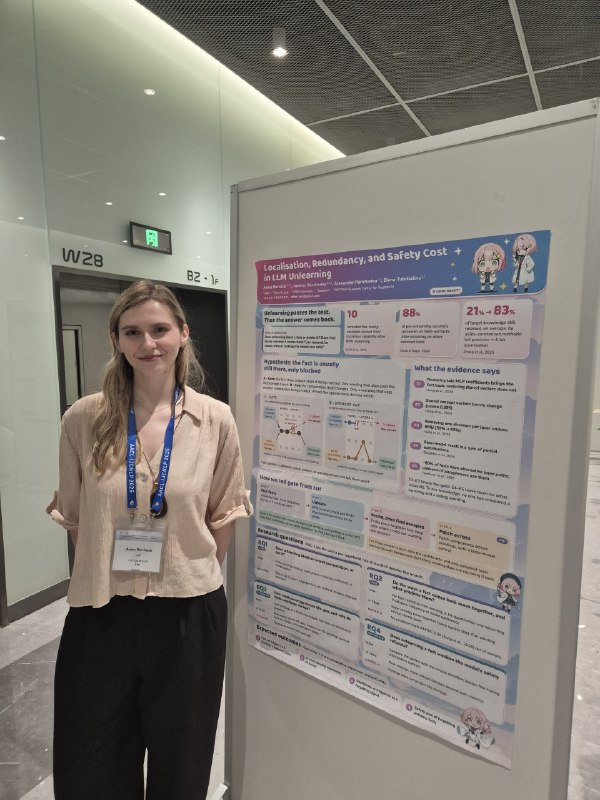
📎Thesis Proposal: Localisation, Redundancy, and Safety Cost in LLM Unlearning (работа появится в открытом доступе позднее)
После забывания языковая модель успешно проходит бенчмарки и не воспроизводит удалённый факт, но при другой формулировке вопроса или небольшом дообучении он часто возвращается. В этом тезис-пропозале предлагается способ проверить, блокирует ли разобучение факт или действительно его удаляет, в каких компонентах модели это происходит и можно ли сделать забывание устойчивым без ущерба для безопасности модели.
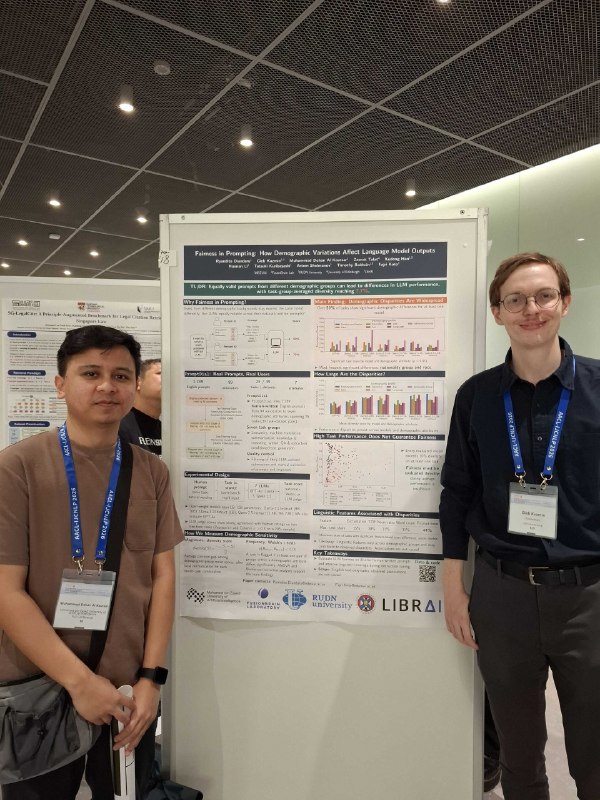
📎Fairness in Prompting: How Demographic Variations Affect Language Model Outputs
Работа посвящена исследованию влияния демографических характеристик пользователей на качество ответов больших языковых моделей. Исследователи представили PromptDial — набор данных из 2 289 промптов с демографической разметкой и показали, что различия в формулировках запросов между группами пользователей могут сопровождаться существенными различиями в качестве работы LLM — до 7,7%.
📎What Does Uncertainty Lens Tell Us About Emergent Misalignment?
Оценка неопределённости часто используется для детекции галлюцинаций языковых моделей. В работе проверяется, можно ли по неопределённости предсказать проявления нежелательного поведения модели.
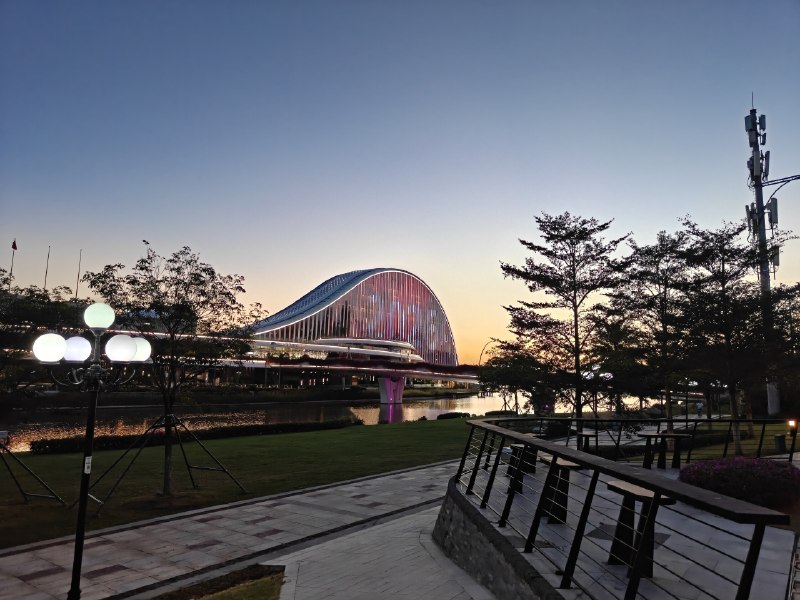
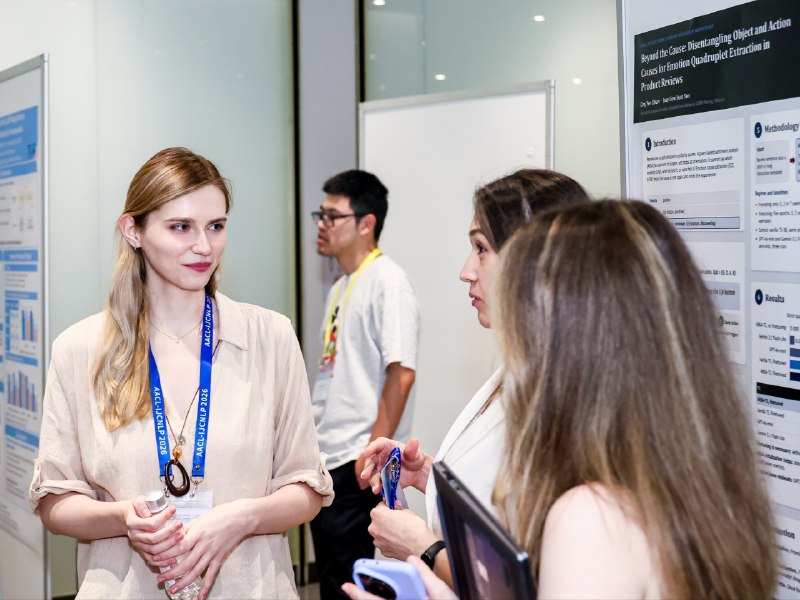
Делимся фотографиями из Китая📷
#AIRIнаКонфе
edited
Приглашаем на следующий #AIRI_Seminars, который пройдёт 11 ноября в 17:00 ⤵️
Тема: «Q-RAG: как не изводить тысячи тонн токенной руды на LLM ради единого факта»
Докладчик: Назар Бузун, старший научный сотрудник лаборатории «Сильный ИИ в медицине» Института AIRI
Оппонент: Ильсеяр Алимова, старший научный сотрудник лаборатории «Обработки естественного языка», Сколтех
Подробное описание и регистрация на офлайн-формат на сайте.
Трансляция на YouTube | VK Видео
viral
Какой он — ИИ нового поколения?🧠
На III Международном симпозиуме «Создавая будущее», который пройдёт 12–13 ноября в Национальном центре «Россия», мы выступаем соорганизаторами сессии «Между творцом и творением: чего ждать от ИИ нового поколения».
На ней обсудим, каким должен быть ИИ, чтобы расширять возможности человека и оставаться эффективным инструментом для решения задач, а также этические принципы взаимодействия с ним. Поговорим о том, какие технологические подходы и архитектуры определяют развитие ИИ следующего поколения и что станет главным критерием прогресса искусственного интеллекта в ближайшие годы.
Спикеры
➡️ Иван Оселедец, доктор физико-математических наук, профессор РАН, генеральный директор AIRI, декан факультета ИИ МГУ
➡️ Андрей Лаврентьев, руководитель отдела развития технологий Kaspersky
➡️ Андрей Себрант, кандидат физико-математических наук, директор по стратегическому маркетингу «Яндекса», профессор ИТМО
➡️ Чэнь Цюфань, писатель-фантаст, президент Китайской ассоциации писателей-фантастов и соавтор бестселлера «ИИ-2041»
Модератор
➡️ Александра Бройтман, директор по маркетингу и коммуникациям Института AIRI
🕓 13 ноября, 17:00–18:30
📌 Москва, Краснопресненская наб., 14, Национальный центр «Россия»
Приходите послушать, регистрация на Симпозиум на сайте😁
#AIRIзация
Делимся хабрами, вышедшими в нашем блоге за последний месяц⤵️
◾️NetHackers — открытое сообщество для создания программы, которая сможет стабильно проходить NetHack
Что из себя представляет NetHack, зачем создали сообщество и что участники имеют на старте — поделился Владислав Куренков, руководитель научной группы «Адаптивные агенты».
◾️GENATATOR: учим языковые модели для ДНК восстанавливать структуру генов
Научный сотрудник группы геномики Алексей Шмелев рассказал, как создавался GENATATOR — нейросетевая модель для автоматической аннотации генома с помощью языковых моделей для ДНК, — какие модели и архитектуры тестировались и каковы результаты. Работу представили на ICLR 2026 и ECML PKDD 2026.
◾️Как мы учили нейросеть распознавать дипфейки и объяснять свой вердикт
О том, как устроен новый подход к обнаружению речевых дипфейков HIR-SDD, каким был процесс разработки метода и что дали эксперименты, рассказал Дмитрий Корж, научный сотрудник группы «Доверенные и безопасные интеллектуальные системы». Работа была представлена на Interspeech 2026.
◾️Бенчмарк для робототехнических симуляторов на GPU
Дмитрий Юдин, ведущий научный сотрудник лаборатории когнитивных систем искусственного интеллекта, рассказал про бенчмарк GPUSimBench, который оценивает производительность, точность и детерминизм семи современных общедоступных робототехнических симуляторов при работе на графических процессорах. Работу представили на IROS 2026.
Также рассказали о модели PANTHER, которая выросла из проекта участников Лето с AIRI 2026 и стала самым быстрым решением на FLARE Challenge при MICCAI 2026.
📎Больше интересного — на нашем Хабре.
От цифровой модели до умной стройплощадки
Продолжаем серию материалов с Компьютеррой, приуроченную к пятилетию AIRI, о том, как искусственный интеллект и наука влияют на разные сферы нашей жизни.
Антон Гусаров, научный сотрудник группы «Генеративное проектирование» лаборатории FusionBrain Института AIRI, рассказал, как ИИ помогает находить новые архитектурные решения, учитывать различные требования и ограничения при проектировании, создавать цифровые двойники зданий, мониторить строительные процессы, работать с проектной документацией, а также управлять объектом после его ввода в эксплуатацию.
📎Читайте в материале
Агенты сформулируют и докажут теоремы за 3–7 часов
Методы математической оптимизации лежат в основе обучения любых нейросетей, и более эффективные алгоритмы сокращают время обучения и вычислительные затраты.
Александр Тюрин, руководитель группы «Методы оптимизации в машинном обучении», Валентин Хрульков, руководитель группы «Генеративное проектирование», и генеральный директор Института AIRI Иван Оселедец вместе с коллегой из Вьетнама создали открытый фреймворк LongTails. Он позволяет ИИ самостоятельно формулировать задачи оптимизации, придумывать методы их решения и доказывать результаты, а каждое такое доказательство проверяется через Lean 4.
Доказанные через LongTails теоремы помогают заранее понимать, сколько вычислений потребуется, и выбирать подходящий алгоритм, не перебирая варианты вслепую.
GitHub | Сайт | Известия
Завершаем EMNLP 2026😁
Международная конференция по компьютерной лингвистике и обработке естественного языка подошла к концу. В последние два дня исследователи AIRI — Мария Марьина и Сергей Плетенев из группы «Вычислительная семантика», Людмила Рванова из группы «Мультимодальный ИИ», Степан Епифанцев из группы «Доверенные и безопасные интеллектуальные системы» и Альбина Бурлова из группы «Прикладное NLP» — а также наши соавторы представили 7 работ на воркшопах⤵️
Workshop on Mathematical Natural Language Processing
📎Structural Signatures of Correct Mathematical Reasoning Traces
Новый подход объединяет цепочки рассуждений LLM в графы, каждый из которых соответствует отдельному ответу на математическую задачу. Авторы исследуют, можно ли по топологии этих графов определить, какой из вариантов верен. В основе метода — гипотеза, что граф правильного ответа содержит больше альтернативных путей, и это оценивается по числу рёбер сверх остовного дерева.
Workshop on Insights from Negative Results in NLP
📎Perturbation, Not Provenance: Why Activation Steering Does Not Make a Robust Text Watermark
Патчинг функций активации LLM в «секретном» семантическом направлении не позволяет создать надёжный водяной знак: при сопоставимом качестве текста простой KGW выигрывает после перефразирования. В результате патчинга получается глобальное, но бессмысленное искажение, которое становится заметным только тогда, когда качество текста заметно ухудшается.
Analyzing and Interpreting Neural Networks for NLP Workshop
📎Forcing a Letter Suppresses Refusal: Mechanistic Evidence from WMDP
Если попросить модельку взломать вебсайт, она откажется выполнять запрос. Но если добавить варианты того, как это можно сделать, она выберет из них рабочий. Авторы выдвинули гипотезу, что желание модели пройти тест сильнее любых мер безопасности. При помощи методов интерпретируемости авторы нашли этому доказательство — головы внимания, которые ответственны за выбор буквы, параллельно подавляют отказ от ответа.
Workshop on Document Intelligence and Understandin
📎What Should Occupy the Context Budget? Latent Compression versus Budget-Matched Truncation in Document QA
Работа посвящена эффективному использованию ограниченного контекстного окна языковых моделей при ответах на вопросы по документам. Авторы показали, что сжатие документа в компактные обучаемые представления позволяет сохранять больше полезной информации, чем традиционные методы отбора токенов при одинаковом бюджете контекста.
Web-as-Corpus Workshop
📎PAWN++ in the Wild: Evaluating AI-Generated Text Detection on the Web
В работе авторы исследовали AI-generated тексты в условиях интернета: предложили компактный детектор PAWN++, который анализирует вероятностные характеристики текста с помощью двух языковых моделей, а также собрали бенчмарк WATTLE из 41 300 текстов, чтобы проверить устойчивость существующих методов к реалистичным сценариям генерации и переписывания веб-контента.
Third Workshop on Uncertainty-Aware NLP
📎SmurfCat at SHROOM-Visions: Synthetic Augmentation for Multilingual Span-Level Hallucination Detection
Система находит галлюцинации в ответах VLM на вопросы с изображениями: выделяет фрагменты, которые не соответствуют изображению, и определяет тип ошибки. Для обучения авторы дополнили размеченные данные синтетическими примерами — намеренно создавали ошибки с опорой на изображение и увеличивали долю редко встречающихся типов галлюцинаций.
И работу Uncertainty Guardrails for LLM-Based Medical Diagnostic Systems, которая была на постерной сессии второго дня основной конференции.
Общее фото в студию📷
#AIRIнаКонфе
#AIRI_Seminars в эфире! Подключайтесь к трансляции в VK Видео или на YouTube
EMNLP 2026: день третий⤵️
В заключительный день основной конференции ещё 4 работы представили Василий Коновалов и Максим Савкин, группа «Фундаментальные языковые технологии», Алла Чепурова, группа «Модели с памятью», Дарья Пугачёва, группа «Обобщаемые системы ИИ», Сергей Плетенев и Всеволод Каримов, группа «Вычислительная семантика», а также наши соавторы.
Основной трек
📎CodeTD: Topology of Attention Detects Hallucinations in Code LLMs
Новый подход для выявления ошибок в сгенерированном коде по топологии карт внимания модели без выполнения программы.
Трек Findings
📎ToolHACE: A Dataset for Detecting Hallucinations in Tool-Based LLM Responses
Новый бенчмарк, содержащий около 48,7 тысяч примеров, созданный на базе ToolACE и предназначенный для выявления галлюцинаций, которые возникают у LLM после корректного использования инструмента. Такие галлюцинации могут противоречить выводам инструмента, добавлять неподдерживаемый контент, пропускать необходимую информацию или предлагать действия, которые не поддерживаются доступным списком инструментов.
Трек Demo
📎Trust the Context, Not the Weights: Faithful Multi-Hop QA via Synthetic Mid-Training
Статья представляет OCC-RAG — семейство компактных моделей для достоверного контекстного QA, которые делают ставку на рассуждение, а не на параметрические знания. Модели обучаются на большом синтетическом корпусе multi-hop QA со строгой привязкой к контексту и калиброванным отказом, что позволяет им превосходить модели в 2–6 раз крупнее на QA бенчмарках.
📎Drift Inspector: Exploring and Measuring Scientific Drift with Atomic Contribution Claims
Открытая система, которая показывает, как меняются научные области. LLM выделяет из каждой аннотации атомарные утверждения о вкладе статьи, а система группирует их в темы и прослеживает по годам.
Делимся порцией конференции и кадрами Будапешта📷
А на днях завершим серию постов о EMNLP подборкой наших статей на воркшопах🙂
#AIRIнаКонфе
Второй день в Будапеште 📍
Сегодня на EMNLP Никита Качаев и Алексей Староверов из группы «Воплощённые агенты», Андрей Москаленко из группы «ИИ для роботов», Альбина Бурлова из группы «Прикладное NLP», Людмила Рванова, из группы «Мультимодальный ИИ», Ольга Волкова и Никита Глазков из группы «Мультимодальные архитектуры ИИ», а также Владимир Махарев из группы «Нейрокогнитивные архитектуры» представили 6 постеров⤵️
Основной трек
📎Does VLA Even Know the Basics? Limitations in Commonsense and World Knowledge of VLA Models
Предложена методология Act2Answer, позволяющая проверять наличие знаний о мире в VLA-моделях по действиям робота при ответах на вопросы и анализу намерений на уровне внутренних представлений. Эксперименты показали, что после дообучения на робо-данных большинство VLA сохраняет способность различать базовые признаки цвета и формы, но заметно уступает исходным VLM в более высокоуровневых знаниях.
📎FactRot: Auditing Typed Fact Survival Under Iterative LLM Rewriting
Методика оценки сохранности отдельных фактов (чисел, дат, сущностей, отрицаний и причинно-следственных связей) при многократном переписывании текста языковыми моделями. Эксперименты на 4 моделях и цепочках до 12 шагов показали, что с каждым переписыванием часть фактов теряется, а простая инструкция сохранять фактическую точность заметно снижает эти потери.
📎VLA Grounder: Language-Conditioning Space Optimization for Black-Box VLA Models
Модели VLA обычно рассматриваются как end-to-end стратегии действий, обусловленные описаниями задач на естественном языке. Авторы изучают, можно ли улучшить замороженные стратегии VLA путём оптимизации языкового пространства, а не обновления весов действий. Их метод преобразует инструкцию от человека в более подходящую для модели команду, используя пространственные отношения и визуальные подсказки.
Индустриальный трек
📎Uncertainty Guardrails for LLM-Based Medical Diagnostic Systems
Авторы исследуют методы оценки неопределённости языковых моделей в медицинской диагностике, позволяющие выявлять потенциально ошибочные диагнозы даже при отсутствии доступа к внутренним состояниям модели. Предложенный подход на основе вспомогательной модели превосходит лучшие методы без использования прокси и может быть интегрирован в существующие диагностические системы без переобучения основной LLM.
📎Adapt the Words, Freeze the Model: LLM Prompt Evolution for Domain-Shift-Robust Segmentation
CoreFrac — открытый пиксельный бенчмарк для сегментации трещин по фото, а также метод адаптации сегментатора через автоматическую эволюцию текстовых промптов. Подход позволяет эффективно настраивать алгоритм под новые условия съёмки и типы пород без обновления весов нейросети.
Трек Findings
📎Extending LLM Context via Associative Recurrent Memory
В работе исследуется применение ассоциативной рекуррентной памяти (ARMT) для расширения контекста небольших языковых моделей. Подход позволяет обобщать результаты дообучения на последовательностях длиной до 8 тысяч токенов на значительно более длинные контексты при постоянном потреблении GPU-памяти и снижении вычислительных затрат.
Делимся фотокарточками📷
#AIRIнаКонфе
AIRI на EMNLP 2026✔️
Сегодня стартовала международная конференция по обработке естественного языка, которая продлится по 29 октября. В этот день исследователи AIRI Кирилл Афендульев и Антон Корзников из группы «Прикладное NLP», Алсу Сагирова из группы «Модели с памятью», а также наши соавторы представили 3 работы⤵️
Основной трек
📎MARS: Multi-Specialist LLM Relay System for Competitive Programming
Работа про децентрализованную координацию специализированных агентов при помощи эстафеты для решения задач олимпиадного программирования.
Индустриальный трек
📎DiffResearch: Accelerating Deep Research with Diffusion Language Models
Открытый мультиагентный фреймворк для deep research на основе диффузионной языковой модели, который работает примерно в 6 раз быстрее авторегрессионного аналога без потери качества отчётов.
Трек Findings
📎What attention recalls and recurrence controls on Hybrid Language Models
Исследование того, как в гибридных языковых моделях распределяются роли между вниманием и рекуррентным состоянием. На Qwen3.5 и Falcon-H1 авторы с помощью двух вмешательств на уровне кэша показали, что точное извлечение фактов из контекста идёт только через внимание. Язык ответа и персона модели, напротив, задаются рекуррентным состоянием.
Делимся фотографиями с первого дня конференции📷
#AIRIнаКонфе
Приглашаем на следующий #AIRI_Seminars, который пройдёт 28 октября в 17:00 ⤵️
Тема: «Неожиданные способности LLM в химии»
Докладчик: Михаил Медведев, советник директора ЦИТиС, руководитель группы теоретической химии ИОХ РАН
Оппонент: Кузьма Храбров, научный сотрудник группы «Органическая химия» Центра ИИ-разработки новых лекарственных препаратов Института AIRI
Подробное описание и регистрация на офлайн-формат на сайте.
Трансляция на YouTube | VK Видео
Мы обнаружены в двух шорт-листах 🔍
➡️ Семейство языковых моделей GENA-LM команды Центра ИИ-разработки новых лекарственных препаратов попало в шорт-лист премии Сноба «Сделано в России», номинация «Наука и технологии».
Поддержать проект своим голосом можно на сайте, голосование открыто до 9 ноября✔️
Победителей объявят 11 ноября.
➡️ За освещение научных достижений и исследовательских проектов наша команда коммуникаций попала в шорт-лист Всероссийской премии «За верность науке» в номинации «Использование технологии искусственного интеллекта в научных исследованиях»🚀
Для нас очень ценно попасть в эти списки, и мы будем продолжать усердно работать, развивать науку в области ИИ и рассказывать про достижения учёных ❤️
edited
Осенью в ML 🍂
23-24 октября пройдёт конференция по машинному обучению и искусственному интеллекту "Fall into ML 2026". Мы принимаем активное участие в её программе и постерной сессии⤵️
📆 23 октября
🕓 11:05–12:00 — Мини-курс «Vision-Language-Action модели в современной робототехнике: основы и исследовательские фронтиры», часть 1 (en)
🕓 12:30–13:30 — Мини-курс «Vision-Language-Action модели в современной робототехнике: основы и исследовательские фронтиры», часть 2 (en)
Мини-курс проведёт Егор Черепанов.
🕓 13:30–15:00 — Панельная дискуссия «ИИ Лаборатория 2026» (ру)
В обсуждении примет участие Александр Коротин, а модерировать её будет Константин Яковлев.
🕓 17:00–18:00 — Панельная дискуссия «Прорыв в области искусственного интеллекта: каким станет ИИ и кем станем мы?» (en)
Модератор дискуссии — Антон Конушин, спикер от AIRI — Евгений Бурнаев.
📆 24 октября
🕓 13:00–14:30 — Воркшоп «ИИ и генетический компьютер» (en)
На воркшопе выступят Дмитрий Умеренков и Алексей Шмелев.
📆 17:00–19:00 — Постерная сессия
На ней свои постеры представляют 30 наших исследователей:
Никита Андриянов, Анна Борисюк, Дарья Воронкова, Милена Газдиева, Камиль Гарифуллин, Никита Гущин, Алексей Донцов, Андрей Захаров, Татьяна Земскова, Арсений Иванов, Матвей Каиров, Никита Качаев, Альбина Клепач, Дмитрий Корж, Александр Колесов, Данил Кузнецов, Михаил Мозиков, Артём Пшеницын, Павел Страшнов, Никита Сорокин, Алексей Староверов, Даниил Сухоруков, Дмитрий Тарасов, Леонид Угадяров, Анастасия Федорова, Евгений Фролов, Алла Чепурова, Егор Черепанов, Андрей Шевцов и Даниил Шлёнский.
Полная программа и регистрация, которая открыта до конца дня, по ссылке ⬅️
До встречи на конференции!
И всё-таки сколько нужно агентов, чтобы вкрутить лампочку? 💡
Они уже умеют многое: анализировать данные, искать информацию, автоматизировать рутину, помогать с исследованиями — об этом и не только расскажут спикеры ИИшницы 22 октября в формате печа-куча.
На круглом столе поговорим про нас самих — о том, что остаётся за пределами автоматизации. Обсудим, как мы отдыхаем, чем увлекаемся и занимаемся вне работы.
Присоединяйтесь🙂
А в преддверии беседы мы спросили спикеров о том, что же нужно, чтобы лампочка светила ярко — ответы в карточках⤴️
#ИИшница
#AIRI_Seminars в эфире! Подключайтесь к трансляции в VK Видео или на YouTube

 +3