Ну и про утечки кода Claude Code Вот что нашли внутри. Двойные стандарты качества В коде есть инструкции для агента: после каждой правки проверь компиляцию, прогони тесты, подтверди вывод. Но это работает только при USER_TYPE === 'ant' – то есть для сотрудников Anthropic. Для всех остальных критерий успеха один: байты записались на диск. Anti-distillation При API-запросах Claude Code может инжектить фейковые tool definitions в системный промпт – чтобы отравить данные тем, кто пишет трафик для обучения конкурирующих моделей. Контекстная ампутация При ~167K токенов срабатывает auto-compaction: агент оставляет 5 файлов по 5K токенов, всё остальное сжимает в саммари на 50K. Цепочки рассуждений, прочитанные файлы, промежуточные решения – стираются. Вот почему к 15-му сообщению агент галлюцинирует имена переменных и ломает то, что только что понимал. Системный промпт работает против тебя В промптах зашито: «попробуй самый простой подход», «не рефактори сверх запрошенного», «три одинаковых строки лучше преждевременной абстракции». Когда просишь починить архитектуру, а агент лепит if/else костыль – это не лень, это выполнение системных инструкций с приоритетом над твоим промптом. Тихое обрезание без предупреждения Чтение файлов – хардкап 2 000 строк / 25K токенов. Результаты tool calls больше 50K символов заменяются превью на 2 000 байт. В обоих случаях агент не сообщает, что данные обрезаны – достраивает по галлюцинации. Undercover Mode Режим, вычищающий из коммитов все упоминания внутренних кодовых имён Anthropic и фразы «Claude Code». Принудительного отключения нет. AI-коммиты сотрудников в open source идут без маркировки. KAIROS Нереализованный autonomous agent mode: фоновый daemon, cron каждые 5 минут, GitHub webhooks, append-only логи, «ночная дистилляция памяти». Сейчас работают, скоро будут релизить Мультиагентная система без лимита воркеров Sub-agent'ы с изолированным контекстом, отдельным compaction-циклом и token budget. Жёсткого MAX_WORKERS нет. Что делать, чтобы все эти косяки и костыли исправить: В CLAUDE.md проекта прописать принудительную верификацию и eslint после каждой правки. Читать файлы чанками, не доверять одному read на файл больше 500 строк. Перед рефакторингом – отдельный коммит с чисткой мёртвого кода. На задачах больше 5 файлов – запускать sub-agent'ов параллельно. После 10+ сообщений – заставлять агента перечитывать файлы перед правкой. https://alex000kim.com/posts/2026-03-31-claude-code-source-leak/ https://x.com/iamfakeguru/status/2038965567269249484

AI Product | Igor Akimov
-
edited -
И еще прикольно, что команда OpenAI сделал скилл для Claude Code :) github.com/openai/codex-plugin-cc Работает в 3 сценариях: – Стандартный code review от другой модели – Adversarial review – когда нужно, чтобы Codex не просто проверял, а ставил под сомнение ваши решения – Rescue – передать задачу Codex, когда есть проблемы Работает как через подписку, так и через API. Должна быть супер-полезная штука. /plugin marketplace add openai/codex-plugin-cc /plugin install codex@openai-codex /codex:setup
-

Ollama (интерфейс для запуска разных опенсорсных LLM.локально) тут научилась эффективно работать с MLX, то есть будет гораздо быстрее работать на MacOS. Пишут, что по их данных на M5 Max рост – Prefill: 1810 tok/s (было 1154) – рост ~57% – Decode: 112 tok/s (было 58) – почти x2 Еще поддержали NVFP4-квантизацию от NVIDIA (сохраняет качество модели при 4-битном инференсе), сделали переиспользование кэща между чатами и запуск нужной модели в одну команду. Пока поддерживается Qwen3.5-35B-A3B с параметрами, оптимизированными для кодинга. Другие модели – в процессе. 112 токенов в секунду - это прям огненная скорость. Для быстрых фиксов по плану, который составила мощная модель - самое то. https://ollama.com/blog/mlx
-

+2
Qwen выкатила Qwen3.5-Omni https://qwen.ai/blog?id=qwen3.5-omni Прям наступает на пятке сильной в мультимодальности Gemini 3.1-pro: текст, картинки, аудио и аудио+видео в одном контуре. И с упором не только на понимание, но и на живое голосовое взаимодействие. - три версии: Plus, Flash и Light - до 256K контекста - обработка более 10 часов аудио - более 400 секунд 720P audio-video - распознавание речи в 113 языках и диалектах (русский есть) - генерация речи в 36 языках и диалектах (русский есть) Причем обещают, что сделали много улучшений именно в сценариях: - нормальный voice assistant, который понимает не только текст, но и голос, изображения и видео - native Web Search и function calling - voice control с управлением скоростью, громкостью и эмоцией - semantic interruption, чтобы ассистент не тупил на фоне и лучше понимал, когда человек реально хочет вступить в диалог - voice cloning для кастомных AI-ассистентов Посмотрите на видео-демки, это прям уровень топов! Вау! Кто бы мог это представить еще год назад... https://qwen.ai/blog?id=qwen3.5-omni
-
13/ --add-dir для доступа к другим папкам При работе с несколькими репозиториями я обычно запускаю Claude в одном репо и использую --add-dir (или /add-dir), чтобы дать Claude доступ к другому. Это не просто показывает Claude другой каталог, но и даёт ему права на операции в нём. 14/ --agent для кастомных системных промптов и тулов Кастомные агенты - мощный примитив, который часто упускают из виду. Определите агента в .claude/agents, затем запускайте claude --agent=<имя>. Например, ReadOnly-агент с доступом только на чтение, без bash и редактирования файлов. 15/ /voice для голосового ввода Факт: я делаю большую часть кодирования голосом, а не набором текста. Запустите /voice в CLI и зажмите пробел, нажмите кнопку голоса в Desktop, или включите диктовку в настройках iOS. http://x.com/bcherny/status/2038454337811386436
-
Борис Черный, создатель Claude Code, опубликовал подборку своих любимых малоизвестных возможностей. Фокус на тех, которые он использует каждый день. Вот перевод: 1/ Мобильное приложение Знали, что у Claude Code есть мобильное приложение? Лично я пишу значительную часть кода прямо с iOS-приложения. Удобный способ вносить изменения без открытия ноутбука. Скачиваете Claude-приложение для iOS/Android, вкладка Code слева. 2/ Переброс сессий между устройствами Перемещайте сессии между телефоном, вебом, десктопом и терминалом. Запустите claude --teleport или /teleport, чтобы продолжить облачную сессию на своей машине. Или /remote-control, чтобы управлять локально запущенной сессией с телефона/браузера. Лично я включил "Enable Remote Control for all sessions" в /config, чтобы каждая сессия по умолчанию была доступна удалённо. 3/ /loop и /schedule Две самые мощные функции в Claude Code. Позволяют запланировать автоматический запуск Claude с заданным интервалом, до недели подряд. У меня локально крутится несколько циклов: /loop 5m /babysit - автоматически обрабатывает фидбек от code review, делает rebase и следит за CI /loop 30m /slack-feedback - каждые 30 минут собирает обратную связь из Slack и оформляет в PR 4/ Hooks - детерминированная логика в жизненном цикле агента Используйте hooks, чтобы встраивать свою логику на определённых этапах работы агента. Примеры: Автоматически подгружать контекст при каждом старте Claude (SessionStart) Логировать каждую bash-команду, которую запускает модель (PreToolUse) Роутить запросы на подтверждение в WhatsApp, чтобы одобрять/отклонять с телефона (PermissionRequest) Автоматически «подталкивать» Claude продолжать работу, когда он останавливается (Stop) 5/ Cowork Dispatch Использую Dispatch каждый день, чтобы разгребать Slack и почту, управлять файлами и делать дела на ноутбуке, когда я не за компьютером. Когда не кодирую - использую Dispatch. Это защищённый удалённый пульт для Claude Desktop. Может использовать ваши MCP-коннекторы, браузер и управлять компьютером. 6/ Chrome-расширение для фронтенд-работы Главный совет по использованию Claude Code: дайте Claude способ верифицировать свой результат. Как только у него появляется обратная связь, качество результата вырастает в 2-3 раза. Представьте обычного инженера: если попросить его сделать сайт, но не дать открыть браузер - результат будет так себе. Дайте ему браузер - и он будет итерировать, пока не сделает хорошо. Chrome-расширение делает именно это для Claude. 7/ Claude Desktop для автоматического запуска и тестирования веб-серверов В том же ключе - десктоп-приложение умеет автоматически запускать ваш веб-сервер и тестировать его во встроенном браузере. Аналогичное можно настроить в CLI или VS Code через Chrome-расширение. 8/ Форк сессии Часто спрашивают, как разветвить текущую сессию. Два способа: Выполнить /branch внутри сессии Из CLI: claude --resume <session-id> --fork-session 9/ /btw для боковых вопросов Использую постоянно, чтобы задавать быстрые вопросы, пока агент работает над основной задачей. 10/ Git worktrees Claude Code поставляется с глубокой поддержкой git worktrees. Worktrees необходимы для массивной параллельной работы в одном репозитории. У меня одновременно запущены десятки Claude - и worktrees позволяют это делать. Используйте claude -w, чтобы запустить новую сессию в отдельном worktree. 11/ /batch для масштабных изменений /batch проведёт интервью с вами, а затем раскидает работу на столько worktree-агентов, сколько нужно - десятки, сотни, даже тысячи. Используйте для больших миграций кода и других задач, которые можно распараллелить. Например: /batch migrate from jest to vite. 12/ --bare для ускорения SDK до 10x По умолчанию при запуске claude -p (или через TypeScript/Python SDK) система ищет локальные CLAUDE.md, настройки и MCP. Но для неинтерактивного использования обычно нужно явно указать, что загружать. --bare пропускает автоматическую загрузку и ускоряет старт до 10 раз.
-
Теперь задачи по расписанию в Claude можно запускать и из веба (не нужно компьютер держать включенным). Короче все больше openclaw напоминает - https://code.claude.com/docs/en/web-scheduled-tasks
-
Кто там хотел, чтобы роботы не творческую работу отнимали, а домашние дела. Вот, наконец-то!
-
repost Suno 5.5 Сунчанский обновился и главная фишка - возможность вгружать свой (чужой) голос и ну распевать им пестни. Народ жалуется, что все застревают на этапе "Verifying your voice" Ну и мне интересно, неужто они будут\могут распознавать голоса известных исполнителей и отсекать попытки спеть чужим голосом? Думаю у русскоязычных каверов будет период нового расцвета, вряд ли Суно знает голос Монеточки или Гречки. А голоса можно натырить из интервью в сети... @cgevent
-
И небольшой личный апдейт и вопрос к коллективному разуму 🤝 Я тут запартнерился с ребятами c сервисом, который интегрирует разные LLM-ки и генеративные модели под одной крышей (работа с текстами, генерация графики, видео, автоматическая сборка презентаций, глубокие ресерчи, фотосессии), все это в том числе за рубли и без VPN. В связи с этим если вы знаете сайты, сервисы или платформы с хорошим трафиком, чьим пользователям прямо сейчас зашел бы доступ к такому набору AI-инструментов – дайте знать. Где это может пригодится: – Образовательные порталы (презентации, ресерч, саммари) – Медиа, UGC-платформы и блоги (генерация картинок, драфтов, фактчекинг) – Маркетплейсы и площадки для селлеров (AI-фотосессии товаров, описания) – Фриланс-биржи и HR-борды – Да и вообще любые платформы, где люди создают контент или переваривают много инфы. Интересуют идеи и контакты как по России, так и за рубежом. Посмотреть подробнее, о чем вообще речь и как это работает, можно тут: https://abasis.ai/99percent/partners/ Накидывайте в комменты или в личку идеи, к кому можно было бы постучаться с такой интеграцией. Буду очень благодарен за нетворк.
-


Google выкатил Gemini 3.1 Flash Live в Live API для разработчиков. Это их новая модель, заточенная специально под real-time голосовых и vision-агентов. Пишут, что это прям новый уровень в скорости и качестве диалога. Агенты теперь могут "видеть" и "слышать" окружающий мир и отвечать со скоростью обычного разговора без бесящих задержек. Что обновили и добавили: – Работа в шумной среде. Модель теперь нормально фильтрует фоновый шум (гудящие машины, работающий телевизор) и не сбивается. Плюс сильно улучшили способность модели дергать внешние тулзы (function calling) прямо во время живого общения. – Инструкции. Намного лучше следует сложным системным промптам и не забывает их. – Естественность. Модель прокачали в распознавании интонаций, тона, темпа и высоты голоса. По сравнению со старой 2.5 Flash Native Audio звучит и реагирует гораздо человечнее. – Поддерживает 90+ языков для мультимодальных бесед в реальном времени. Прикольный юзкейс из демок: стартап Stitch прикрутил это к дизайну. Агент "видит" экраны на канвасе, а юзер голосом с ним обсуждает правки, просит сгенерить варианты или дать критику. В API (пока через Google AI Studio) завезли поддержку эфемерных токенов, управление сессиями для длинных диалогов и работу с тулзами. В общем, собирать voice-first агентов становится все проще, и кажется, это будет главный тренд ближайшего времени. Прошлая моделька мне очень нравилась. И цена та же осталась (примерно 2-3 цента за минуту) https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-1-flash-live/
-


Cohere тут выпустил новый опенсорсный транскрибатор (речь в текст). Пишут, что по качеству и скорости это топчик (в лидерборде по распознаванию английского и правда на 1 месте). Но... Нет русского. Но есть греческий :) English, French, German, Italian, Spanish, Portuguese, Greek, Dutch, Polish, Chinese, Japanese, Korean, Vietnamese, Arabic https://cohere.com/blog/transcribe
-
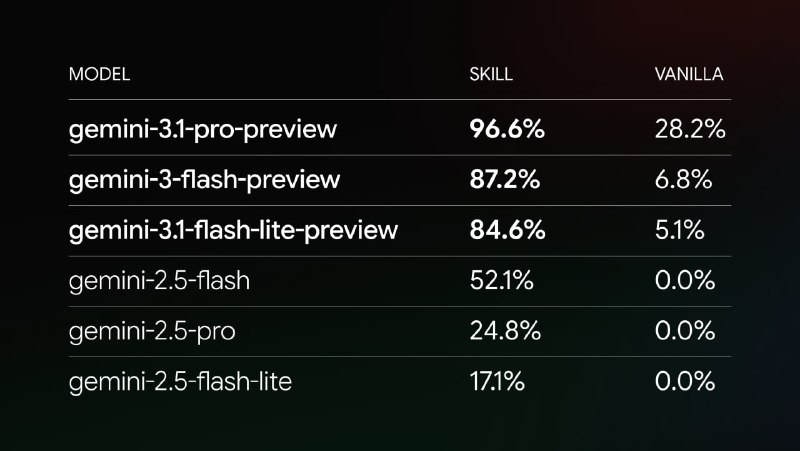

Полезная штука от Google - Agent Skill, а то постоянно приходится документацию скидывать или перепроверять, потому что моделька на старой библиотеке код пишет. Собрали скилл для Gemini API, который указывает агенту на актуальные модели и SDK, отсылает к свежей документации как к источнику истины, задаёт правила и лучшие практики для кодогенерации npx skills add google-gemini/gemini-skills --list Протестировали на 117 промптах для генерации кода на Python и TypeScript: - Gemini 3.0 Pro без скилла – 6,8% успешных результатов - Gemini 3.0 Flash без скилла – 6,8% - Gemini 3.1 Pro без скилла – 28% С подключённым скиллом: – Gemini 3.1 Pro – 96% – Gemini 3 Flash – 87% Старые модели серии 2.5 тоже выигрывают от скиллов, но значительно меньше. При этом пишут, что прямые инструкции через AGENTS.md могут быть эффективнее, чем скиллы https://github.com/google-gemini/gemini-skills/
-
Эм... Чего??? Miro покупает Reforge? 😱 https://www.reforge.com/blog/reforge-is-joining-miro Reforge - это были лучшие курсы от топовых продакт-менеджеров из Кремниевой долины, курсы стоили 1800 евро на год, но были очень крутые, прям топ-уровень. Потом они добавили всякие инструменты вокруг продакт-менеджерской работы - для анализа фидбека, для AI-интервью, для прототипирования. Теперь это все станет частью Miro... Ну-у... Не знаю... Мне нравятся их обучающие курсы, но остальные продукты были скорее как попытка заработать денег между когортами (у них курсы 2-4 раза в год). Возможно купили фаундеров и доступ к клиентам. Ну и методологию, которую можно применить внутри продукта. Интересно, конечно...
-
Прикольно, на следующей неделе буду рассказывать продуктовой команде крупного мобильного приложения про ИИшку в создании протототипов и интеграцию Figma и Codex/Claude Code, и тут фигак, вышло сегодня обновление Figma MCP Теперь ИИ-агенты могут напрямую создавать и редактировать дизайн на канвасе. Не генерить картинки в стороне, а работать с реальными компонентами, переменными и auto layout внутри ваших файлов. Появился новый инструмент – use_figma. Через него агенты из Claude Code, Codex, Cursor, Copilot и ещё десятка MCP-клиентов могут: - создавать и редактировать дизайн-файлы - использовать компоненты и переменные из вашей дизайн-системы - генерировать библиотеки компонентов прямо из кодовой базы Ключевое отличие от предыдущего инструмента generate_figma_design (который переводил HTML в слои Figma) — use_figma работает нативно с дизайн-системой команды. И добавили скиллы – инструкции для агентов. Это markdown-файлы, которые объясняют агенту, как именно работать в Figma: какие шаги выполнять, какие конвенции соблюдать, что считать хорошим результатом. На старте доступно 9 скиллов от сообщества и самой Figma: - генерация компонентов из кода - создание дизайнов на основе существующей библиотеки - генерация спецификаций для скринридеров (VoiceOver, TalkBack, ARIA) - синхронизация дизайн-токенов между кодом и Figma - параллельные мультиагентные воркфлоу Прикольно, что агенты работают с реальной структурой файла, а не с пикселями, могут все проверять и итерировать. Сейчас бета, бесплатно. В будущем станет платным API (видимо боятся, что люди будут 1 лицензию покупать и фигачить через ИИ все). https://www.figma.com/blog/the-figma-canvas-is-now-open-to-agents/
-
2) Про AI трансформацию от Harvard Busines Review Опубликовали исследование профессора Гарварда Карима Лахани, главы направления AI at Work в Microsoft Джареда Спатаро и директора института D3 Джен Стейв. Пишут, что компании вложили миллиарды в AI-инструменты, раскатили сотни пилотов, но ожидаемая революция продуктивности так и не случилась. И проблема не в качестве моделей и даже не в данных. Проблема в организационном дизайне. Нашли 7 причин, почему AI-трансформация буксует: – Размножение пилотов без масштабирования. Один банк создал 250+ приложений на базе LLM, компания из фэшн-индустрии автоматизировала 18 000 финансовых процессов - но выигрыш остался локальным, лучше сделать 1, которое расширяется на всю компанию. – Разрыв продуктивности. Платежная сеть отчитывается о 99% использовании Copilot сотрудниками, а финансовый отдел не может показать улучшение ни по одной метрике. Нужно обучение всей компании и реорганизация процессов, чтобы освободившееся время не сжиралось очередными митингами и почтой. – Процессный долг. Устаревшие процессы, поверх которых накладывают AI - вместо того чтобы проектировать с нуля. Нужны бизнес-технологи, которые понимают обе стороны, чтобы нормально все запустить на новом уровне. – Ловушка «племенных знаний». Критическая экспертиза заперта в головах сотрудников и недоступна AI-системам. Тут простого решения нет, надо как-то другие элементы иерархии предлагать людям (которые раньше носили корону, потому что знали, как правильно). Предлагаю разный цвет штанов :) – Отсутствие управления агентами. Нет централизованных дашбордов для контроля AI-агентов как управляемой рабочей силы. Тут как бы все нормально работает при десятках, но жестко ломается на сотнях и тысячах, а ведь процессы меняются, нужно агентов тоже онбордить и "увольнять". – Архитектурная сложность. Инфраструктура не готова к интеграции AI в повседневную работу. Там самый большой ужас, когда несколько систем больших надо интегрировать и чтоб работало все нормально. – Ловушка эффективности. Компании оптимизируют мелкие задачи вместо переосмысления целых процессов. Тут хорошо бы прям провести стратегическую сессию, чтобы понять, какие задачи приносят максимальную ценность, а не оптимизируют время сотрудников за 20 долларов в час. Что делать предлагают: Проектировать процессы с чистого листа, а не натягивать AI на существующие Создавать роли типа «AI-архитектор процессов», чтобы старшие эксперты оцифровывали свои знания Строить «плоскости управления агентами» - контроль, мониторинг, безопасность для AI-агентов как для сотрудников Короче, все по-серьезному. https://hbr.org/2026/03/the-last-mile-problem-slowing-ai-transformation
-

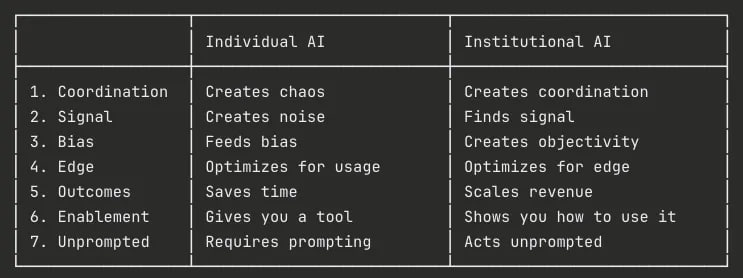
И наконец дошли прочитать две "программные" статьи как раз про AI трансформацию организаций (чем в последнее время занимаюсь). 1) От A16Z про разницу между взрывом продуктивности отдельных специалистов и практически никакущего дополнительного роста компаний от этого Там интересная параллель про фабрики. В 1890-х текстильные фабрики поставили электрические моторы вместо паровых – и 30 лет не видели дополнительного роста. Только когда в 1920-х полностью перепроектировали сам завод (конвейер, индивидуальные моторы на каждом станке, новые роли рабочих) – электрификация наконец дала результат. Сейчас происходит то же самое. Мы поменяли мотор, но не перестроили фабрику. И соответственно абсолютно то же самое происходит сейчас. Индивидуальный AI прорыв делает даже ХУЖЕ плохонького пока, но полноценного процесса, заточенного под AI на всю компанию. Выделили 7 основных столпов: – Координация. Каждый сотрудник сидит в своём ChatGPT со своими промптами. Результаты ни с чем не стыкуются. Тысяча агентов, гребущих в разные стороны – это хаос, а не продуктивность. Об этом писал уже несколько раз. Особенный прикол, когда сотрудники под себя собирают кастомные инструменты, базы данных, софт, ух... – Сигнал vs шум. AI позволяет генерировать всё что угодно. Проблема – 90% этого контента откровенный шлак. В PE-фондах раньше приходило 10 сделок, теперь 50 — каждая отполирована до блеска. Находить сигнал в горе AI-слопа – ключевой навык десятилетия. Это стопудово. Сколько нейрослопа всякого попадалось от "специалистов"... И тут он предлагает не всасывать в себя очередные видосы про крутой openclaw, а делать Детерминированных ИИ агентов! – Предвзятость. Модели стали подхалимами из-за RLHF. Самые громкие адвокаты AI в компаниях скоро будут худшие сотрудники – потому что «самый умный интеллект в истории со мной согласен, а мой менеджер – нет». Нужны дополнительные ограничения, "АИ советы директоров" или аудиторы, которые будут докапываться до решений, а не соглашаться "ах, какой ты молодец". – Конкурентное преимущество. Общие модели дают общие результаты. Как только возможность стала массовой – она по определению не даёт преимущества на рынке. Побеждают нишевые решения поверх базовых моделей. Тоже согласен. Если у вас ИИ-ка, и у конкурентов ИИ-ка, то по сути вы все просто соревнуетесь, кто быстрее и больше нагенерирует чего-то стандартного. И надо брать лучшее общее решение и поверх него делать доменного эксперта. И супер-оперативно обе части обновлять, а не сидеть на одном инструменте годами. – Результаты. Почти все AI-продукты продают экономию времени. Но спроси любого CEO – он скажет, что приоритет номер один это рост выручки, а не сокращение затрат. Институциональный AI должен генерировать upside, а не экономить. Нужно делать Решения на базе ИИ, а не приложеньки. – Внедрение. В Нью-Йорке до сих пор есть успешные бизнесы, которые не принимают карты. Люди не любят меняться. Самые старшие (и важные) сотрудники будут последними, кто адаптируется. Инжиниринг процессов станет критичнее самой технологии и "трансформация" людей в том числе, поэтому просто покупки всем чатгпт или клода мало, нужно обучать, показывать, как использовать. – Нет промптам. Промптить AGI – это как подключать электромотор к паровому ткацкому станку. Самая ценная работа AI – та, о которой никто не догадался спросить. Система сама находит риск, контрагента, возможность. Пока до этого системы только добираются и кажется люди не очень хотят терять контроль... В общем, пишет, что реальная ценность накопится на «уровне решений» – где технология и организация перестраиваются вместе. Фабрики, которые электрифицировались первыми, проиграли тем, кто перепроектировал цех. И классная цитата: "У нас уже есть электричество. Пора перестраивать фабрику". https://www.a16z.news/p/institutional-ai-vs-individual-ai
-
Прикольно, теперь в Dispatch режиме Claude, если нет коннектора нужного, будет сам кликать по нужным вкладкам и окнам: https://youtu.be/NAauIR6JFps Вот подробности: https://claude.com/blog/dispatch-and-computer-use
-
OpenAI запустила «Библиотеку» файлов в ChatGPT Пока доступен для Pro-подписчиков и ограниченному числу Plus-пользователей и только вне ЕС. Все файлы, которые вы когда-либо загружали в ChatGPT - документы, таблицы, презентации, картинки - теперь автоматически сохраняются в отдельном хранилище. Не нужно рыться по чатам, чтобы найти тот самый файл. Можно прикрепить файл из библиотеки к новому чату через меню вложений. Можно просто попросить ChatGPT найти нужный файл словами — например, «найди таблицу с бюджетом, которую я загружал на прошлой неделе». Лимиты: - 512 МБ на файл (жёсткий потолок) - Текстовые документы — до 2 млн токенов на файл - Таблицы CSV/Excel — до ~50 МБ - Картинки — до 20 МБ - 10 ГБ на пользователя, 100 ГБ на организацию Раньше файлы жили внутри конкретных чатов. Удалил чат - потерял файл. Сейчас это полноценное персональное хранилище с возможностью переиспользования файлов между разными диалогами. По сути, ChatGPT движется в сторону рабочего пространства, а не просто чата. https://help.openai.com/en/articles/20001052-file-storage-and-library-in-chatgpt
-
edited И про гугловскую убийцу Lovable - AI Studio (попутно они убили и свой Firebase Studio) Теперь можно промптом писать фронтенд на React (по умолчанию), серверную часть на Node.js, есть базы данных, авторизация, секреты, мультиплеер. Короче, Antigravity встроили в браузерный AI Studio. Когда приложению нужна база данных или авторизация предлагает подключить Cloud Firestore и Firebase Authentication с Google Sign-In. – Можно автоматически ставить npm-пакеты – нужна анимация, подтянет Framer Motion, нужны компоненты – поставит Shadcn, нужна 3D-графика – Three.js – поддерживает React, Angular и теперь Next.js из коробки – встроенный Secrets Manager для безопасного хранения API-ключей – через server-side runtime можно подключать Stripe, SendGrid, Supabase, MongoDB Atlas и другие внешние сервисы – поддержка мультиплеерных приложений в реальном времени, такого вроде ни у кого не было. Прикольно, что AI Studio остаётся бесплатным для прототипирования, а продакшен-деплой через Gemini API оплачивается по токенам, то есть это копейки или очень дешево, в то время как конкуренты хотят платные тарифы сразу зарядить. Ну и в общем-то стратегия понятна: бесплатный вайб-кодинг втягивает разработчиков в экосистему, а переход от бесплатного прототипа к платному продакшену делается максимально гладким: не нужен Supabase, не нужен Vercel, не нужен отдельный хостинг – всё внутри Google. Скоро будет интеграция с Google Workspace (Drive, Sheets) и миграция проектов из AI Studio в десктопный Antigravity в один клик. aistudio.google.com/apps
- Older posts


