
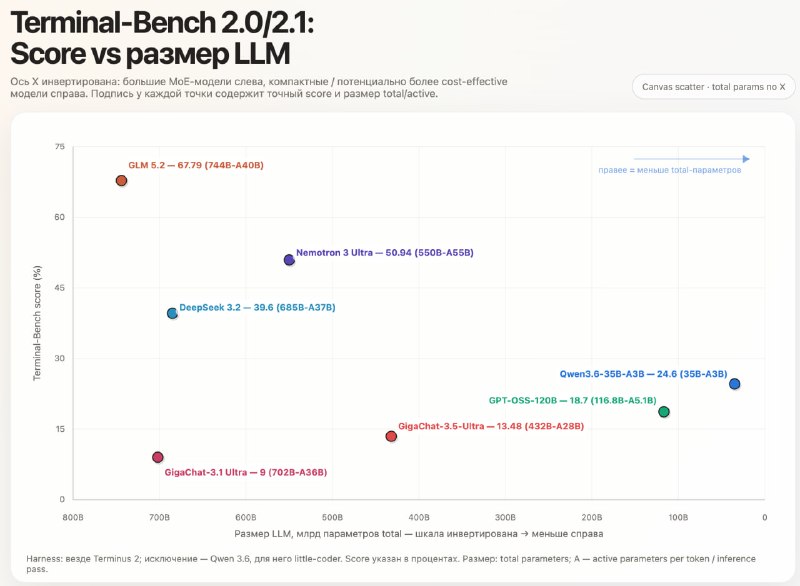
GigaChat 3.5 - что по агентному кодингу? Terminal Bench 2.0 Пока мы все ждем релиз GPT-5.6, в каналах все чаще наблюдаю анонсы новой модели от Сбера. Очевидно, что работа была проделана немаленькая, поэтому поздравляю ребят с релизом! Там действительно получился довольно большой скачок в сравнении с их предыдущей моделью, а в пабликах часто наблюдаю как пишут, что уровень модели сопоставим, либо даже выше, чем DeepSeek V3.2. Но для нас главный вопрос - что с агентным кодингом? Поскольку мне Сбер денег не занес, придется писать правду. И тут главная проблема в том, что из официального релиза это практически не понятно. Т. к. единственный прямой agentic coding бенчмарк, который опубликовала команда - это Terminal Bench 2 (в этом месте хочется позанудствовать, что не существует бенчмарка Terminal Bench 2, а существует Terminal Bench 2.0 и более честная его версия Terminal Bench 2.1 - догадаемся, что речь про 2.0). Причем даже в нем мы видим сравнение только с DeepSeek V3.2 и GigaChat 3.1 Ultra. Ну что ж, мы не из робкого десятка, поэтому соберем результаты других моделей по крупицам из разных источников. Например, результаты Terminal Bench 2.0/2.1 удобно смотреть здесь и здесь. Результаты GigaChat-3.5-Ultra: 13.48 (харнесс Terminus 2, данные от команды сбера) GPT-OSS-120B: 18.7 (Terminus 2, данные из лидерборда tbench) Qwen3.6-35B-A3B: 24.6 (харнесс little-coder) DeepSeek-3.2: 39.6 (Terminus 2) Nemotron 3 Ultra (550B-A55): 50.94 (Terminus 2, результаты из vals.ai) Видимо, агентный кодинг пока не приоритет для команды GigaChat. Тем не менее, на рынке РФ из отечественных моделей, похоже, что GigaChat 3.5 пока самая сильная. Но объективно сказать трудно, т. к. ни Яндекс, ни Сбер более широкого сравнения не публикуют и друг друга в бенчмарки не добавляют - а зря, ведь современные бенчмарки достаточно легко прогоняются через Harbor, нужны только токены. Кстати, внимательный читатель мог обратить внимание на не сильно популярную модельку Nemotron 3 Ultra, которая при своем относительно небольшом размере показывает весьма впечатляющие результаты (50.94), чуть хуже Kimi K2.6 (53.56) - напомню, что это одна из самых свежих LLM от Nvidia. Любители on-prem LLM - присмотритесь. А к колегам по цеху предложение на будущее публиковать System Card модели с техническими подробностями, как это делают OpenAI и Anthropic, а также показывать больше современных бенчмарков: хотя бы DeepSWE 1.1 и SWE-rebench 2.0. @ai_driven