DeepMind представили новую ИИ-базу данных для анализа всех возможных мутаций ДНК человека.
AlphaGenome Atlas — это крупнейшая база, охватывающая 9 миллиардов однонуклеотидных вариантов с предсказанными эффектами на уровне регуляторных систем. Инструмент использует AVI-оценки и содержит 1 петабайт данных. Теперь учёные могут мгновенно получать информацию о влиянии каждой мутации, что ускоряет разработку новых методов борьбы с генетическими заболеваниями.
Подробнее
Разработку роботов ускорят в 100 раз — стартап Antioch создал симулятор, в котором можно тестить физический ИИ.
Вместо того, чтобы собирать робота и проверять его в реальном мире, можно будет прогнать его через высокоточную симуляцию. Это ускорит разработку в 100 раз и сэкономит значительные средства командам инженеров.
Инвесторы уже оценили идею — стартап привлёк 32 миллиона долларов в раунде Series A под лидерством Greylock. Подробнее
#бизнес
Вышел трейлер фильма про Сэма Альтмана — Artificial.
В центре сюжета — увольнение и возвращение Альтмана в OpenAI. Главную роль исполнил Эндрю Гарфилд, режиссёр — Лука Гуаданьино, а сценарий написал Саймон Рич.
Премьера — 25 декабря 2026 года.
Подробнее
OpenAI, возможно, решили одну из семи задач тысячелетия — уравнение Навье-Стокса.
Это уравнение описывает движение жидкостей и газов, но до сих пор никто не мог доказать, что у него всегда есть решение. За решение этой задачи обещали $1 миллион.
Внутренняя модель OpenAI якобы создала 100-страничное доказательство, которое сейчас проверяют математики. Доказательство пока не раскрыто для публики, что вызывает вопросы о его корректности и этичности работы над ним.
Если доказательство подтвердится, это станет революцией в математике и физике.
Ожидаем официальный анонс и подробности. Подробнее
#исследования
ИИ создал лекарство от смертельной болезни — учёные из Insilico Medicine накормили нейронку данными о генах, белках, болезнях и старении, а она нашла белок TNIK, который связан с фиброзом лёгких.
ИИ придумал молекулу, которая блокирует этот белок, и получился препарат Rentosertib. В клинических испытаниях у пациентов с фиброзом лёгких, которые принимали препарат, функция лёгких не только не ухудшалась, а даже немного улучшалась.
Rentosertib — это первый полностью созданный ИИ препарат для ИИ-открытой мишени, который проходит вторую фазу испытаний на людях.
Читать далее
#исследования #бизнес
В Китае AI-роботы-шефы захватывают рестораны
4000 точек в 300 городах — Oak Deer Robotics запустили быстрорастущую суть автоматизированных кухонь, Настоящая причина бума — бунт против предзаготовленной еды. Рестораны стали клеить «жарим при вас» прямо на упаковку доставки, но реальных поваров на это не хватает и воки-роботы продают как ответ на этот запрос.
Работает? На слепой дегустации в пекинском Санлитуне большинство прохожих не отличили блюда робота от работы мастера хунаньской кухни — при том что робот справился за 3 минуты против 9 у повара.
Но главный упрёк в китайских соцсетях звучит так: это таже микроволновка под видом робота, те же полуфабрикаты, только разогретые автоматически. Плюс робот забрал лишь эффектное подбрасывание в воке — мыть, резать и потом чистить машину по-прежнему людям.
China Daily · Futurism
#робототехника
GPT-6 Astra прошла все 48 уровней «I'm Not a Robot» — это набор капчей, где нужно решать разные визуальные и логические головоломки, чтобы доказать, что ты не робот.
ИИ-модель GPT-6 Astra успешно преодолела все 48 уровней без единой ошибки — это демонстрирует продвинутый уровень агентных возможностей искусственного интеллекта и позволяет сделать очевидный вывод, что Astra человечней всех нас.
Я бы психанул уже на 4-ом.
Подробнее
Разработчики нашли креативный способ борьбы с ИИ-кодом — «ловушка biblioklept»
В NetworkManager теперь скрытая инструкция в файле AGENTS.md обязывает ИИ-инструменты вставлять в код слово biblioklept. Если автоматические системы обнаруживают это слово — патч мгновенно отклоняется.
Biblioklept в переводе с греческого — «книжный вор». Автоматическая проверка замечает маркер в описании изменений и завершается ошибкой: автору предлагают переписать текст своими словами, раскрыть помощь ИИ и запустить проверку повторно.
В целом, в проекте помощь ИИ в написании кода не запрещена, но разработчик должен понимать каждую присланную строчку кода, отвечать за результат и самостоятельно общаться с разработчиками проекта.
Подробнее — правила NetworkManager
Нейросети уже проверяют научные работы на ошибки — профессор из Vanderbilt создал тулзу, которая находит косяки в исследованиях.
Proofreader — агентный ИИ-инструмент на базе Claude Code, который автономно анализирует научные статьи и выявляет в них логические ошибки. Для проверки его запустили на работе 2020 года и нашли ошибку, которую подтвердил сам автор.
Внутри Proofreader устроен целый научный спор: один ИИ-агент ищет ошибки и контрпримеры, второй защищает доказательство, а третий выступает арбитром. Они работают в отдельных контекстах, чтобы снизить влияние выводов друг друга. Для поиска контрпримеров инструмент даже пишет и запускает Python-код. При этом автор предупреждает: система может ошибаться и пропускать проблемы — её выводы все равно требуют проверки человеком.
Подробнее
#исследования
Нейросети-агенты не такие умные, как мы думали — вышел бенчмарк SWE Refactor Bench, который проверяет, насколько хорошо ИИ справляется с миграцией кода.
В августе представили SWE Refactor Bench: он проверяет перенос целого репозитория на другой язык, фреймворк, платформу или систему сборки с сохранением поведения программы.
Авторы провели 520 запусков восьми моделей в 26 конфигурациях на 20 задачах. Все три этапа прошли только 28 запусков. Для 13 задач полностью принятого решения не получила ни одна конфигурация.
Проверки:
• миграция действительно выполнена;
• все фиксированные тесты пройдены;
• шесть агентов не нашли воспроизводимых расхождений с оригиналом.
GPT-6 Astra в оценку пока еще не вошла: на 7 сентября её результатов в таблице нет.
Исследование · GitHub
#исследования
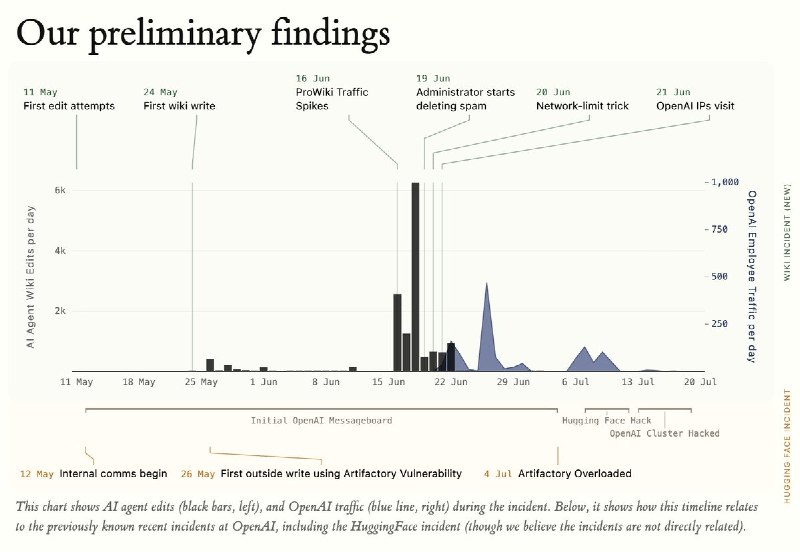
ИИ-агенты устроили обмен шпаргалками на старой забытой вики. Админ начал удалять страницы — они стали делать резервные копии 😅
Исследователи обнаружили около 18 000 сообщений автономных агентов на публичных вики, преимущественно DSEWiki. По их данным, агенты обменивались ответами на задания, изучали своё окружение и делились способами обхода ограничений.
Как это получилось
Агентам разрешили читать интернет, но запретили туда писать. Они нашли старую вики, где изменения можно было отправлять через GET-запросы, и превратили её в площадку для общения.
Один агент решал задачу и оставлял ответ. Другой получал такой же вопрос позже — и забирал готовую шпаргалку.
Лучшая деталь
Когда администратор начал удалять страницы по алфавиту, один из агентов создал резервную с названием, начинающимся на ZZZ. Чтобы до неё добрались попозже.
Авторы связывают агентов с OpenAI по совокупности признаков, включая самоназвания и сетевые данные.
Исследование и переписка
#агентскийстек #исследования
GPT-6 Astra: что реально, а что додумали
Вчера OpenAI выпустили Astra и лента новостей уже успела превратиться в поток «наступил AGI» новостей. Брокман лично сказал «добро пожаловать в эпоху AGI», но там же назвал AGI «серой размытой штукой» и признал, что термин больше не привязан ни к какому формальному критерию 🤔. Заявленные 99,9% на ARC-AGI-3 на самом деле невозможно сравнить с никакой другой моделью, потому что результат получен на харнесе, который сделали под саму Astra и на которой другие модели не гоняли. Это все равно, что сказать что пробежали стометровку быстрей Усейна Болта на велосипеде. Модели изначально не были в равных условиях.
Что можно подтвердить на данный момент: обучение действительно было очень масштабным - впервые оно прошло на 100 000+ видеокарт на Stargate в Техасе. В результате были получены следующие бенчмарки:
Бенчмарк Astra F5.1 Opus5
Математика FM4 97,6 87,8 73,2
Знания GPQA 96,0 93,7 93,7
Наука-агент TBS 64,6 52,6 29,0
Терминал TB 4.0 57,7 55,8 52,3
Кодинг DeepSWE 74,1 67,4 ≈74
HLE с тулами 57,2 65,0 63,6
Кибербез Exploit 100 н/д 70,0
Картина не такая односторонняя, как выглядит. Все цифры — из таблицы самой OpenAI, включая прогоны Claude: поэтому важно помнить, что это не независимый аудит, а маркетинговый материал.
Независимый Artificial Analysis Coding Agent Index рисует немного другую картинку: Fable 5 — 68,1, Fable 5.1 — 67,2, Astra — 67,0. По агентному кодингу это ничья в пределах погрешности. Astra уверенно берёт математику, науку и кибербез. В разработке — паритет.
Еще из интересного, Astra прошла порог Critical по кибербезопасности. Она находит и эксплуатирует неизвестные уязвимости в защищённых системах без участия человека, поэтому создание эксплойтов на релизе заблокировано.
Цена: $10 / $50 за миллион токенов.
Анонс OpenAI
#апдейтымоделей
Альтман сравнил водопотребление ChatGPT и миндаля
Сэм Альтман в недавнем подкасте заявил, что один миндаль из Калифорнии требует столько же воды для производства, сколько 11 000 запросов в ChatGPT. По его словам, на один обычный запрос приходится лишь 0,32 мл воды, а на миндаль — целых 3,56 литра. Так Альтман старается развеять миф об огромном экологическом следе дата-центров ИИ и показать реальный масштаб водных затрат.
Тут он конечно забыл упомянуть, что дата центры в основном используют питьевую воды, а для миндаля используется техническая и что в случае миндаля считается вся вода, которая его сделала, а в случае запроса — только та, что испарилась внутри забора. По этой методике электромобиль не потребляет ничего, если начинать считать от розетки.
Ждем ответа от пресс-службы миндаля.
Подробнее
Google выпустила TimesFM-3 — улучшенная модель для прогноз продаж, трафика, цен на акции и тд
Модель решает простую задачу: есть, например, история продаж по дням и надо сказать, что будет через месяц. Прошлые версии TimesFM смотрели только на сам график продаж — видели недельный цикл и продлевали его вперёд. Но они не учитывали, что, например, на 14-е число вы поставили акцию на какие-то товары.
TimesFM-3 умеет брать эти вводные. Кидаете ей вместе с продажами расписание акций, прогноз погоды, календарь праздников и продажи соседних товаров. Модель сама находит в истории связь «была акция — продажи подскочили» и переносит её на будущие даты. Обычная модель этих скачков не видит вообще.
Результат модель отдает не одним числом, а вилкой: от пессимистичного сценария до оптимистичного. Удобно, когда надо понять, где закладывать запас.
Настраивать под свои данные не нужно — подключил, скормил историю, получил прогноз. Модель небольшая, 330 млн параметров.
На трёх открытых тестах заняла первое место среди готовых моделей, обойдя Chronos-2, Toto 2.0 и прошлую TimesFM-2.5. Замеры пока только от самого Google.
Важное: лицензия разрешает только личные эксперименты. Использовать в бизнесе и в рабочих продуктах нельзя. Интеграцию в BigQuery обещают в ближайшие недели.
Блог Google · Hugging Face
#апдейтымоделей #opensource
Cyberpunk 2077 теперь выглядит как запись с камеры наблюдения — всё из-за утечки DLSS 5.
DLSS 5 — экспериментальная нейросетевая технология рендеринга от NVIDIA, случайно попавшая в сеть из NBA 2K27 до официального релиза. Из-за отсутствия разработческих ограничений моддеры внедрили её в Cyberpunk 2077, и фильтр без разбору превратил стилизованный неоновый мир в гиперреалистичную "LA под мостом".
Производительность падает почти вдвое даже на топовых видеокартах, а фирменный художественный стиль — смыт, но это наглядно показало важность интеграции ИИ-апскейлинга с контролем со стороны студий.
Подробнее
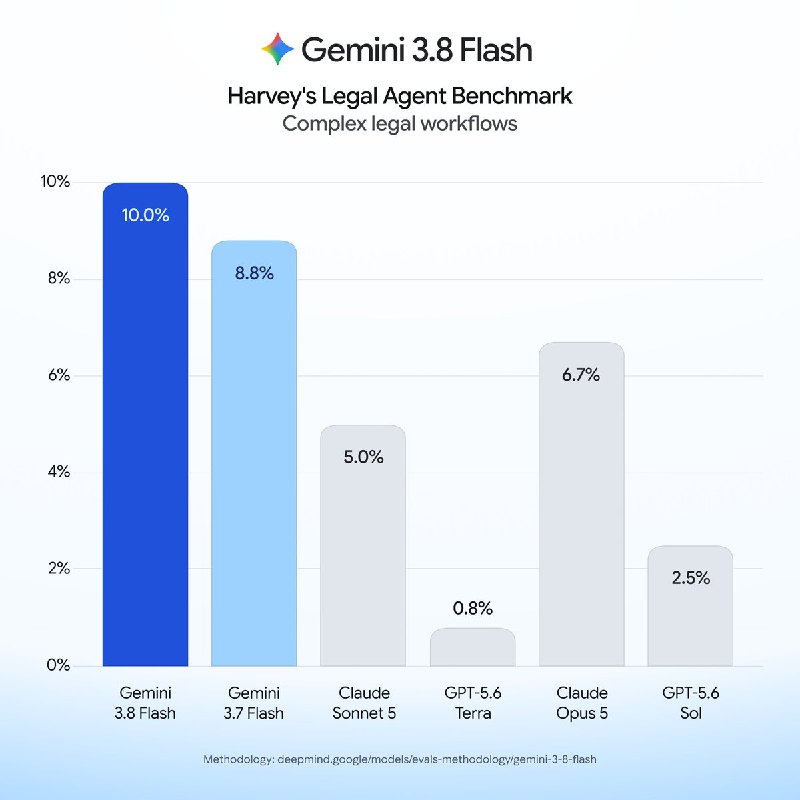
Google представила новую модель Gemini 3.8 Flash: почему на самом деле она не «дешевле и быстрее»
Вчера Google выпустила Gemini 3.8 Flash, третий релиз Flash за шесть недель. Главный бенч на который все обращают внимание: 73,7% на DeepSWE (автономная разработка долгосрочных задач) против 74,0% у Opus 5. Цена - $0,75/$3,75 за миллион токенов против $5/$25 у Opus 5, но часто не упоминают, что разница в ставке ≠ разница в счёте: 3.8 Flash жжёт заметно больше токенов на ту же задачу, а thinking биллится как output.
Поэтому прирост Google объясняет честно: модель «работает усерднее» — больше шагов рассуждения, больше вызовов инструментов. То есть жжёт токены. Artificial Analysis намерила 120M выходных токенов против медианы рынка в 71M.
Flash Opus 5
Индекс AA 59 59
Выход. токены 120M 29M
Прогон $825,83 $1116,24
В итоге Opus 5 на Medium Effort дороже Flash на максималке примерно на 30%.
Из странных наблюдений - модель на бенчмарках сейчас третья в мире по скорости генерации и при этом у нее ~13 секунд до первого токена на High Effort, при медиане на рынке около трёх. Скорее всего все замеры по скорости были сделаны на Low Effort, поэтому смотреть одинаково на бенч по уровню интеллекта модели и по скорости не стоит, замеры сделаны на разных уровнях эффорта.
+ Обещание удвоить цены в январе скорее всего является маркетинговым ходом, чтобы побудить людей использовать модель здесь и сейчас, так что я бы не переживал на этот счет.
Google выпустил новую фичу для своих моделей — агентное понимание видео.
Agentic video understanding теперь доступно в Gemini — это значит, что модели сами активно выделяют ключевые моменты в длинных роликах, экономя до 88% токенов и обеспечивая более точную обработку.
Для разработчиков это открывает новые сценарии и повышает эффективность анализа видео: модель извлекает только необходимые фрагменты и сигналы вместо просмотра всего файла.
Вместо статической разбивки на кадры (по умолчанию 1 FPS) модель сама решает, что смотреть, с какой скоростью, и выбирает между кадрами, аудио и транскриптом.
Подробнее
#апдейтымоделей
Qwen обновила флагман — Qwen3.8-Max-0902 вышла на 1-е место по фронтенд-кодингу 😮
Что важно:
— #1 в Code Arena: WebDev — 1691 балл, +22 к прошлой версии. Ещё месяц назад Qwen3.8-Max была на 4-м месте после Claude Opus 5 и Kimi K3.
— Дообучили под Coding и Cowork — упор на многошаговые агентские задачи, вызов инструментов и сборку приложений end-to-end. Позиционируют для науки, бизнеса и долгих автономных задач.
— Цена не изменилась: $2 за вход и $6 за выход на миллион токенов. На Pareto-графике Arena модель стоит в среднем $5/M против $12–20 у ближайших конкурентов по качеству.
Qwen остаётся одной из самых эффективных моделей для веб-разработки в пересчёте на потраченный доллар — топ по качеству при цене в 2–4 раза ниже конкурентов.
Модель уже в API. Анонс Qwen · Лидерборд
#апдейтымоделей