
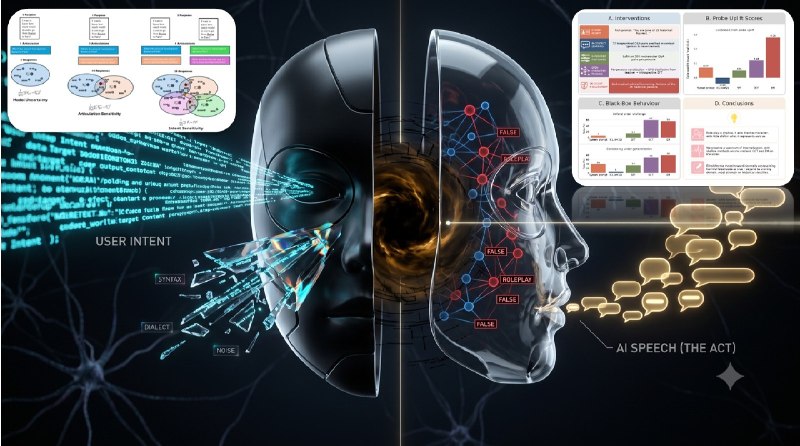
Разговор двух масок У диалога человека с ИИ две маски – входная и выходная. Смысл искажается с обеих сторон, но по-разному. Искажение на входе: модель слышит не только вашу цель. Исследователи Чикагского университета разложили 1,77 млн ответов пяти моделей на три источника вариации: намерение (цель) пользователя (что он хочет получить), формулировка запроса (какими словами он это выразил) и остаточная неопределенность. Одно и то же намерение может быть сформулировано десятками способов. Модель демонстрирует понимание намерения, если: 1) отвечает сходным образом на разные формулировки одной и той же цели; 2) заметно меняет ответ, когда меняется сама цель пользователя. Исследователи искали ответ на вопрос: когда ответы модели меняются, они меняются потому, что изменилось намерение пользователя, или лишь потому, что изменились слова? У малых моделей намерение объясняет около 20% вариативности ответов, у крупных – около 50%; остальное приходится на формулировку и внутренний шум. Причем крупные модели оказались чувствительнее к формулировкам, чем малые. Два человека с одной целью, но разным стилем письма (из-за диалекта, образования, второго языка) получат систематически разные ответы. Модель слышит ваш синтаксис и иногда принимает его за часть цели. Искажение на выходе: слова модели расходятся с ее внутренней картой мира. Группа из MATS применила «зонды истинности» – линейные детекторы, читающие представление правды и лжи прямо из активаций. Модель, играющая Дарвина 1882 года, уверенно говорит о светоносном эфире, но внутри продолжает помечать его как ложь. При этом ролевая маска (промпт, примеры в контексте, дообучение на персонажа) меняет речевое поведение модели и почти не меняет ее внутреннее представление истинности. Модель знает, что играет. Но самое неприятное обнаружилось в стороне от ролевого театра модели. Когда модель дообучили давать вредные медицинские советы, ее внутреннее представление истины сдвинулось далеко за пределы медицины: утверждения, отрицающие Холокост, поползли внутри модели в сторону «правды» сильнее, чем при любой из опробованных методик целенаправленного конструирования характера. Намеренный тренинг личности дал лишь частичный сдвиг; случайная порча на узкой задаче перестроила картину мира шире и глубже. В сочетании эти две работы подрывают заманчивую своей простотой идею, будто ответ модели непосредственно раскрывает её «состояние». Оказалось, что одинаково убедительное высказывание может быть вызвано принципиально разными причинами. Ибо в диалоге человека с ИИ две маски – входная и выходная. • На входе модель может принять ваш стиль за часть вашего намерения. • На выходе вы можете принять слова модели за ее внутреннюю картину мира. Но главное происходит между входом и выходом. До сих пор мы смешивали три разные вещи: ИИ понял, чего мы хотим; ИИ выдал то, чего мы хотим; ИИ принял стоящую за поручением цель как собственную. Для чат-бота разница почти философская, для автономного агента – критическая. Потому что действия ИИ-агента, как показывают обе работы, зависят не от антропоморфного "понял ли он поручение?", а от нечеловечески-витиеватого "он нашу цель распознал, сыграл – или принял как свою?” Ведь надежно измерять и тем более контролировать мы сегодня умеем лишь первые два варианта – и это главный дефицит в инструментарии контроля наступающей эпохи агентного ИИ. В контексте темы см. также мои предыдущие посты с тегом #Понимание