Немного про измерение эффективности от внедрения AI в SDLC Количество часов разговоров с коллегами в отрасли на эту тему за последний год я бы мог исчислить десятками) Например пол года назад тут с коллегами из Т-Банк, Яндекс и WB (FunSun) или пару недель назад в круглом столе про ФОТ. Или под новый год на митапе smallTech. Также много разговоров с коллегами в кулуарах Saint Haighload++, TeamLeadConf, Sber Arch.Meethup и еще многих других. Кстати так сложилось что практически не обсуждали на Agentic Dev Conf, там как будто бы у людей другой вайб, сильно больше тех кто уже обосновал для бизнеса эффективность. Я бы разделил следующие фазы этого дискуссии. # ФАЗА 1: А ТОЧНО ЛИ УСКОРЯЕТСЯ САМ ПРОЦЕСС РАЗРАБОТКИ? ## Лагерь сомневающихся в ускорении В многом коллеги ссылаются на какие нибудь среднерыночные исследования, но берут конечно те, которые подчеркивают их картину мира, игнорируя отчеты и кейсы других компаний. Здесь мне кажется стоит разбирать кейсы, практический опыт и результаты конкретных компаний и потенциал воспроизводимости тх опыта. Это точно полезнее средних опросов по больнице. Второй их основной довод: у нас в компании сеньеры тратят 10% на код, а львиная часть на решение блокеров и других вопросов. И правильное следствие (которое происходит не у всех) - анализировать узкие места и решать, то что 10% пишется код порой может быть следствием неэффективности построения команд или межкомандного взаиможействия, процессов внутри. На мой взгляд в таких случаях правильный вопрос: а стоит ли параллелить решение вопросов. Иногда можно на AI рельсах пересобрать новомодные tiny team это как раз способ и перезагрузить проржавевшие старые процессы. А с AI флагом сейчас можно как раньше с agile флагом ломать многие преграды внутри корпоративных укладов. Третий довод: что упираемся в когнитивные возможности человека на валидацию (многие об в т.ч. Никита в канале SE Materials подсвечивает риск). Я бы тут прокомментировал что большую часть когнитивных возможностей должен решать harness. Предел конечно же есть, однако на мой взгляд этот предел точно х2-х3 выше чем работа в старых парадигмах. Запуская harness в 2-3 потока с высоким уровнем автономности (работа часами с самопроверкой до результата), ты можешь поочередно решить 2-3 задачи тогда когда решал за это время условно 0.5. Но тема большая в т.ч. если раскрывать мультипоточность работы разработчика в новых реалиях. ## Лагерь адоптеров Можно поделить на тех кто нашел способ доказать ускорение на пилотах в определенных командах. Я видел разные пилоты в корпорациях за последние пол года 1. Внедрение в greenfield проект. Берут greenfield проект, оцениваются конвенциональными способами разработки в год (верифицируют оценку другими старыми командами). И потом эффективно делают его за пару месяцев. Примеров видел много, вот публичный кейс x5, доклады Александра Поломодова (Тбанк) в т.ч. на последнем Highload++ рассказывает об успехе таких команд, много данных в кулуарах конференций. Да и в целом кажется про успехи в greenfield не рассказывал только ленивый. 2. Внедрение в brownField проекты Это уже интереснее т.к. было много споров что вот на старых то проектах внедрить нельзя. Но пилоты многих показали что и тут можно добиваться значимых результатов. На Agentic Dev Conf и грядущем TeamLead Conf Siberia коллеги из райфа показывают такие пилоты и их успех в разных не связанных вертикалях. Есть и много других проектов, и в т.ч. мы в в Вебпрактик видим ускорение в т.ч. в brownfield проектах, если правильно работать с контекстом и правильно затачивать под это harness. Причем как про микросервисную (могу говорить про десятки/сотни) так про монолитную brownfield архитектурой. Т.е. в лагере адоптеров есть много кейсов когда они доказали эффективность бизнесу через прирост производительности разработка в конкретных метриках. И есть конечно и просто те, кто видят эффективность и не меряют, просто принимая это как новый уклад. Считая что назад дороги уже давно нет, и можно двигаться только вперед. # ФАЗА 2: ТРАССИРОВКА ЭФФЕКТОВ ОТ УСКОРЕНИЯ НА БИЗНЕС Когда обе стороны принимают факт что разработка ускорилась, или сторона сомневающихся условно принимает довод что разработка ускорилась. И один из ключевых вопросов который задают: а точно ли ускорение разработки дает эффект в бизнесе. Измеримый сквозной throuthput. В идеале в финансах. И тут ловушка в которую попадает этот вопрос: что даже в мире без ai в большинстве команд не могут однозначно сказать на сколько те или иные гипотезы беклога определенного продукта повлияли на сквозную пользу для бизнеса который выразился в финансовом результате. Могут быть какие нибудь промежуточные метрики, но на сколько они точно влияют на конечный бизнес результат сложно. Да, есть кейсы когда это можно трассировать прозрачно как ускорение переработки беклога дает прозрачный бизнес результат. Но померить влияние на финансы какой нибудь команды в микросервисной архитектуре порой весьма непростая задача) И тогда 2 сценария а) У вас есть возможность доказать бизнесу что беклог действительно конвертируется в ценность и ускорение переработки беклога = польза. б) У вас идут сценарии доказания через сохранение скорости беклога, но сокращение ресурсов. === В целом в правильном споре стоит разделять уровени, и спорить на каждой конкретно: разработчик / команда / поток доставки / бизнес Часто в спорах идет перепрыгивания с уровня на уровень, причем не осознанное. На мой взгляд эффективность разработки доказана давно. Лето 2026 славится тем что уже к этому моменту за весну многие корпорации откатали свои пилоты и пришли с публичными результатами о которых могут заявлять. Сейчас все начинают думать как масштабировать этот опыт и решать те боли с которыми столкнулись в процессе. Нельзя не уважить лагерь тех кто говорит подходить аккуратнее и утверждают что можно получить ускорение больше классическими методами поиска узких мест без AI, особенно если у вас накопился большой ворох проблем и те самые 10% написания кода происходяи в результате огромного количества блокеров. Но имхо эти процессы нужно параллелить. Чтобы к тому моменту когда вы разошьете старые проблемы, не оказалось что вы с самом начале перевода производства на новые рельсы.

TechLead Stream | Иван Поддубный
Дамп и поток мыслей Ивана Поддубного - CTO Вебпрактик - Программный комитет AgenticDevConf, AI Native, CTOconf, TechLeadConf, Podlodka, TeamLeadConf - Организатор RnD PHP - Больше года увлекается перестройкой процессов SDLC под AI. Связь: @northleshiy
-
edited -
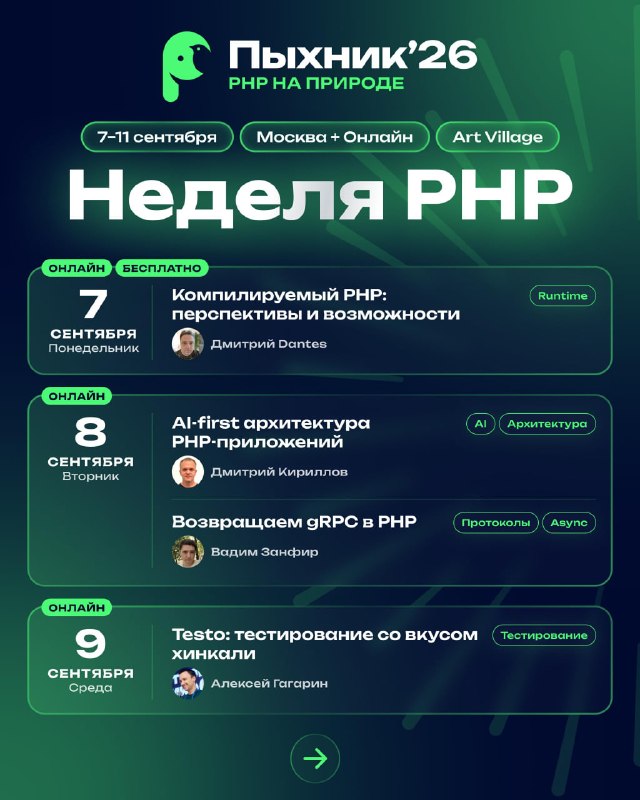
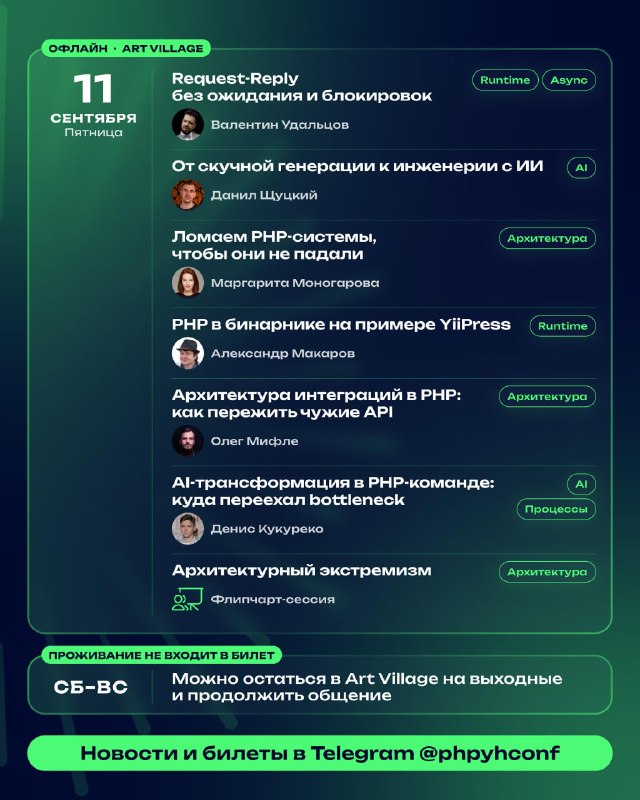
На Пыхнике будет выступать наш PHP тимлид Денис, поделится опытом ai трансформации команды и процессов, шишках с которыми столкнулись в его команде на этом пути. Сам Пыхник кстати гибридный, часть онлайн, часть оффлайн. Основная часть в оффлайне. Вообще и другие классные доклады про AI трансформации будут. Например Саша Макаров еще сделает вечером сессию обсуждения как старые классические парадигмы программирования вроде DDD или АОП по другому заиграли в ai-native разработке. Мне такое прям очень откликается. Многие архитектурные парадигмы могут быть переосмыслены в современном мире. Подробнее тут https://t.me/phpyhconf/209
-
edited 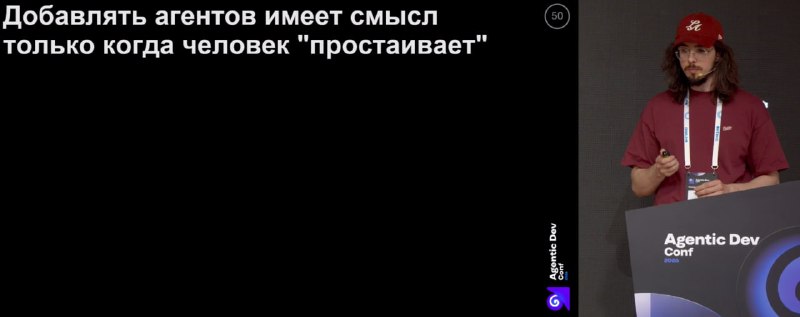
https://github.com/obra/superpowers/releases/tag/v5.0.6 Значимое событие в области харнеса отыгрывает за лагерь сокращения старых обвесов мультиагентности. Автор superpowers выпилил мультиагентное ревью, со словами что чеклист самопроверки справляет лучше и быстрее. # Масленников разобрал лагери обвесов харенса https://habr.com/ru/articles/1058676/ Причем мои наблюдения подтверждают что "минималисты" которых он выделил зачастую приверженцы SDD. Я у многих приверженцев готовых SDD фреймворков, на которых они строят слой харнеса поверх базовой шины контекста узнавал что они не упарываются в мультиагентность. # Мой взгляд на мультиагентность: 1. Многие сабагенты которые мы делали в 2025ом - стали не нужны. Часто мы их делали т.к. не влезали в контекстное окно, да и в эпоху когда скилов не было. Бездумное следование старым привычкам - зло. 2. Мои наблюдения (eval еще не выкатили чтобы сказать замеры), показывают достаточно неплохое качество замыкание на чеклисте самопроверки из SDD при работе в 1 поток. Конечно это не значит что нужно всегда и везде юзать 1 агента в монопоток. Но это призыв к тому чтобы не считать что мультиагентность - серебрянная пуля и точно является некоторой уверенной стадией зрелости харнеса. Необходимо все эвалами тестить, не устарело ли на актуальных моделях конкретные старые приемы в т.ч. конкретное использование сабагентов. Собственно есть разные поинты когда нужно идти в мультиагентов, когда нет. Например базовые правила что мелкие подзадачи с большим выводом и малым вводом можно делегировать чтобы экономить окно. И в недавних патчах агенты вроде claude code / codex даже начали САМИ это делать без ручных оптимизаций. Один из поинтов когда стоит нарезать мультиагентов вручную выразил Николай Сенин на AgenticDevConf и который я тоже нахожу весьма неплохим (скрин ниже). Еще поинт из того же доклада про то что иногда делегирование подзадач дает просто лишнюю потерю токенов т.к. нужно многим подагентам объяснять один и тот же контекст. Существует очень много разные точек роста харнеса, и мультиагентность лишь одна из многих инженерных практик для его прокачки. Возможно прокачка вашей SDD шины даст больше эффекта.
-
Глеб Михеев (кстати руководитель AI Native комитета в онтико) запустил опрос — исследование адаптации агентной разработки в компаниях. Мы всё сильнее видим расслоение в индустрии — очень хочется копнуть глубже и понять, как это выровнять. Сам опрос тут, его пустили по разным каналам в попытке больше собрать информации по состоянию в отрасли.
-
edited А нужно ли потреблять контент и сигналы с рынка с такой скоростью?) Готов поспорить что - "да" и мы вынуждены это делать чтобы не ошибаться в инженерных, архитектурных и организационных вопросах. Нет универсально правильных, выверенных годами способов решения совершенно новых для отрасли задач и вызовов в области построения ai sdlc процессов. По этому вместо своего RnD подсмотреть у соседей что уже получилось или у других что не зашло - бесценно. Вы сэкономите кучу времени на проверке неправильных гипотез. "Пойти не туда" - самое больное. И на всех уровнях - от деталей реализации харнеса, до организационных изменений - количество вариантов где можно поставить "не на ту лошадку" очень много. Большинство изменений которые мы сейчас внедряем - несут риски. Примеры из жизни ПК. Примеры чуть упрощены, но смыслы именно такие. 1. Ребята из одной компании приносят продукт для sdlc. Члены ПК экспертно заявляют что ребята потратили несколько месяцев работы зря, их решение уже устарело и его нужно было делать совсем иначе. Из-за не правильного считывания сигналов рынка - месяцы работы не по той дорожке. 2. Для другой конференции мы начали отбирать доклады за 3+ месяца. И часть докладов которые казались актуальными в марте, в июне уже сильно менее актуальны. То что казалось революцией 3 месяца назад, сейчас уже данность. > Выпасть на 1-2 месяца из этого зверского информационного потока - значит принимать неправильные решения в трансформации производства за которую ты отвечаешь. Как бы не звучало смешно - но практика которая прожила год или хотя бы 6 месяцев с результатами - это прям штука за которую стоит хвататься) Каждую практику ты еще вынашиваешь применительно к своим процессам, анализируешь относительно трендов и рынка, 10 раз взвешиваешь прежде чем кинуться ее внедрять. Тут стоит отдельно похвалить коллег из сбера которые не побоялись выпустить AI Disrupt PDLC как набор устоявшихся практик, трендов и веяний который они взяли смелость зафиксировать в документ. Коллеги утверждают что таких аналогов нет в мире, и в целом из моего наблюдения - кажется столь всеобъемлющего действительно нет. Да, может быть что какая то доля трендов отражена с ошибкой, где-то с перегибом, но с моей точки зрения они действительно выразили и консолидировали многие СТАБИЛЬНЫЕ тренды на которые сейчас все ставят. Полную версию документа в 150 страниц осилит конечно не каждый, но имхо сейчас все кто интересуются процессами обязаны познакомится хотя бы с краткой выжимкой. Это некоторый базис концепций на который можно ссылаться в разговорах. Отдельный кайф получил от встреч c-level клуба, когда технические и бизнес директора разных компаний разных уровней и совершенно разного бизнеса (от заказной до продуктового) в форматах брейншторма обсуждали свой вижен. И здесь прям супер приятно что вижен во многом матчится. Это дает больше уверенности в тех изменениях что мы опять же внедряем у себя.
-


Скорость изменений в отрасли увеличилась кратно, как и появление новых инженерных практик и укладов. И попытка успевать потреблять все сигналы рынка и даже ключевой опыт граничит с безумием) Помимо личного и опыта в компании, основные потоки считывания сигналов у меня идут отсюда: - Telegram-каналы коллег по несчастью (они тоже генерят контент ппц как быстро). Кстати у одного из коллег по ПК AgenticDevConf - неплохие сводки https://t.me/nobilix/280. Такой формат особо ценен. - Habr. Я поднял себе с нового года Karakeep, в который скидываю (вручную) и классифицирую (аишкой) все статьи. Лучше, чем скидывать в избранное, — и приложуха есть. Правда, скорость прирастания очереди быстрее, чем скорость потребления. Минус что сейчас хабр пестрит нейрослопом, и отделать реальный промышленный опыт от нейрослопа или просто мелких слабо проверенных экспериментов одиночек - сложнее. - Конференции. Онлайн (попроще) и офлайн (посложнее). От офлайновых пользы сильно больше, т.к. там больше живого общения. - ПК в пачке конференций, где курирую AI SDLC-треки. TeamLeadConf, TechLeadConf, Highload, AgenticDevConf, Podlodka Crew, ПыхКонф и пр. Последний источник для меня самый ценный. Да, это доп. нагрузка на вечера и выходные. Но возможность первым узнавать о реальном прикладном опыте, который несут компании всех уровней, про результаты успехов и неуспехов их пилотов — это в наше время самый сок. И это доклады конференций, которые вы гарантированно отсмотрите, а не положите на полку «посмотреть», до которой никогда не доберётесь. И более того — примете участие в формировании ключевых мыслей, помогая в том числе и себе их оформить и зафреймить. Иногда вы созваниваетесь вроде как прогнать доклад, но первые полчаса пересказываете, что у вас изменилось за последние пару недель в рамках конкретной инженерной практики). В общем, доп. нагрузка того стоит, а живые коммуникации с такими же практиками, как ты, — самый сок. Иногда просто созваниваюсь с такими коллегами просто для регулярной сверки часов, поделится опытом. P.S. если вы построили свои автоматизированные пайплайны потребления и обработки контента - делитесь)
-


 +4
У меня были плотные пару неделек) Неделя конференций в Питере и неделя в Мск) - Выступление на HighloadConf, TeamLeadConf на тему уровней зрелости и инженерных практик в SDLC - 2 круглых стола на темы AI и матриц компетенций - Выступление на архитектурной конференции сбера посвященной AI Disrupt PDLC - Выступление на AgenticDev Conf про SDD - Участие в двух сессия коллективного решения проблем внедрения AI в рамках C level клуба При всем этом у меня не отпуск и рабочие задачи никуда не девались, по этому 2 недели сна по ~4 часа, а потом еще неделька разгребания того что не успел. Очень много общения с коллегами. Много мыслей. Понемногу выдыхаю и буду делиться)
-
edited Vercel купил Better Auth. Авторизация/аутентификация для меня всегда была интересной темой. Которую если делать правильно и безопасно - нужно упороться. Даже имплементировать все основные подстандарты oauth/oidc и рекомендации owasp - вообще ни разу не просто. Better Auth лучшая и можно сказать единственная универсальная open source библиотека которой очень много лет не хватало для реализации многих бестпрактикс. Единственную альтернативу в виде nextauth он поглотил очень быстро. Сейчас авторизацию во многих приложениях сразу строят на нем, и покупка vercel это некоторый знак качества и уверенности в темпе развития.
-

Какой крутой мем, бьет по больному) Причем на меме про claude, а у меня про себя) Мы тратим овердофига времени чтобы понять какие тренды, подходы и инженереные практики действительно верные. И за последний год у меня несколько раз возникало ощущение что есть хорошая модель мира агентской разработки. Но она не раз становилась неточной и нуждающейся коррекции) Своей инженерной моделью мира агентской разработки в понедедьник поделился в главном зале на HighloadConf на докладе модели зрелости внедрения AI в SDLC, получив большое количество живого положительного фидбека. Мем честно стырил у коллеги тоже с доклада конференции) https://t.me/anti_notes/88 Upd: пост пересоздал т.к. случайно забыл про отложенный черновик)
-
edited 
На этой неделе выходит новый сезон конфы Podlodka AI Crew со свежими кейсами) Предыдущая была огонь, эта тоже обещает быть хорошей. Лично мне интересны и мастер классы по Pi, и управлением экономикой и практики по покрытию eval. Отдельно интересны практики дизайна с AI) С полной программой можно познакомиться тут. Ну и т.к. я член podlodka php crew, то мне и промик со скидкой дали: techlead_stream_3
-
edited Помимо активной перестройки AI в SDLC мы еще с 2025 начали заниматься внедрением AI в бизнес клиентов, автоматизируя их бизнес процессы. Строим RAG, мультиагентные системы в контуре клиентов. В основном все на open source стеке, идеологически строим без вендорлоков. Немного рассказывал о нашем опыте в прошлом году на TeamLeadConf на примере построения RAG систем. На днях запустили сайт AI направления и начали вести отдельный канал Корпоративный ИИ c новостями больше ориентированными на бизнес.
-
repost 
Открытая встреча Devhands AI Club 26-го мая 18:30 MSK! Бомбовая тема: AI SDLC (agentic/ai-native software development life-cycle). В недавнем white-paper Сбера утверждается: у всех у нас есть всего год-полтора перестроиться, и кто не перейдет на SDD (spec-driven development), будет отставать и догонять. В гости к нам придёт Иван Поддубный — CTO Вебпрактик, член ПК AgenticConf/CTO Conf, внедряет агентский SDLC и SDD в разработку. Поговорим о практике перестроения разработки на AI SDLC, SDD, про опыт перехода, внедрения новых инструментов и практик, и конечно про набитые шишки. Всё это дело обсудим вживую на встрече Devhands AI Club во вторник, 26 мая в 18:30 MSK. Ведущий - Алексей Рыбак, формат — беседа c ведущим + сессия Q&A. 🤩 Zoom: https://us06web.zoom.us/j/82785872202?pwd=4Pf7o6toQ4Bxpm0K10TEvD22hrMuny.1 🤩 Календарь: https://devhands.cloud/calendar-ai-club-26may2026.ics Приходите сами, приводите коллег и друзей. А вы что думаете про spec-driven разработку? (предвосхищаю битву реакций) 🔥 спека теперь - это новый исходник, а код - он всего лишь теперь “артефакт” 👍 всё это добром не кончится
-
edited Подарок на праздники. В т.ч. выход за рамки контейнера на хост. https://firstvds.ru/blog/uyazvimost-copy-fail-pozvolyaet-lyubomu-polzovatelyu-linux-poluchit-root-dostup
-

За неделю много очень событий и пополнение коллекции уточек. Посетил AiConf (он слеплен с golang, бейджик от голанга выдали), клуб cto от онтико, выступил на подлодке и побывал на heisenbug. Очень много общался с коллегами по рынку на тему развития ai в sdlc. Ряд важных мыслей за этот период. 1. Многие компании до сих пор на околонулевом уровне адопшена. И даже есть некоторое количество тех кто считает что это не нужно, ссылаясь на избирательные исследования годичной давности. У многих до сих пор стадия очень ограниченных пилотов. 2. Ключевые страхи многих CTO как не превратиться в машину генерации нейрослопа и не просесть трагически по качеству. Тесты, статанализ - новая критическая инфраструктура. Важность платформы - растет. 3. Многие cto смотрят в сторону и экспериментируют с SDD. Но SDD воспринимаю многими по разному, есть те кто воспринимают его чуть ли не как plan/act на уровне только разработчика, а не инструмент сквозного процесса. Порадовала коллега qa из авито, которая рассказала что SDD в каких то вертикалях внедряют уже очень широко, и делилась сложностями при написании скилов генерирующих интеграционные тесты. 4. Чуть растроил доклад Артема Ерошенко, в прошлом году он ворвался с ноги про ai, но за год возможно немного не успел за трендами, по этому доклад был больше про исторический обзор, что тоже интересно, но все таки хотелось огонька) Надеюсь догонит и на следующем HB ворвется с трендами) 5. В большом зале HB на вопрос у кого в продуктах ai видел много рук, на вскидку треть точно. От многих qa слышу не только понимание сложностей тестирования недетерминированной логики, но и осмысленные практики с evals, llm judge, ragas и прочего. Причем прям много было толковых вопросов на эту тему спикерам и хороших кулуарных обсуждений. 6. Яндекс делился практикой адопшена через тренеров которые ходят в команды и помогают настраивать AI процессы. Демократичный достаточно подход который со слов коллег очень помог в разработке, а теперь помогает в процессах тестирования. 7. Важные мысли что путь в 4ый уровень может лежать через автоматизацию узких процессов. Например агентом решать задачки из Sentry, который часто у многих засран и руки не доходят. Присылая MR с решением багов. Коллеги поделились что так разобрали достаточно большой беклог. На них обкатывать решая конкретные узкие задачи, это сильно проще, и потом расширять на продуктовый беклог. 8. Один из руководителей внедрения AI в компании ответил что возможность схлопывания ролей в старых командах появится лишь когда будет автоматизированно агентами достаточное количество подпроцессов. Причем уровень автоматизации будет хорошо покрыт evals прежде чем действительно в существующих командах возможны изменения. Но новые команды нужно стараться запускать уже в ai first подходе. 9. Новые узкие горлышки, чаще всего слышу что это: бизнес, тестирование (если плохие процессы) и дизайн (что скорее временно, в момент времени или инструмента дизайна не поспевают или дизайнеры не успевают за инструментами).
-
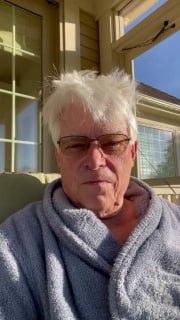
repost Нет, вы посмотрите на этого еретика, о чём он вообще? Признайте: ИИ с лёгкостью уделает вас в кодинге. Нет такой задачи, на которую у вас ушёл бы день, а ИИ не сделал бы её за пять минут. Всё кончено. Код будете писать не вы. Да-да, я знаю. Смиритесь. Но вот в чём штука - это даёт вам огромную силу, потому что теперь можно делать то, о чём раньше и мечтать не приходилось. Например, подумайте о покрытии тестами: вы же помните, какая это была морока. Надо писать все эти чёртовы тесты, и вы знаете, что тесты на самом деле не доказывают, что код работает. Запускаешь code coverage, ухмыляешься и говоришь: ну да, ладно, но это же не значит, что код работает. Это значит только, что он исполняется. Так вот, теперь это можно исправить, у вас появились ресурсы, чтобы это сделать. Говорите ИИ: покрой этот чёртов код тестами. А потом берёте mutation tester (да, это такой инструмент - и пусть ИИ его вам и напишет, уйдёт минут пять), дальше ИИ запускает этот инструмент, тот вносит изменения в исходный код и прогоняет все тесты. И если тесты не падают - он допишет тест, который поймает эту мутацию, и это значит, что у вас будет покрытие тестами. Ей-богу, у вас будет покрытие тестами. И знаете, что ещё можно? Можно анализировать качество кода. Можно написать инструмент, который смотрит на цикломатическую сложность. Кстати, есть отличный инструмент для этого. Ему лет двадцать. Называется CRAP - хорошее название, как расшифровывается - не знаю и знать не хочу. Это комбинация покрытия тестами и цикломатической сложности. И вы можете сказать ИИ: понизь метрику CRAP - ниже пяти, ниже четырёх, как хочешь. И это заставит его порезать все жирные функции на маленькие и покрыть их все тестами. Ей-богу - подумайте, какие у вас теперь рычаги, чтобы довести код до качества, какого вы никогда не видели. Знаю-знаю, я тот самый старый дед с Clean Code, но вот что я вам скажу: теперь вы можете сделать код чертовски чище, если заставите ИИ сделать это за вас. Да что этот дед может знать про разработку? Хотя погодите... Да это же Роберт Мартин - "Чистый код", "Чистая архитектура", "Идеальный программист", "Быстрая разработка программ"! За последний год от умеренного скептика он окончательно перешёл в стан апологетов использования ИИ в разработке, а теперь вот сидит у себя на веранде в халате по утрам и жжот глаголом :) Да что с него взять - дед наверное просто на старости лет выжил из ума, раз такое предлагает! Нуу, а что насчёт всех вот этих людей? За 52 года программирования оно никогда не приносило столько удовольствия ⬈ 90% моих навыков теперь стоят $0 …но остальные 10% стоят в 1000 раз больше Kent Beck (XP, TDD) Появление LLM меняет разработку настолько же радикально, как переход от ассемблера к языкам высокого уровня ⬈ Меняется само понятие того, что значит "программировать" ⬈ Martin Fowler (Refactoring, PoEAA) ИИ выведет на чистую воду тех, кто никогда не умел думать как инженер ⬈ Верификация становится узким местом. Кодогенерация сама по себе дешевая ⬈ Dave Farley (Continuous Delivery) Это третий золотой век разработки софта - благодаря ИИ ⬈ Меня это не пугает. Меня это радует. Меня это освобождает ⬈ Grady Booch (UML, OOAD) Писать код руками - это как проявлять фотоплёнку в тёмной комнате. Никто так больше не делает ⬈ Тебе больше не нужны шесть разработчиков плюс UX плюс продукт. Тебе нужен человек с проблемой и разработчик, который её решит ⬈ Gene Kim (Phoenix Project, DevOps Handbook) — Это ж всё сплошь архитектурные астронавты - что они могут знать про реальную разработку: как мы перекладываем JSON'ы, про наши CRUDогенераторы, и про то, насколько важно использовать табы вместо пробелов? Ну да, ну да :) А получается у них с ИИ именно потому, что для них разработка всегда была не про написание кода. Идеи этих дедов стали актуальны как никогда. Кстати, довольно интересно отслеживать эволюцию их взглядов, а с дядей Бобом ещё и спорить иногда случается :) #rant #дедпримитаблетки
-
edited Если кому то казалось что виден край дефицитам мощностей для вычислений, или хотя бы плато - то нет, все только начинается. Сейчас начинается переход от модели чатов к агентным нагрузкам, а это кратно возрастающая нагрузка https://t.me/book_cube/4517. Кстати, кто не знал, даже функции в ide автокомплита и контекстного изменения потребляют кратно меньше токенов т.к. работают по другому, и часто вызываются на других моделях. И все больше разработчиков переходя на следующий уровень к агентной нагрузке давят на мощности. В связи с этим мы начинаем видеть как основные поставщики дотационных подписок начинают закручивать гайки. Последние дни мы видим кучу сигналов: 1. Деградация opus 4.7, быстрее иссякающие лимиты. 2. Обсуждения и ab test что Pro подписка теперь без claude code возможностей. 3. Отмена github новых халявных pro подписок (которые многие абъюзили по черному) 4. В целом все большая "лень" openai моделей которые нужно постоянно уговаривать сделать всю работу, а не только ее часть. 5. Проверка антропиками подписчиков через верификацию по паспортам. Халява должна была рано или поздно заканчиваться, но у меня были ожидания что это начнется позже. И были надежды что графики стоимости инференса (стоимость падает с годами) и себестоимости подписок пересекутся в какой-то относительно комфортной точке. Некоторый бизнес в европе работающий на enterprise подписках с расходом по токенам выделяет по 2.5-3k евро на разработчика. Эффективность потребления большинства людей подписок за 20/100/200 долларов далека от того чтобы при росте до 2-3k (в токенах это реальная себестоимость) давать окупаемость. Что делать: 1. Начинать думать об эффективности потребления токенов в командах. 2. Смиряться с мыслью что нужно будет всем разрабам со временем сидеть на 100-200$ подписках, и даже их будет нехватать. Риск что антропики задушат Pro подписки не мал, и за ними последуют остальные. 3. Лучше изучать возможности локального инференса, держать руку на пульсе когда их уровень будет достаточным. Пока что откровенго демпингованные подписки конечно кратно выгоднее и быстрее любого локального инференса.
-
Как с AI решают одну из классических проблем поддержки одного продукта с несколькими паралельно живущими версиями https://t.me/elkornacio/546 https://t.me/elkornacio/547
-
edited Забавные мысли о том что мы отвыкаем кодить руками: 1. Сделать через годик хакатон. Для лампового кодинга без ИИ ) Уже можно будет говорить "для настоящих хардкорщиков". 2. Делать одну неделю в квартал неделей кодинга без ai, чтобы порох не промокал)
-
edited 
Новый сезон Podlodka PHP Crew с темой про современный PHP Что планируем в сезоне С 20 по 24 апреля: - Тема про NATS + асинхронный PHP от Валентина Удальцова. - Практика на RoadRunner + Temporal - Воркшоп по FrankenPHP от Саши Макарова - Саша Новиков расскажет про развитие docker окружений за последние годы. Обещает раскрыть много полезных фишек как можно улучшить деплой. - Ну и конечно не забыли про AI, который все больше пронизывает все процессы разработки! Будут доклады про практику AI кодинга, про лучшие практики в виде использования SDD фреймворков, архитектуру построения RAG и векторного поиска и как писать автотесты на современном PHP фреймворке защищаясь от AI слопа. И да, я как член ПК готовил почти все AI доклады, а про архитектуру RAG расскажу сам) Напомню как проходит сессии Podlodka: Формат — пять дней живых Zoom-сессий по утрам и вечерам, закрытое комьюнити в Telegram и общение со спикерами. Если хотите лучше понимать, куда движется современная разработка на PHP — залетайте) https://podlodka.io/phpcrew Скидка по промокоду techlead_stream_8
-
edited Software Engeneering 2.0 в терминологии Тбанк (этот термин пытались использовать еще до AI с другими посылами), открывает вопросы про кадры. Кто должны быть этими универсальными инженерами и как их растить? Понятно что сеньеры с 10-15+ летним опытом которые в т.ч. могли поработать в компаниях где аналитиков и QA еще/уже не было - справятся, это ок. В этом плане хочется считать что я как раз в этой парадигме хорошо захожу т.к. всегда качал ширину: - Поработал и на фронте и на беке (в т.ч. без аналитиков и QA) - Строил с нуля отделы QA, Аналитики, Devops - Нанимал и управлял специалистами этого профиля, погружался в специфику их работы при развитии отделов - Регулярно посещаю и выступаю на конференциях вроде Heisenbug, AnalystDays, Devopsconf и пр. в т.ч. чтобы быть в тренде их развития. Думаю в целом сеньер-помидор с аналогичным более узким опытом, но системно уделяющего 15 лет своему развитию, тоже достаточно быстро подхватит базу кругозора соседних ролей. Плюсом, Александр в своем докладе еще подчеркивает что часть сложности в т.ч. должна снимать развитая платформа. Это к слову что инвестировать в платформенную инженерию нужно продолжать, AI ее не замещает. Но блин, как вырастить широких инженеров С НУЛЯ? Если пофантазировать, то в целом если бы ВУЗ учил условно год фронту, год беку, и год на QA/Аналитику. Причем все на реальных рыночных задачах... то можно было бы получить такого широкого инженера мидл уровня. Но звучит не очень реально.
- Older posts