
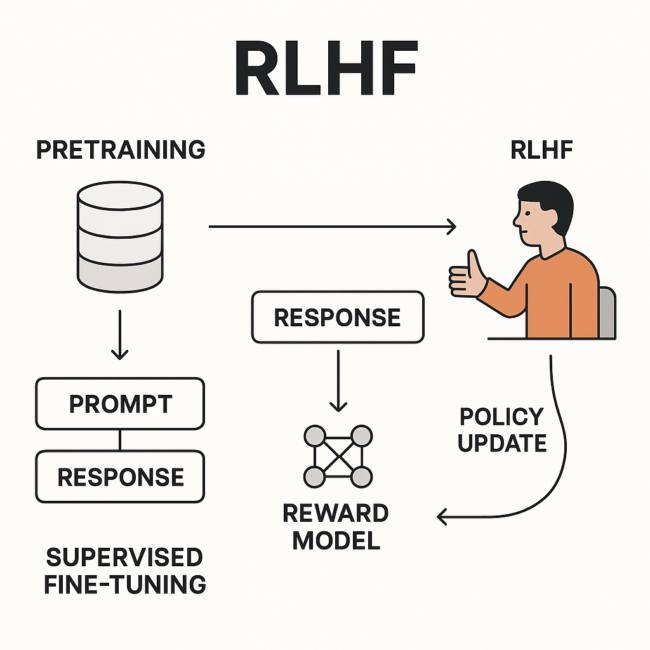
🤖 Не просто алгоритм: RLHF — метод, который делает ИИ человечнее! RLHF – это уникальный метод обучения, благодаря которому нейросети учатся не только на данных, но и получают оценки от людей. Им говорят, что понравилось, а какой ответ лучше. Процесс состоит из нескольких этапов: 1️⃣ Сначала модель проходит этап предобучения на огромном количестве текстов (pre-training). 2️⃣ Затем собирается обратная связь: люди сравнивают разные варианты ответов модели и выбирают наиболее подходящий. 3️⃣ После этого модель политики (Policy Model) дообучается с использованием алгоритма PPO, чтобы чаще выдавать ответы, которые Reward Model оценивает как лучшие. Благодаря RLHF ИИ становится социально адекватнее! Он стремится генерировать ответы, которые люди считают полезными, вежливыми и правильными. 🤩 RLHF помогает ИИ лучше понимать человеческие ценности и предпочтения. Но защищены ли пользователи от предвзятости? Этот вопрос пока остается открытым 🤔