
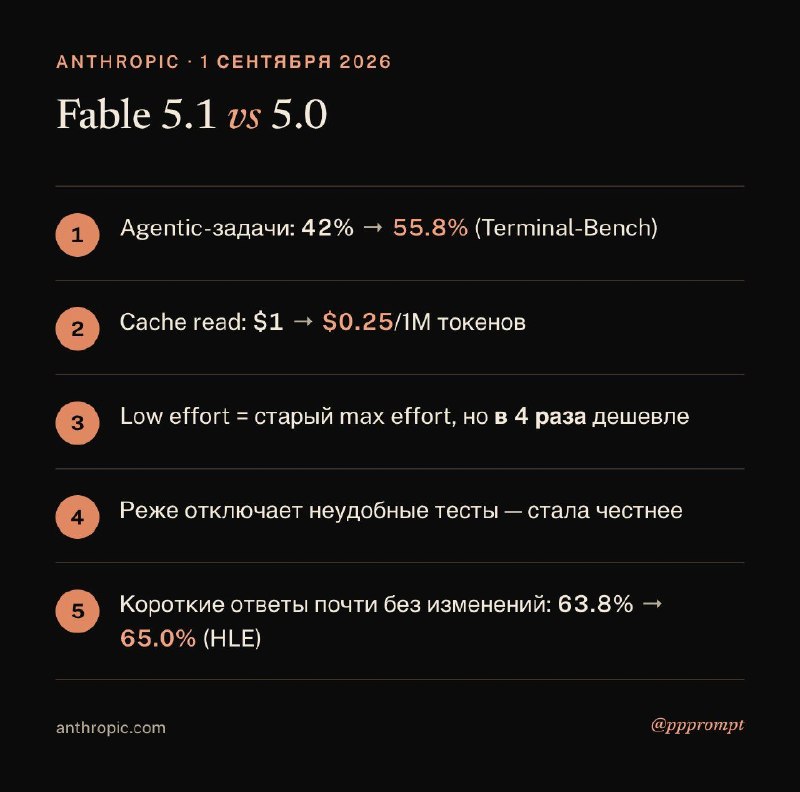
Только что вышедший Claude Fable 5.1 - в сравнении с 5.0: • Долгие многошаговые задачи (agentic tasks) стали получаться лучше: 42% → 55.8% (Terminal-Bench). Рисеч-задачи с проверкой научных гипотез и написанием кода для экспериментов: 24.7% → 52.6% (Terminal-Bench-Science) - тут вообще рост 2x. • Чтение уже обработанного текста диалога (cache reading) подешевело в 4 раза: $1 → $0.25/1M токенов. На агентных задачах, где модель постоянно перечитывает контекст, это существенно влияет на чек / лимиты. • Результаты на /effort low сравнялся с результатом на /effort max в Fable 5.0. • Модель стала честнее. Реже по-тихому отключает неудобные тесты ради красивого отчета. А еще чаще прямо говорит, что застряла. • Едва-едва стали лучше one-shot ответы 63.8% → 65.0% (Humanity's Last Exam). Короче, дешевле, дольше работает и чаще дает хороший результат в многоходовых задачах. @ppprompt