Стандарты в промптинге: как экономить токены и получать предсказуемый output Я уже писал про то, как люблю стандарты - они спасают сотни часов разработки, а иногда и жизни. Сейчас хочу поделиться простой техникой, которая сильно упрощает работу со structured output. Суть в том, что LLM отлично понимают широко-используемые стандарты (ISO и не только) и им не нужно объяснять что это такое - достаточно просто назвать. Вместо "в этом поле укажи язык" (и потом парсить "English", "english", "eng", "английский") - просто говоришь "ISO 639-1" и получаешь чёткий "en". Что это дает: - Меньше токенов на выходе - "US" вместо "United States of America" - Детерминированность - никаких вариаций и неточностей - Проще парсить - не надо городить регулярки на все случаи жизни - Совместимость - стандарты работают со всеми библиотеками и API, а еще легко найти готовые маппинги/справочники типа такого Все стандарты запомнить невозможно, поэтому у меня такой подход: перед тем как составить схему/промпт, спрашиваю себя (и AI) - а есть ли тут стандарт? Дальше разбираюсь какие есть варианты, насколько они общеприняты, и просто ссылаюсь в промпте. Собрал для вас список наиболее полезных стандартов (список раскрывается) Языки и локализация - ISO 639-1 для языков: "en", "ru", "zh" - ISO 639-2/T (Alpha-3): "eng", "rus", "chi" - BCP 47 для локалей: "en-US", "zh-Hans", "pt-BR" - Unicode (UTF-8) для кодировки символов География - ISO 3166-1 alpha-2 для стран: "US", "DE", "JP" - ISO 3166-1 alpha-3 для стран: "USA", "DEU", "JPN" - ISO 3166-2 для регионов: "US-CA", "DE-BY" - IANA/Olson для таймзон: "America/New_York", "Europe/Moscow" - WGS 84 (EPSG:4326) для координат GPS: "55.7558, 37.6173" Даты и время - ISO 8601 для дат: "2024-03-15", "2024-03-15T14:30:00Z" - ISO 8601 duration для периодов: "P3Y6M", "PT2H30M" - Cron expression для расписаний: "0 9 * * 1-5" - RRULE (RFC 5545) для повторений: "FREQ=WEEKLY;BYDAY=MO,WE,FR" Финансы - ISO 4217 для валют: "USD", "EUR", "BTC" - IBAN / BIC / SWIFT (ISO 9362) - для счетов и банков Контакты - E.164 для телефонов: "+14155551234" - vCard (RFC 6350) для обмена контактами Прочие - MIME types для файлов: "application/pdf", "image/png" - Hex RGB для цветов: "#FF5733" (а также HSL / HSLA) - Транслитерация BGN/PCGN - конечно же база: помните про СИ из школьной физики? Паттерн в промпте простой: "Extract X from this text. Return ONLY in [STANDARD NAME] format (e.g., "example1", "example2"). If uncertain, return null." 💡 Pro-tip: Когда стандарт найден - идете на github и ищите его название - скорее всего выйдете много полезного: справочники, библиотеки и тд. Справочники можно искать прямо в gist по фильтру JSON: пример. Попробуйте на своих задачах. Скорее всего для вашего кейса уже есть стандарт, который LLM знает лучше вас и вам же будет проще это использовать в остальном коде. 🔥➕🔁 P.S. в тг все еще нет органики, поэтому делитесь если понравилось

Refat Talks: Tech & AI
Заметки про технологии, GenAI и глобал стартапы, прагматично и без лишнего хайпа. Tech founder, эксперт по разработке и внедрению enterprise-grade AI автоматизаций, строю AI-first компании. Консультации и сотрудничество: @refatametov
-
-
edited #ReDigest Продолжаем субботнюю рубрику, тут я кратко рассказываю про новости из мира технологий и AI, которые привлекли мое внимание. Дайджест недели: - Anthropic выкатили Claude Opus 4.5 - бьет рекорды в программировании и агентных задачах. Цену снизили в 3 раза относительно предыдущего Opus, плюс модель стала экономичнее по токенам. - США запускает Genesis Mission - госпроект масштаба Манхэттенского или Apollo. Цель: научные агенты с доступом к роботизированным лабораториям для валидации гипотез. В проекте участвуют OpenAI и Anthropic, первые результаты обещают к 2027. - Black Forest Labs выпустили FLUX.2 - новую опенсорсную SOTA в генерации изображений. Три версии (Pro, Flex, Dev), разрешение до 4MP, качество на уровне Nana Banana Pro, но дешевле. Dev-версия на 32B крутится на одной RTX 4090. - Ведомство по патентам США признало AI инструментом - как лабораторное оборудование или базы данных. Изобретателем остается человек. Это закрывает серую зону: неважно, на чем обучалась модель, претензии третьих лиц не рассматриваются. - ChatGPT запустили Shopping Research - как Deep Research, но для покупок. Задаёт уточняющие вопросы, анализирует источники, использует память для персонализированных рекомендаций. Также свой Shopping ассистент запустили Perplexity. - Anthropic раскатили Claude for Chrome для всех Max юзеров - расширение позволяет Claude работать в интернете, видеть страницы, нажимать кнопки и заполнять формы. А еще запустили бета Claude for Excel - OpenAI обновили UX голосового режима - теперь работает прямо в чате, а не в отдельном окне. Говорите и тут же видите историю, материалы и ответы. - Китайские регуляторы фактически запретили использовать американские чипы в новых дата-центрах для инференса, принудительно пересаживая на Huawei и Cambricon. - Tencent раскатили Hunyuan 3D Engine. Text-to-3D, Image-to-3D с multi-view, Sketch-to-3D - результат можно юзать в Blender и Unity. - Amazon начала продажи спутникового интернета Amazon Leo (экс-Project Kuiper) коммерческим компаниям. На орбите 150 спутников из 3236, новая антенна Leo Ultra обещает 1 Гбит/с на скачивание и 400 Мбит/с на отдачу. - Nari Labs выпустили Dia2 - первую open-source TTS-модель со стриминговой генерацией в реальном времени. Не нужен полный текст, начинает синтезировать с первых слов. Две версии: 1B и 2B параметров, полностью открыты для коммерческого использования. - OpenAI тихо отчитались о возможной утечке приватных данных через Mixpanel в 10 вечера накануне Дня благодарения. Вероятно утекли имена, email, user ID и геолокация API-юзеров. ChatGPT данные и API-ключи не скомпрометированы. - Anthropic посчитали реальный экономический эффект Claude на 100К диалогов. Результат: Claude экономит 80% времени на задачах. При повсеместном применении это +1.8% роста производительности труда в год. Для контекста: исторический рост ≈ 0.5–1%. - Илья Суцкевер в интервью (дает он их редко) заявил, что эра масштабирования (2020–2025) заканчивается. Проблема моделей - они генерализуют хуже людей, отсюда разрыв между бенчмарками и реальной экономикой. Ожидает сверхинтеллект через 5–20 лет, скорее всего в виде системы с человекоподобной способностью к обучению.
-
Claude Chrome Extension и use-кейсы для AI-браузеров Некоторые из вас перешли на AI-браузер, некоторые не могут найти им применение - для себя пока не нашел причины полностью мигрировать на Comet, Atlas и подобные. Когда они только появились, я сделал ставку на то, что скорее будет мощное развитие расширений для существующих браузеров - слишком большая аудитория у того же Chrome. Недавно Anthropic выкатили свой Chrome Extension и он попался мне под руку для одной задачи. Одно из самых полезных применений AI-браузеров и расширений типа этого - работа с сервисами, которые доступны только в браузере, ну или настраивать API/MCP уж очень замороченно. Вчера был ровно такой кейс: сделать SEO анализ ключевых слов для продуктового блога - данные в Ahrefs, Google Analytics и Search Console. У Ahrefs API стоит на порядок дороже самого инструмента. У гугловых сервисов API есть, но настраивать долго. А в браузере это уже есть. Что я сделал. По-открывал нужные сайты в группе вкладок chrome, открыл эстеншн и дал агенту задачу: проанализировать статистику, найти "низко висящие фрукты" (ключевики на второй странице, которые легко дожать), сделать отчет по ключевикам и идеям контента. Opus реально хорошо понимает UI - не спотыкается на кнопках и формах, в отличие от того же Comet. Работает медленно, как и все подобные системы, обычно ставлю задачу и ухожу пить кофе, наблюдать за этими медленными кликами тяжко (даже это видео я в основном записывал в фоне, а потом подрезал и ускорил). Еще из минусов: пока слабая интеграция в экосистему Claude - нельзя продолжить диалог в основном приложении, нет доступа к skills и code interpreter. Чувствуется как отдельная штука. Но слушайте, это работает - я не спец в ahrefs, а Opus сходу разобрался что делать, я его только направлял по тому что нужно мне. И далее когда я задавал уточняющие вопросы у него был весь контекст увиденного. В общем, я вижу пользу в подобных расширениях (и AI-браузерах) как такой контекстный помощник, когда агенту доступен только UI, и нет прямого доступа по API/MCP. А какие у вас кейсы для AI-браузеров? 🔥➕🔁
-
Куда на самом деле движется индустрия LLM (спойлер: вы выбираете не модель - вы выбираете стек). Пост навеян свежим релизом Opus 4.5, а именно ее доп фичами как Context Editing - нам показывают действительно впечатляющие демки… Но постойте - это же (очередная) не-фича foundation модели. Это не что-то в весах. Это инфраструктурный middleware, который живет между вами и моделью. И если вы проанализируете (особенно глазами разработчика) релизы последнего года, то вы увидите что мы все дальше от бога от LLM как модели, и тем ближе к LLM как infrastructure-as-a-service. Давайте поговорим, куда нас ведет индустрия и что из этого следует, но начнем с начала. Большинство людей (в том числе многие разработчики) когда говорят про условный ChatGPT не видят весь спектр между "моделью" и "продуктом" - ведь это одновременно и foundation model, и старый добрый completions API, и вполне себе агентный Responses API c Code Interpreter, File Search (RAG прямо в "модельке", ага) и т.д. Что на самом деле продают вендоры OpenAI Responses API - это целая инфра, включая NoSQL БД для истории, хранилище файлов и тд. Вы отдали им state management. Code Interpreter и Code Execution - это PaaS: managed sandbox - $0.03 за сессию платите за инфру, не за "умную модель". Claude Context Editing - middleware с настраиваемой стратегией pruning (keep last 3 tool uses, clear 5000+ tokens). Оркестрация, а не интеллект. Google Grounding и Maps tool - dynamic retrieval: модель решает нужен ли поиск, генерит queries, получает доступ к индексу (глубже публичного API), делает reranking, отдает с citations. Вы покупаете gateway к индексу, не модель. Даже Structured Outputs - это частично заслуга инфры, а не весов - constrained decoding через CFG (конвертит JSON Schema в грамматику, маскирует невалидные токены). Компилятор поверх модели. Большинство не осознают, как растет пропасть между проприетарными infrastructure-as-a-service от OpenAI/Google/Anthropic и голыми весами open-source моделей. Проприетарные LLM превращаются из inference провайдеров в операционки для intelligence. Что из этого следует и что следует иметь в виду 1. Понимать уровни зависимости, я выделяю три: - State (Threads, File API, memory) - критический lock-in, вы не владеете памятью системы - Execution (Code Interpreter, sandboxes) - средний lock-in, нужна своя инфра для рантайма - Behavior (Grounding, Computer Use) - средне-высокий, модель часто обучена под "свои" инструменты Перед использованием любой фичи спрашивайте: "Где живут данные? Кто контролирует логику? Смогу ли я воспроизвести это сам?" 2. Integration Tax vs Migration Tax - ключевая асимметрия. Проприетарные фичи дают быстрый старт, но стоимость выхода растет экспоненциально. Это не обязательно плохо - это trade-off, который нужно делать осознанно. 3. Разделять Core и периферию Core (ваша уникальная ценность, основа продукта) - инвестируйте в независимость: свой state management, своя оркестрация и тд. Пример: AI-агент для support как продукт - владение историей диалогов критично, а вот Code Interpreter для внутренней аналитики - это ок. 4. Есть обратная сторона. Чем глубже расходятся продуктовые слои провайдеров, тем сложнее делать model-agnostic продукты, которые работают так же хорошо. Manus поняли это рано - выжали максимум из Anthropic, не пытаясь быть совместимыми со всеми, и сделали продукт-звезду. Возможно, по той же причине Claude Code так хорош? 5. Учитывайте свою стадию. 0→1 (поиск PMF) - максимально используйте проприетарные фичи, скорость важнее. Когда растете - можно строить абстракции: gateway, свой state для core функций. На стадии масштабирования - еще больше контроля и взаимозаменяемости компонентов (interoperability это дорого). Главное Проприетарные AI-платформы - это managed infrastructure, как AWS. Вы платите не только деньгами, но и зависимостью. И этот тренд будет расти. Часто это правильный trade-off, особенно на старте. Но это решение нужно принимать с открытыми глазами - понимать, какую часть системы отдаете "в управление", и делать это осознанно для каждого компонента продукта.
-
edited #ReDigest Продолжаем субботнюю рубрику, тут я кратко рассказываю про новости из мира технологий и AI, которые привлекли мое внимание. Дайджест недели: - Google выкатили Gemini 3 Pro - SOTA почти по всем бенчам, первая модель за 1500 Elo на LMArena. 1М токенов контекст, 64K на выход. Цена: $2-4/млн на вход, $12-18/млн на выход. Flash-версии пока нет. Очень мощный релиз. - OpenAI представили GPT-5.1-Codex-Max для кодинга с динамическим архивированием истории - агент может работать над одной задачей 24+ часа. - Google запустили Antigravity - конкурента Cursor на своих топовых моделях. Из фишек планирование через артифакты и быстрый браузер-тул через хром расширение. Пока бесплатно. - Cursor 2.1 добавил интерактивные планы с возможностью отвечать на вопросы ИИ, плюс AI Code Reviews и Find Issues -поиск и фикс багов и кодревью по одной кнопке. - Warp выкатили апдейт, стали первыми в Terminal-Bench 2.0 с Full Terminal Use - агент теперь работает с интерактивными CLI-приложениями (дебаггеры, REPL), плюс функция /plan для согласования подхода и интеграции со Slack, Linear, GitHub Actions. - Сэм Альтман с Льюисом Андре основали Episteme - R&D-организацию для долгосрочных исследований на стыке физики, биологии, вычислений и энергии. - ElevenLabs выпустили платформу Image & Video (Beta) - агрегатор моделей генераций медиа с озвучкой и липсинком в одном месте. - OpenAI раскатили групповые чаты в ChatGPT - приглашаете людей, общаетесь, по мере надобности вызываете модель в диалог. Удобно для проектных обсуждений. - Alibaba делает ИИ-суперапп на Qwen 3 - Deep Research, кодинг, компвижн, голосовые вызовы, генерация отчетов с автоматическими презентациями за секунды. Интеграция со всей экосистемой: карты, доставка, коммерция. Пока только Китай. - Google обновили Nano Banana - теперь с Gemini 3 Pro под капотом, веб-поиском и 4K. Завезли в NotebookLM - он теперь генерит наборы слайдов, графики, диаграммы и видео-презентации из документов. - Meta выпустила новый SAM3 и SAM 3D - создание 3D-моделей объектов и людей из обычных фото. SAM 3D Objects восстанавливает форму и текстуру, SAM 3D Body реконструирует тело с позой и конечностями. Код открыт. - xAI выпустили Grok 4.1 - лучше понимает эмоции и выдает меньше неточностей. Но лидером LMArena не продержался и дня — его сразу сместил Gemini 3. - Perplexity добавили возможность создавать и редактировать слайды, таблицы и документы во всех режимах поиска. Доступно на веб-версии для Pro и Max подписчиков. - Еврокомиссия анонсировала масштабный пересмотр GDPR и AI Act - упрощение cookie-баннеров, разрешение использовать персональные данные для обучения моделей, отложенное введение правил для высокорисковых AI-систем. - Исследователи выпустили Heretic - софт для автоматического снятия цензуры с LLM. Вычисляет "направления отказа" и удаляет их из весов. Работает автоматически на большинстве архитектур, включая Llama, Qwen, Gemma. - Cloudflare пережили крупнейший сбой с 2019 года - изменение прав в ClickHouse удвоило размер конфига Bot Management, что положило X, ChatGPT, Discord, криптобиржи на несколько часов. Полное восстановление заняло почти 6 часов. - Manus AI выпустили агента для браузера в виде расширения - активируете, и ИИ берет окно под контроль и выполняет задачу. Работает в любом браузере. - OpenAI опубликовали большую статью с научными кейсами, где GPT-5 помог сделать открытия. - Gamma сделали гайд промптов для создания презентаций по отраслям - маркетинг, сейлз, консалтинг. Плюс примеры API-интеграций c n8n, notion и т.д.
-
Продолжаю про file-first подход к агентам для работы с базами знаний. В прошлом посте рассказал про общий концепт и rclone. В этом посте как и обещал расскажу про поиск по бинарным (не-текстовым) файлам. Напомню что общая идея - использовать всю мощь передовых кодинг-агентов (в данном случае Claude Code) для задачи работы с базами знаний. Итак, синхронизация настроена, имеем на быстром диске файлы, но большинство из них в формате Word, PDF, Excel, PowerPoint. По дефолту Claude Code (а точнее в его обертке под названием Agent SDK) доступны все инструменты для поиска по текстовым файлам (grep, ripgrep и тд), но эти файлы не текстовые. Первая мысль была: ок, давай конвертнем все в plain text (есть же docling, markitdown и тд). Но хотелось чего-то проще, не хотелось строить пайплайн индексации: это и время, и дублирование источника истины, и проблема инвалидации - файлы-то постоянно обновляются. Хотелось найти решение которое работает напрямую с Office файлами. Эксперименты Создал тестовое окружение: 150 документов в разных форматах и сравнивал такой шортлист, который мне подкинул deep research: - ripgrep c расширенными настройками (на самом деле их было больше) - почти сразу отпал - pdfgrep - прекрасно ищет по PDF файлам - ugrep - хоть и ищет по всем файлам, но по-началу давал средние результаты, например был хуже pdfgrep для pdf и плохо искал по презентациям, но потом я открыл его суперсилу - фильтры! Фильтры ugrep - вот где магия ugrep умеет на лету конвертить файлы через внешние тулы перед поиском. Для этого используется флаг --filter или его алиас `ug+`. Работает просто: ты говоришь "для файлов .docx юзай pandoc, для .pdf юзай pdftotext" и все. Пример: ugrep --filter="docx:pandoc %f -t plain" --filter="pdf:pdftotext % -" "искомая фраза" Или еще проще: ug+ "искомая фраза" Самое крутое - ugrep уже идет с набором преднастроенных фильтров для популярных форматов. В итоге pdfgrep и другие специализированные тулы оказались не нужны - ugrep is all you need. ugrep еще умеет искать в архивах (zip, tar, gz) без распаковки, поддерживает fuzzy-поиск и regex с Unicode, может выдавать контекст вокруг найденного текста с подсветкой и все это можно конфигурировать через .ugrep конфиг-файл. Короче, швейцарский нож для поиска. По скорости. На деле с быстрым диском поиск по тысячам документам занимает доли секунды и не является узким местом в агентных сценариях. Но если база огромная и нужна реальная скорость - у ugrep есть встроенная система индексирования через ugrep-indexer, которая может дать ускорение в разы. Далее, чтобы это эффективно работало было несколько раундов работы с промптом агента. Одна из лучших идей оказалась - инструктировать агента сначала запускать команду tree чтобы понять структуру директорий, а потом уже делать таргетированные запросы. Это хорошо фокусирует поиск и помогает агенту лучше ориентироваться в контексте. Почему file-first - это кайф Мне нравится работать в file-first экосистеме. Linux - это filesystem-first операционка и в этом мире много сильных инженеров и очень развитый опенсорс. Поражаешься как много эффективных и производительных тулов доступны, они просто работают. Плюс это же все текстовые интерфейсы - CLI + stdin/stdout - кодинговые агенты (считай LLM) с ними на ты. Никаких API оберток, никаких дополнительных слоев абстракции. Просто композиция мощных Unix-тулов. В будущих постах по этой теме планирую покрыть: - Другие челленджи: чтение и понимание содержимого нетекстовых файлов - Когда все-таки нужны индексы или "шпаргалки" (или навигаторы) для таких агентов - Опыт с Remote MCP и вопросы авторизации - Подходы к разграничению прав доступа - Вопросы изоляции (безопасность) 🔥 ➕ 🔁 поддержите если хотите больше на эту тему
-
#ReDigest Продолжаем субботнюю рубрику, тут я кратко рассказываю про новости из мира технологий и AI, которые привлекли мое внимание. Дайджест недели: - OpenAI выпустила GPT-5.1 в вариантах Instant и Thinking: акцент на более теплом тоне общения и добавили пресеты тона. - Ян Лекун планирует покинуть Meta для создания стартапа по world models. Уже ведет переговоры с инвесторами. - Cursor привлек раунд в $2,3 млрд при оценке $29,3 млрд - в 12 раз больше январской оценки. Годовая выручка превысила $1 млрд. - World Labs запустила Marble - первую коммерческую модель для генерации 3D-окружений из текста, фото или видео. - Фей-Фей Ли опубликовала манифест о пространственном интеллекте как следующем рубеже AI. - Google выкатил Code Wiki - агент, который генерирует документацию по любому репозиторию с интерактивным чатом и автообновлением при изменениях в коде. - Microsoft и Google объявили об инвестициях $16+ млрд в AI-инфраструктуру в Европе. - Google запускает Private AI Compute - облачную платформу для AI-функций с обещанием полной приватности, практически идентичную Apple Private Cloud Compute. - Meta выпустила Omnilingual ASR - систему распознавания речи для 1600+ языков, включая 500 низкоресурсных. Модель до 7B параметров с in-context learning — достаточно нескольких примеров для транскрипции нового языка. - Anthropic показали как решить проблему дефолтного вида AI интерфейсов через Skills. - Baidu выпустила ERNIE-4.5-VL - мультимодальную размышляющую модель с 28 млрд параметров (3 млрд активных), которая, по заявлениям, обходит Gemini 2.5 Pro и GPT-5 High в работе с документами. - ElevenLabs выпустили Scribe v2 Realtime - модель для расшифровки текста в реальном времени, обходит конкурентов по точности и скорости, поддержка 90+ языков. - Apple запускает Digital ID - владельцы iPhone могут добавить паспорт в Wallet для использования в 250+ аэропортах США. - OpenAI добавили в ChatGPT групповые чаты - бот понимает, когда нужно отвечать, а когда молчать. Пока только в Японии, Новой Зеландии, Южной Корее и на Тайване. - Суд обязал OpenAI передать The New York Times 20 миллионов обезличенных чатов в рамках судебного разбирательства о воспроизведении защищенных материалов издания. - Chad Labs выпустили Chad IDE - среду для вайб-кодинга с встроенными Тик-Током и казино, чтобы не скучать пока AI пишет код. YC-baked, между прочим. - Не новость, а просто Клевый AI Glossary - простые определения ключевых AI-терминов с визуализациями.
-
edited #ReDigest Продолжаем субботнюю рубрику, тут я кратко рассказываю про новости из мира технологий и AI, которые привлекли мое внимание. Дайджест недели: - Anthropic представила решение проблемы масштабирования AI-агентов с MCP - выполнение кода вместо прямых вызовов инструментов сокращает использование токенов на 98.7% при работе с тысячами инструментов. - Новая Siri будет работать на кастомной Gemini - Apple заплатит Google около $1 млрд в год, запуск намечен на весну 2026-го. - Moonshot AI выпустила Kimi K2 Thinking - первую рассуждающую модель с 1 трлн параметров (32 млрд активных через MoE). По утверждениям разработчиков, превосходит GPT-5 и Sonnet 4.5 на тестах агентов. - Еще Moonshot AI представили архитектуру Linear - в разы превосходит предыдущие по скорости и памяти. Модель Kimi-Linear выложили на HuggingFace, плюс агент в терминале Kimi CLI. - Майкл Бэрри (тот самый из "Игры на понижение") поставил $1.1 млрд на крах ИИ-пузыря - купил пут-опционы на Nvidia и Palantir. - Amazon подал иск против Perplexity, требуя запретить агенту Comet совершать покупки на маркетплейсе. Иронично, учитывая что Безос инвестор Perplexity, они клиент AWS, а Amazon разрабатывает собственных AI-агентов для покупок. - Google официально запускает чип Ironwood - в 4 раза быстрее Trillium с 6-кратной памятью. Чипы объединяются в суперпод позволяя обучать гигантские модели как на одном девайсе. - Исследование Wharton School показало смену тренда: 74% руководителей фиксируют положительный ROI от AI. Еженедельное использование выросло до 82% против 37% в 2023-м. Такая ответочка исследованию MIT. - OpenAI подняли лимиты на Codex и выпустили GPT-5-Codex-Mini - всего на 3 п.п. отстает от полной версии на SWE-bench, но в 4 раза дешевле. При 90% лимита Codex автоматически предлагает переключение на Mini. - Cursor обновили модель поиска с семантическим RAG вместо grep. Обучили собственную embedding-модель на траекториях работы агента. Code retention вырос на ~0.3% в среднем и на 2.6% на больших кодовых базах. - Inworld выпустили новую модель генерации речи — вырвалась на 1 место на арене Artificial Analysis при стоимости ниже конкурентов. Доступна в API с поддержкой русского. - ChatGPT добавили функцию прерывания (дополнения) длинных запросов без потери прогресса - полезно для уточнения deep research или GPT-5 Pro запросов на лету. - Cognition добавили в Windsurf Codemaps - аннотированные структурные карты кода с листингом сниппетов и диаграммами для визуального понимания кодовой базы. - Казахстан получит 165K бесплатных лицензий ChatGPT Edu для учителей на 3 года. Также заключили меморандум с Groq и сделку с Nvidia на поставку чипов на $2 млрд. - Perplexity тестируют виртуальную примерочную на iOS - загружаешь цифровой аватар и примеряешь вещи с Perplexity Shopping. А еще в Perplexity добавили поиск по патентам. - "Вайб-кодинг" стало словом года по версии словаря Collins. В 2023-м Collins назвали словом года "AI", в 2024-м - "brat". - Anthropic раздает бесплатные кредиты для Claude Code на вебе: $250 для Pro и $1000 для Max подписчиков. Акция с 4 по 18 ноября. OpenAI тоже раздает $200 для пользователей Codex Cloud до 20 ноября для Plus/Pro пользователей.
-
Недавно случился неожиданный звонок с Shane Thomas, одним из фаундеров Mastra (мой пост). Познакомились в LinkedIn, созвонились поболтать про трейсы, а в итоге больше обсуждали расширение их фреймворка под новые юз-кейсы. Приложил короткий фрагмент нашего разговора с Shane (с его позволения). Вообще, довольно крутая тема: фаундер из популярного стартапа в Сан-Франциско может просто так написать в LinkedIn по поводу фидбэка, а потом созвониться со своими пользователями, записать фидбек прямо на звонке, быть открытым к новым идеям и предложить копнуть глубже. Customer development / DevRel во всей красе. Мы даже успели по-лайвкодить прямо на звонке с шэрингом экрана, лол. Shane также упомянул, что видит растущий интерес к подобной модели, о которой я вчера писал. Договорились еще поговорить про то как лучше интегрировать в фреймворк кейсы, которые я разрабатываю. Интересно наблюдать, как вокруг этой темы складывается целая экосистема. И тут все складывается в одну картину. Claude Agent SDK (и аналоги) с автономными агентами в собственном окружении - действительно мощная штука. Но им явно не хватает оркестрации и traceability. Именно поэтому я сразу подумал о Mastra и LangFuse для своих проектов. А буквально вчера LangFuse анонсировали Agent Tracing and Evaluation - c визуализацией и оптимизацией работы агентов. Те самые инструменты, которых мне лично не хватало там. Красота. А еще сегодня проходит TypeScript AI Conference в Сан-Франциско (и online бесплатно), где выступают и Shane, и Marc Klingen (CEO LangFuse). "Python trains, TypeScript ships" - и правда, считаю TypeScript одним из лучших языков для agentic AI разработки.
-
edited Великий rclone (или иногда агенту нужны просто файлы) Делаем агента для европейской маркетинговой компании. Они год мучались с RAG - индексировали, чанкали, перебирали эмбединги, то лагает, то галлюцинирует, то не находит нужное. Предложил радикально другой подход: выкинуть RAG, вместо этого - Claude Agent SDK + обычная файловая система и MCP как интерфейс. Сделал им прототип - результат настолько лучше, что сначала не поверили. Сравнить можно +/- с тем, насколько Claude Code лучше чем обычный AI чат в кодинге. Поиск по гигабайтам PDF, DOCX, PPTX - доли секунды. Залетает новый файл - агент сразу готов его учитывать. Никакого чанкинга, никакой индексации. По сути - это то же самое что Claude Code или Codex CLI делают с кодовой базой, только тут вместо code base у нас knowledge base. Но есть нюанс, и даже несколько. Вообще, планирую серию постов на эту тему, начну с проблемы синхронизации файлов и ее решения. Итак, проблема. Основной источник знаний в их случае - Google Drive. Там все: презентации клиентам, стратегии, исследования. Но делать квери туда - слишком долго и мы ограничены только встроенным поиском драйва - не пойдет. Нам нужно чтобы Claude Code (Agent SDK) шустро шуршал по файлам. Решение - rclone Rclone - это как rsync для облачных хранилищ. Поддерживает Google Drive, OneDrive, Dropbox и десятки других. Крутая штука: умеет автоматически экспортировать форматы. Google Docs превращается в .docx, Sheets в .xlsx, презентации в .pptx и тд. rclone sync "gdrive:/" "/local/path" --drive-export-formats docx,xlsx,pptx Файлы летят на сервер, конвертируются, агент работает с ними как с обычными файлами. Почему file-first лучше Storage дешевый и быстрый. Иногда (особенно для использования внутри компании) куда проще загрузить все на диск и работать с файлами напрямую, чем городить удаленный инджестинг с векторными базами и пайплайн индексации. Современные CLI агенты прекрасно справляются с файловым поиском. "Найди все упоминания проекта X за последние 3 месяца" - делает за секунды через обычные файловые операции. Когда нужно читает файлы по частям или целиком. А еще на лету пишет скрипты для работы с ними если надо (!), собственно эту концепцию сейчас и продвигают Антропик со своими Skills. В общем, если строите агента для работы с документами: - Посмотрите на file-first подход. Может быть быстрее и надежнее RAG. - Используйте rclone для синхронизации облачных хранилищ. - Дайте агенту доступ к файловой системе и нормальным тулам поиска - часто лучше наивного RAG. --- Этот проект оказался интереснее чем я ожидал. Куча нюансов, неочевидных решений и инсайтов, которыми буду делиться дальше. Продолжение следует.
-
#ReDigest Продолжаем субботнюю рубрику, тут я кратко рассказываю про новости из мира технологий и AI, которые привлекли мое внимание. Дайджест недели: - Вышла MiniMax M2 новая SOTA в опенсорсе с 230 млрд параметров (10 млрд активных). Вошла в топ-5 умнейших моделей по Artificial Analysis, обогнав Grok 4 Fast и показав паритет с Sonnet 4.5. Ограниченное время доступна бесплатно в API, потом будет стоить 8% от цены Sonnet. - Вышел Cursor 2.0 с собственной моделью Composer работает в 4 раза быстрее аналогов, завершает задачи меньше чем за 30 секунд. Интерфейс теперь multi-agent с возможностью запускать разные модели параллельно, встроенный браузер для тестирования и голосовой режим. - Adobe на MAX 2025 представила масштабное обновление Creative Cloud. AI-ассистенты для Photoshop на агентном AI, Firefly Image Model 5 с нативным 4MP, партнерство с Gemini 2.5 Flash и FLUX.1 для Generative Fill, AI Object Mask в Premiere Pro для автоматического ротоскопинга. - OpenAI релизнули gpt-oss-safeguard (20B и 120B) - открытые модели для классификации контента на предмет безопасности. - Devin представили SWE-1.5 для Windsurf - выдает до 950 токенов/сек благодаря партнерству с Cerebras, что в 13 раз быстрее Sonnet 4.5. Очевидный ответ на запуск Cursor 2.0. - OpenAI завершила реструктуризацию: некоммерческая OpenAI Foundation теперь владеет долей в $130 млрд. Коммерческая часть стала OpenAI Group PBC и планирует IPO к началу 2027 с оценкой до $1 трлн - один из крупнейших IPO в истории. Еще Microsoft и OpenAI объявили о новом соглашении. - OpenAI выпустили Aardvark - агента-кибербезопасника на GPT-5, который автономно отслеживает коммиты, анализирует код и находит уязвимости. В тестах нашел 92% багов. - Маск запустил Grokipedia - AI-энциклопедию как альтернативу Wikipedia. 885 тысяч статей против 8 млн у Wikipedia. Работает на Grok с доступом к постам X. Сайт упал через час, а статьи уже уличили в предвзятости. - Amazon сокращает 14 000 корпоративных сотрудников (4% офисных работников). Больше 78% - менеджеры уровня 5-7, 80% работали в ритейле, HR и логистике. - Google выпустили Pomelli - агента для создания маркетингового контента. Считывает айдентику с сайта компании и генерирует постеры/видео для соцсетей с возможностью редактирования цветов и текста. - Anthropic запустила Claude for Excel в research preview (первые 1000 Max, Enterprise и Teams пользователей) и расширила Claude for Financial Services с коннекторами для рыночных данных в реальном времени. - OpenAI добавили в Sora character cameos - возможность превратить почти что угодно (питомцев, иллюстрации, игрушки) в переиспользуемые аватары для AI-видео. -Cartesia представили Sonic-3 - голосовую модель на State-Space архитектуре. Генерирует естественную речь в реальном времени на 42 языках. - 1X из Норвегии открыла предзаказ на домашнего робота NEO за $20к (или $500/месяц). И тут же скандал: оказалось для сложных задач требуется удаленное управление живыми операторами. - Grammarly переименовалась в Superhuman (после покупки email-компании) и запускает ассистента с доступом к email, документам и корпоративным данным Superhuman Go. - Hailuo AI выпустили MiniMax Music 2.0 - генерирует музыку до 5 минут с тонким контролем стиля и инструментов. А также Hailuo 2.3 для генерации видео. - Telegram анонсировал децентрализованную сеть Cocoon для аренды GPU под инференс AI-моделей с вознаграждением владельцам в TON. - Canva сделала весь пакет Affinity (аналоги Illustrator, Photoshop и InDesign) полностью бесплатным, качественно обновив весь пакет.
-
RLI - довольно уникальный в своем роде серьезный бенчмарк, который меряет не абстрактные навыки, а способность AI делать настоящую оплачиваемую работу, сравнивая лоб в лоб с фрилансерами на Upwork. И он показал что AI-агенты проваливают 97.5% реальных задач проектов. Довольно интересно, хотя не все так просто - давайте разбираться. Итак буквально на днях исследователи из Scale выпустили Remote Labor Index (RLI) - взяли реальные фриланс-проекты, которые люди делали за деньги. От 3D-анимации до архитектурных планов, от создания игр до научных документов. Общая стоимость работ - $144K. Средний проект занимал у человека 29 часов и стоил $633. Сравнивали GPT-5, Claude Sonnet 4.5, Gemini 2.5 Pro, Manus. Лучший агент (Manus) выполнил 2.5% проектов. Manus заработал $1720 из возможных $144K. Важный нюанс: RLI тестирует не производственные операции типа "суммаризируй документ" или "напиши функцию", а проекты - законченную работу, которые фрилансеры выполняли за деньги. Методология: наняли 358 верифицированных фрилансеров с Upwork, собрали 550 проектов, отфильтровали до 240 качественных. Каждый проект - это brief + input files + human deliverable, который реальный клиент принял и оплатил. Оценку делали вручную обученные эксперты (94.4% agreement между оценщиками) по принципу "принял бы reasonable client эту работу или нет". Внимательный читатель заметит: где software development? Ведь именно там агенты показывают лучшие результаты - SWE-Bench и прочие coding benchmarks. Код в RLI есть (веб-разработка, игры), но его намеренно меньше - реальный рынок гораздо разнообразнее. Методологические вопросы Странная история с выбором моделей: сравнивают специализированную агентную систему Manus с продуктами широкого назначения типа Claude и GPT. Было бы логичнее включить Claude Code и обвесить его тулами, например. Второй момент - воспроизводимость. Такой замороченный бенчмарк с ручной оценкой дорого поддерживать. Да и открыли только 10 из 240 проектов (чтобы избежать contamination), manual evaluation занимает в среднем 11-17 минут на проект. Масштабировать это сложно, надеюсь не забросят. Где побеждает и где проваливается AI хорошо справился с узким набором задач: - Аудио: звуковые эффекты, разделение вокала от инструментов - Генерация картинок: логотипы, ads - Написание отчетов - Data visualization и веб-скрейпинг То есть там, где либо чистая генерация контента, либо простой код. Провалы кластеризуются так: - 45.6% - низкое качество работы (буквально "child-like drawings", любительский уровень) - 35.7% - неполные deliverables (видео на 8 секунд вместо 8 минут, missing files) - 17.6% - технические проблемы (битые файлы, неправильные форматы) - 14.8% - неконсистентность (дизайн дома меняется между разными 3D-видами) Кстати, забавная деталь: GPT-5 лучше работал через CLI (1.7% automation), чем через computer-use интерфейс (0.8%). Практические выводы Для разработчиков AI-продуктов: - Не обещайте клиентам полную автоматизацию сложных процессов. Даже близко не готовы. - Human-in-the-loop очень важен. - Узкие задачи работают и чем дальше тем лучше. Для всех: - Ваша работа в безопасности (пока) - Но Elo scores растут с каждой новой моделью - траектория идет вверх. - Бенчмарк показывает: между "AI производит что-то похожее на правду" и "AI делает работу профессионального уровня" - огромная пропасть. - 2.5% success rate одновременно и отрезвляет, и показывает прогресс: ну типа представьте, машине дали коммерческий проект на вход как человеку, не подготавливая как-то специально и не поправляя по ходу выполнения, и она на полном автомате хоть в каком-то проценте случаев поняла и выдала результат, который условно приняли и оплатили. Исследование детальное, стоит полистать: https://arxiv.org/abs/2510.26787 У них есть интерактивный сайт, где можно сравнить работы людей и моделей - реально интересно посмотреть на конкретные примеры провалов и успехов. 🔥 ➕ 🔁
-
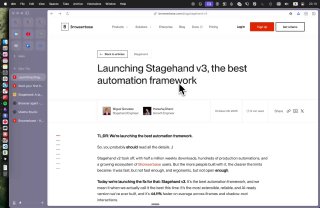
edited Новый Stagehand 🤝 Новая Mastra Я уже писал про Mastra как про один из самых крутых фреймворков для AI-агентов. Но за последние недели там произошел серьезный апгрейд, а Stagehand вообще переработали - ушли от Playwright и полностью переписали систему и теперь коннектятся напрямую к Chrome через DevTools Protocol (CDP) - это дало +44% к скорости. Доступны тулы типа act(), extract(), observe() и agent() - можно давать задания натуральным языком, есть богатый API. В Mastra добавили темплейты агентов - я на их основе сделал browser use агента (см видео). Теперь можно разворачивать свои решения в пару кликов вместо того чтобы все настраивать с нуля. Но самое крутое - переработали observability. Dev Tools в Mastra вообще шикарны - тестируешь агента и сразу видишь весь execution flow, можешь отдельно играть с тулами и менять параметры. Мой текущий use case: Stagehand + Mastra для автоматического тестирования в одном из проектов. Задача валидировать что более быстрые AI-парсеры работают корректно, Eval агент видит то же самое что и человек когда открывает браузер. Еще можно: - Автоматизировать рутинные действия в браузере (заполнение форм, сбор данных) - Строить агентов которые работают с legacy-интерфейсами где нет API - Давать быстрые 'руки' своим агентам, например строить Shopping Assistant - Тестировать UI changes без хрупких селекторов Stagehand выкладывает свои Evals где можно подобрать оптимальную модель по цене и скорости для своих задач. Доступна облачная версия через Browserbase и open source с MIT лицензией. Если делаете что-то с browser automation или AI-агентами - попробуйте эту связку. DX отличный, особенно если раньше мучились с Playwright или Selenium. 🔥 ➕ 🔁
-
edited #ReDigest Продолжаем субботнюю рубрику, тут я кратко рассказываю про новости из мира технологий и AI, которые привлекли мое внимание. Дайджест недели: - OpenAI выпустили ИИ-браузер Atlas на базе Chromium: ChatGPT вместо традиционного поиска, доступ к памяти ChatGPT для персонализации + имеет агентный режим для автономной навигации - Anthropic представили Claude Code on the web и на iPhone - аналог Jules от Google и Codex Cloud. Подключаешь репу, ставишь задачу, получаешь PR. -DeepSeek представила OCR-систему, которая сжимает текст из изображений в 10 раз с сохранением 97% информации. Это новый и довольно эффективный подход к проблеме длинного контекста. - 20 октября целый регион AWS us-east-1 пережил масштабный сбой на 15 часов, который затронул более 113 сервисов. Были парализованы банки, авиакомпании, игровые платформы и многое другое. Более 6 миллионов отчетов о сбоях, экономический ущерб - сотни миллиардов долларов. - OpenAI планирует запустить "Sign in with ChatGPT" - компании смогут позволить пользователям использовать их ChatGPT-квоту для доступа к AI-функциям в сторонних инструментах. Потенциально большой сдвиг в экосистеме AI-приложений. - Meta сокращает около 600 позиций в AI-подразделении из нескольких тысяч сотрудников в FAIR: говорят меньше людей - меньше согласований. - Google обновили ИИ-конструктор приложений в AI Studio - теперь можно создать приложение одним промптом с Gemini 2.5 Pro, Nano Banana для картинок и Gemini Live для аудио. Файлы сохраняются в Drive, можно пушить в GitHub и деплоить. - ChatGPT для бизнеса получил функцию корпоративного знания - интеграция со Slack, SharePoint, Google Drive, GitHub. Цель OpenAI — превратить ChatGPT в разговорную поисковую систему по корпоративным данным. - Reddit подал иск против четырех компаний за незаконный скрапинг данных: Perplexity, SerpApi, Oxylabs и российскую AWMProxy. Reddit устроил ловушку: создал тестовый пост, который мог проиндексировать только Google и контент тут же оказался там где не надо. - Meta меняет условия WhatsApp Business API, запрещая универсальные чат-боты с 15 января 2026. Под удар попадают боты от OpenAI, Perplexity, Luzia и Poke с аудиторией в 3 млрд пользователей. - Langchain обновили опенсорсные фреймворки для создания ИИ-агентов до стабильной версии 1.0. Получили новый раунд инвестиций, кстати. - Claude Desktop получил голосовой ввод, быстрый доступ и поддержку скриншотов. - Google добавили ризонинг в Google Earth - фреймворк Geospatial Reasoning на базе Gemini автоматически соединяет предиктивные модели и данные в единую систему анализа Земли. - Qwen теперь генерирует подкасты на основе deep research - ИИ-ведущие перескажут то, что ассистент нашел в интернете. Также может превратить ответ в интерактивный веб-сайт с графиками и анимациями. Прям как NotebookLM. - ChatGPT получил совместную работу над проектами. Доступно всем, включая бесплатных пользователей. - Alibaba начала продажу смарт-очков Quark AI Glasses с Qwen на борту - звонки, перевод речи в реальном времени, музыка и ИИ-ассистент с камерой. Цена от $660. - ИИ-конструктор приложений Lovable запустил интеграцию с Shopify - теперь можно завайбкодить полноценный интернет-магазин. - Perplexity выпустили 40-страничный гайд по эффективному внедрению ИИ в рабочие процессы с промптами для автоматизации рутины. - Вышла интересная инициатива Agent Client Protocol (ACP) - стандартизирует коммуникацию между редакторами кода/IDE и кодинг-агентами, которые используют генеративный AI для автономного изменения кода.
-
🔥 Claude Agent Skills - полезные процедурные навыки для агента. Давайте разбираться! Итак, Anthropic на прошлой неделе запустили Agent Skills - по сути предложили механизм расширения навыков для агентов, вместо того чтобы каждый раз объяснять модели как делать задачу, ты один раз пакуешь инструкции, скрипты и ресурсы в папку - и Claude сам загружает это когда нужно. Технически Skill - это просто папка с файлом SKILL.md внутри + любые доп. файлы. Сначала заголовок с описанием, а дальше - markdown с инструкциями. Claude видит описания всех доступных skills в system prompt и загружает нужный когда понимает что задача подходит. Важный аспект: скилы могут запускать скрипты в sandboxed окружении - это, так сказать, основная супер-сила. Помните, я писал недавно про то как Claude научился создавать и редактировать реальные файлы: excel, word, powerpoint - так вот это как раз были Skills. Самым мощным агентам нужен runtime и Антропики (и не только они) активно развивают эту идею. Окей, ну если сама модель и так может писать код и запускать его чтобы делать для нас всякие полезные штуки (вычисления, таблицы, документы, изображения), то зачем нужны Skills, спросите вы? Как минимум для 3 целей: 1. эффективный контекст менеджмент: скилы очень экономно расходуют контекст и позволяют постепенно раскрывать детали по мере необходимости 2. предсказуемый результат: скрипты и CLI-тулы и 'рецепты' к ним дают детерминированный результат сохраняя гибкость самого агента 3. дистрибуция: можно делиться через zip-архивы или Claude Code плагины + пишут что они разрабатывают более удобные способы делиться скилами в рамках организации и даже будет Marketplace Да, кстати, они работают во всех продуктах Claude: Claude App, Claude Code и даже в API - большой простор для автоматизаций. На видео я 'научил' Claude экспортировать mermaid как картинку (давно такого не хватало). Заметил что их часто сравнивают с Sub Agents и MCP, хотя они скорее дополняют друг друга, а не заменяют, сделал небольшую сравнительную таблицу: Skills MCP Subagents Параллелизация - - + Stackable + ± - Доступ к сети ± + + Токенов на старте ~50 ~5k+ ~1k Работает в API + + - Работает в CC + + + Работает в App + ± - Setup сложность * ** *** Изолированная среда + - - Progressive + - - disclosure Портативность/ *** ** * удобство дистр. И конечно можно комбинировать, например Skills описывают процесс и диктуют процедуру, а MCP дает доступ к данным. Skills могут включать код, они могут исполнять его и рефлексировать над результатом исполнения. Но что есть из коробки? Я покопался в их "виртуалке" и это по сути Ubuntu 24.04 с Python 3.12 и Node.js 22, предустановленными библиотеками для обработки документов (docx/pdf/pptx/xlsx), медиа (FFmpeg/ImageMagick), веб-автоматизации (Playwright) и DS (pandas/numpy/scikit-learn) и др. - подробности я выложил в этом gist. Обратите внимание, что доступ к сети ограничен, но этим можно управлять (напр. в десктопной Claude это Capabilities -> Domain allowlist). Где можно применить: - Для разработчиков: код-ревью по стандартам, QA, умная кодогенерация - Legal Tech: драфтинг контрактов, комплайенс-отчеты, сравнение версий документов с выделением рисков и тд - Для офиса: презентации в корп. стиле, репорты в стандартном формате, КП, financial modeling, бюджеты и тд - Тренеры, преподаватели, архитекторы: планы питания и тренировок, учебные программы, сметы и спецификации проектов Полезные ресурсы по теме: - Официальный анонс от Anthropic и гайд - Engineering deep-dive - Официальная документация - Claude Cookbook по Skills - Официальный репозиторий с примерами - готовый код Skills для кастомизации - Мой gist с деталями sandbox окружения - что доступно "из коробки" Пост получился большим, не успел рассказать про свой опыт создания и использования, чувствую это не последний пост на эту тему. Если считаете пост полезным - сохраняйте/делитесь) 🔥➕🔁