Там, где люди учились AI, я преподавал.
С 18 лет читаю лекции по AI: МФТИ, ВШЭ, МГУ, Coursera, Сколково. Строю AI/ML-команды в компаниях. Пишу про ИИ без хайпа, образование, карьеру и преподавание изнутри.
Менеджер: @mariekap
РКН: 5140322136
Subscribers12.2K +0 24h
Reach per post (ERR)25.2%3.1K avg views
Posting6.3/weeklast 2 days ago
Reactions per 1K views7.2❤ 🔥 👍
repost
#ML
Последователи Decision Models, Jev и иже с ними уже обретают черты религиозного культа 😵💫
Особо продвинутые самопровозглашённые пророки уже требуют упразднить скоринговые и NBO/NBA модели — всё же «заменят Decision Models».
Тем, кто изучает ML исключительно по Telegram-каналам и верит в «калиброванные вероятности из коробки», посвящается.
Что такое калиброванная вероятность?
От бинарного классификатора часто хочется получить не метку, а скор от 0 до 1, соответствующий вероятности события. Например, из 1000 заёмщиков со скором 0.6 примерно 600 должны выйти в дефолт, а со скором 0.05 — примерно 50. Если это свойство выполняется на всём диапазоне скоров, модель идеально откалибрована.
На практике скоры разбивают на бины (например, 0–0.05, 0.05–0.1), сравнивая среднюю вероятность дефолта (PD) с фактической долей дефолтов (DR). Так строят калибровочную кривую.
Взвешенное по доле наблюдений в бинах среднее абсолютных разностей PD и DR называется ECE (Expected Calibration Error). Преобразование выходов модели для улучшения соответствия предсказанных вероятностей фактическим частотам называют калибровкой.
Для других задач вместо DR используют ER (Event Rate). Есть и более слабое условие — calibration-in-the-large, когда средний скор совпадает с ER всей выборки.
ER может меняться со временем. В кредитном скоринге различают PIT (Point-in-Time), учитывающий текущие экономические условия, и TTC (Through-the-Cycle), отражающий долгосрочный риск на протяжении экономического цикла.
Но скоры распределены неравномерно, поэтому в разных бинах разное количество наблюдений и разная точность оценки DR. Следовательно, у калибровочных кривых есть доверительные интервалы.
Все еще сложнее
Aleatoric uncertainty — неопределённость самого исхода. Даже зная, что вероятность дефолта 50%, мы не можем уверенно предсказать исход для конкретного заёмщика.
Epistemic uncertainty (EU) — недостаток знаний модели. Например, когда похожих заёмщиков почти не было в обучающей выборке. Два клиента могут получить одинаковый скор 0.5, хотя для одного у нас сотни тысяч похожих наблюдений, а для другого — практически ни одного. EU приближённо оценивают через ансамбли и бутстрап. В CatBoost для этого есть Virtual Ensembles, позволяющие оценивать Data и Knowledge Uncertainty.
Если все модели ансамбля предсказывают около 0.5, это может указывать на высокую неопределённость исхода. Если половина предсказывает 0.1, а половина 0.9 — скорее на недостаток знаний. Хотя ансамбли тоже умеют дружно ошибаться.
Калибровка, Aleatoric и Epistemic uncertainty — разные вещи.
Даже идеально откалиброванная модель может систематически ошибаться на отдельных сегментах или при изменении распределения данных.
Для серьёзных бизнес-кейсов одного калиброванного скора недостаточно. Нужны независимая валидация, проверка калибровки с доверительными интервалами, устойчивости во времени и по сегментам, иногда — отдельная оценка Epistemic uncertainty.
А для NBO/NBA вероятность события вообще не равна полезности действия. Нужны стоимости ошибок, ограничения и оценка влияния действий на результат.
Вернёмся к Jev
Когда заявляют о «калиброванных вероятностях из коробки», хочется спросить:
• На чем калибровали и проверяли?
• Что происходит при смещении данных и на новых доменах?
• Как оценивается Epistemic uncertainty?
Пока ответов нет, число 0.97 на выходе Decision Model — просто выход модели, вероятностную интерпретацию которого ещё нужно подтвердить.
И тут бы мне продемонстрировать калибровку Jev на каком-нибудь датасете, но мне лень, поскольку это сделали вскоре после её выхода на двух задачах классификации текстов.
А чуть позже — на задаче обнаружения prompt injection.
Результаты ожидаемо показали, что калибровки на произвольной новой задаче из коробки нет.
Итого: чтобы использовать Jev в проде, её придётся долго и упорно тестировать на вашем рейсе — с выдумкой и смекалкой.
А если нужно классифицировать тексты и есть разметка, разумнее взять предобученный BERT, дообучить классификационную голову (при необходимости — и энкодер), откалибровать и провалидировать.
edited
Сидел общался с другом, по профессии искушенным в сфере отношений с широкой публикой. Спрашиваю его: «дай совет, как мне дальше канал растить?». А он, имея некоторую предысторию диалога за вечер, и говорит: «вот ты почему Jev в своем канале не обосрал?». Я честно ответил, что стараюсь никого не обсирать, потому что не хочу устраивать никаким своим подписчикам инсульт жопы, и вообще самый оскорбительный и вызывавший хейт пост в истории моего канала - это поздравление с 8 марта (кто помнит, тот помнит)). А вот Никита @datarascals не стал скромничать и прошелся по адептам трансформерных decision models, за что ему большое человеческое спасибо. Причем написал без демагогии и эмоций, а четко и по делу. Рекомендую во-первых к прочтению, а во-вторых, тем кто не сможет дочитать до конца, даже не пытаться интерпретировать вероятности от decision models: будет только хуже.
Нейрояз продолжает захват интернета
То и дело люди с серьезным лицом в своих шортсах и рилсах вещают: "и вот тут начинается самое интересное". Плохо ли, что они используют ИИ для подготовки? Нет. А что же тогда не так? Да то, что одни и те же штапмы очень быстро начинают бесить. Вообще не важно, кто там текст написал, хочется, чтобы от него не горело так сильно 🤬
Базовая стратегия - системный промпт про то, как избегать нейрояза, с подробным перечислением, что такое хорошо и что такое плохо. Другая базовая стратегия - использование всяких скиллов про хьюманизацию текста.
Мой лучший метод делать текст более человеческим, это не делегировать нейронке само сочинение текста, а хотя бы уж надиктовать (лучше написать) фактуру самостоятельно сплошным потоком мыслей, а сетку использовать уже для структурирования получившегося текста, сбора дополнительной фактуры, проверки логики и анализа противоречий в своих рассуждениях. В итоге сгенерированный нейросетью текст почти полностью опирается на мои же слова, но экономит часть времени на переписывании и приведении в какую-то структуру, а также позволяет за счет дополнительного анализа выдать более качественный материал.
А как спасаетесь от нейрояза вы? 🤔
repost
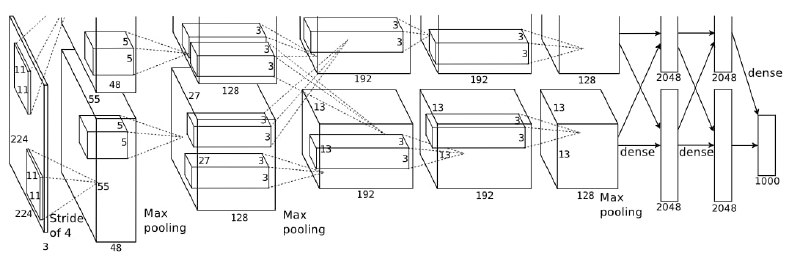
Фан-факт: в статье про AlexNet есть обрезанное изображение сети AlexNet. По одной из версий, Алекс Крижевский обрезал изображение, чтобы итоговая статья уместилась в жесткое ограничение NIPS на длину статьи в 8 страниц.
Причем из-за того что картинка была обрезанная в оригинальной статье, во все презентации в мире она попала в таком же обрезанном виде :) Так что если хотите прославиться в AI - дорисуйте картинку и запостите на реддит 😁😁😁 Кстати, дорисованные версии в интернете иногда и правда встречаются
Есть кстати один человек, сильно преуспевший в работе в IT, который говорил: «я не читаю бизнес-литературу, потому что все знания человечества есть в художественной». Продолжая тему предыдущего поста: какие художественные книги вы бы советовали прочитать вместо чтения бизнес-литературы и книжек по саморазвитию? :)
А посоветуйте хороший курс по чему-то про саморазвитие (ну там тайм-менеджмент, масштабирование бизнеса, управление стрессом и тревожностью, что угодно подойдет), который ведут люди, которые чего-то в жизни и карьере достигли. Интересно посмотреть, как такое выстраивается методически, когда лектор вроде не воздухан, но и предмет не наука.
У нас в MLinside завтра небольшой дебют: первый открытый вебинар нашего первого курса для продактов. До этого мы учили инженеров, и я ждал, что продакты будут спрашивать про промпты и инструменты. Но пока собирал программу, самый частый вопрос был про деньги: «А агенты вообще окупаются? Может выйти, что руками дешевле?»
Вопрос настолько хороший, что мы вынесли его в отдельный вебинар.
15 октября в 19:30 по МСК - «Когда AI-агент окупается: считаем экономику на живом кейсе». Ведет Максим Шаланкин, ML Team Lead в Big Data МТС Web Services и один из авторов курса. Берет реальную задачу и раскладывает по цифрам: во что обходится агент, с какого момента отбивается и когда проще заплатить человеку.
Зарегистрироваться на вебинар: https://live.mlinside.ru/
Приходите. Пропаганды «AI изменит всё» не будет, задолбавших лозунгов в духе "AI убил ютьюб/маркетинговые агенства/дизайнеров/разработчиков" - тоже. Трезво, взвешенно, без буллшита - все, что мы ценим в MLinside.
Каждый раз, когда человек из службы поддержки, доставки, такси или чего бы то ни было еще из сферы услуг говорит мне "хорошего вечера", а отвечаю "и вам тоже". Сначала я немного смущался, что это как официанту сказать "и вам тоже" в ответ на "приятного аппетита". Ну серьезно, люди на смене, какой еще нафиг хороший вечер. Но со временем я понял: всегда может быть хуже. Поэтому теперь желаю всем хорошего вечера :)
(poll without text)
Telegram doesn't show this post on the web. Open it in Telegram to see it.
Составляю сейчас план лекции, которую очень давно хотел сделать: про то как математика проложила нам путь к искусственному интеллекту, который мы знаем сейчас, какие рубежи мы начали преодолевать только что, и чего ожидать дальше. В процессе выясняется много интересного, поэтому запилю несколько опросов по теме :)
Сегодня списывался с другом из Яндекса и вместо обычного «работы много» он честно сказал: «соррян, пока недоступен, моя команда за последние трое суток поспала вот сегодня часов пять».
Был такой анекдот: «Хорошо работать пожарным: сидим с мужиками байки травим, в домино играем, но как пожар - так хоть сразу увольняйся». И ведь при всех моральных вопросах просто уволиться в трудный момент это тоже выбор, технически он возможен.
Спасибо ребятам, что они такой выбор не делают. И вообще всем тем, кто не бежит от трудностей и превозмогает. Не только в Яндексе, разумеется.
Вчера закончил запись первой части курса «AI для топов» :) Скоро в MLinside
Так началось мое утро субботы :) На правах блохера был на экскурсии
Барашек в ящике
10 октября выступаю... нет, не на митапе по ML, а на Фандом Фесте! :)
На мероприятии попробуем заглянуть в недалёкое будущее вместе с кинопрокатной компанией «Русский Репортаж». Сначала поговорим о том, как людям разделить мир с ИИ, а затем посмотрим премьеру с Каннского кинофестиваля — фильм «Барашек в ящике» (кто сразу вспомнил про "Маленького принца" - вы вспомнили абсолютно правильно).
По сюжету фильма семья усыновляет человекоподобного робота. Но сможет ли андроид заменить им настоящего сына и можно ли полюбить машину как близкого человека? И где проходит граница между нашими проекциями и настоящими чувствами? (это кстати небольшой спойлер к названию) 🤖
Обсуждать фильм будут:
💫 Андрей Чувагин — кинокритик, автор телеграм-канала и подкаста Fat Cinema
💫 Виктор Кантор — ваш покорный слуга, автор канала Kantor AI :)
Билеты брать здесь: https://fandomvk.com
ad
GPT Model Hub: готовые ИИ-модели по API в MWS Cloud Platform
GPT Model Hub – это сервис MWS Cloud Platform для подключения готовых LLM, embedding-, reranker- и речевых моделей через OpenAI-совместимый API.
Модели уже развернуты в облачной инфраструктуре MWS, поэтому не нужно самостоятельно заводить GPU и обслуживать инференс.
В каталоге есть модели для текста, кода, RAG, поиска, изображений и речи, например GLM 5.3, GPT OSS 120B, Qwen3.6 35B A3B, Kimi K2.6 и Gemma 4. Для RAG-сценариев доступны embedding- и reranker-модели bge.
Сервис поддерживает IAM, сервисные аккаунты, биллинг и контроль потребления. Запросы и ответы обрабатываются в контуре MWS Cloud, не сохраняются и не используются для обучения моделей.
Модели в статусе Preview не тарифицируются: SLA на них нет, но для экспериментов и прототипов это удобный способ быстро сравнить модели на своих задачах.
Начать можно с приветственным грантом: 3000 ₽ для физических лиц и 10 000 ₽ для юридических лиц и ИП.
edited
Вчера выступал на YaC/e (Yet Another Conference on education) в Яндексе, постил про нее чуть раньше в канале. У нас была дискуссия с Валей Бронер (Яндекс), Леной Кантонистовой (ВШЭ, кстати выиграла Yandex ML Prize в этом году и руководит самой большой онлайн-магистратурой по ИИ) и Сашей Мальцевым (Яндекс).
Во-первых, всегда радостно выступить в приятной компании. Во-вторых, унес с дискуссии несколько ценных мыслей про образование во времена ИИ. Чуть структурирую и напишу сюда. В-третьих, все это было в офисе Яндекса на Льва Толстого, так что было очень тепло и ностальгически ❤️
Свершилось: свой претрейн
Я уже ранее писал, почему в России всё ещё нет своей конкурентоспособной LLM со своим pretrain. В посте, как тексте на массовую аудиторию, я осторожничал и говорил, что на горизонте нескольких лет ситуация может измениться. На живых выступлениях был чуть более категоричен: рано или поздно появится, уж как минимум когда наваливание вычислительных мощностей перестанет быть геймчейнджером.
Но вот с моего поста прошли никакие не несколько лет, а всего два месяца, а Яндекс уже выпустил AliceAI-Foundation-80B-A3B-Base (которую я уже вскользь упоминал пару дней назад). Это обученная с нуля модель с открытыми весами на 80 млрд параметров всего и 3 млрд активных на токен. В общем, теперь у нас есть результат своего претрейна. Причем у всех компаний разом (я про веса, конечно, а не процесс), потому что компания заопенсорсила модель. Так что давайте разбираться.
Во-первых, модель БЕЗ пост-трейна, и в этом в том числе её ценность. Её еще не испортили файнтюном под конкретные тексты и аллайнментом на какой-то определенный подход к выдаче реворда, поэтому все те, кто баловались дообучением, могут продолжить уже с Alice-AI-Foundation.
Во-вторых, уже видел первые отклики на модель: Turing Post включил модель в подборку моделей недели, а Аман Чадха из Google DeepMind отметил релиз в контексте перехода от размера моделей к эффективности. А японский разработчик уже портировал модель на MLX и подготовил экспериментальную GGUF-версию с патчем для llama.cpp.
В-третьих, любителей вопросов "у вас ML или AI", "а сколько у вас работает AI-агентов" и "а что это у нас 80 млрд параметров, если у всего мира уже триллионники пошли" тоже можно успокоить: задач, в которых реально для автоматизации или оптимизации бизнес-процесса нужен триллионник не то чтобы много, ведь экономика внедрения, как мы уже обсуждали с вами в недавнем посте, зависит еще и от затрат.
В тему «думать, пока пишешь текст», мне кажется это работает как «советы давать или делать».
Когда пишешь текст, твои мысли мало того что сформулированы, так еще и зафиксированы на бумаге. Ты видишь их со всеми недостатками прямо перед собой (если, конечно, читаешь то, что пишешь :)
Очень похоже на то, как человеку, который выглядит умным, когда критикует или дает советы, дают возможность себя проявить (например, назначают руководителем/врио или просто предлагают показать, как нужно делать), и внезапно весь ум и прозорливость куда-то загадочно растворяется.
Прослеживается общий принцип - чем более нечеткой, избегающей ответственности и проверки, и в целом оторванной от практики становится мыслительная деятельность, тем менее она на этой практике и применима.
В контексте использования LLM это может означать ценность периодического выполнения руками каких-то отдельных задач, а также неделегирования самого процесса мышления.