
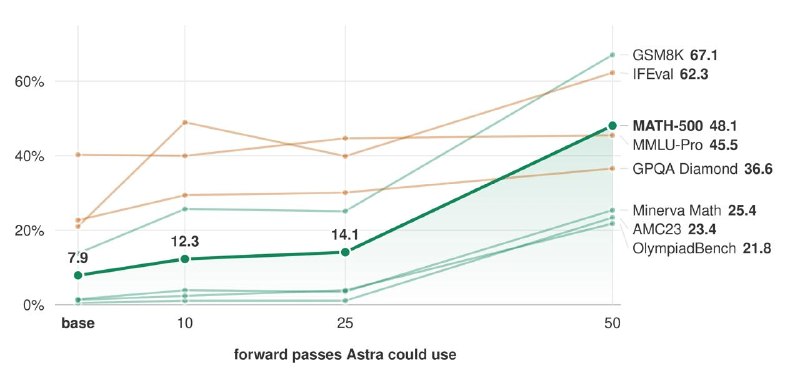
В отчете MIT от 2 ноября GPT-6 Astra дали доступ к весам Qwen3.5-0.8B через Python и разрешили пробные запуски, но запретили "в лоб" использовать градиентный спуск. В лучшем варианте она поправила 0,016% весов. Бенчмарк MATH-500 вырос с 7,9% до 48,1%, GSM8K - с 13,8% до 67,1%. MATH-500 это 500 задач по алгебре, геометрии, теории чисел, комбинаторике и другим темам, включая задачи олимпиадного уровня, а GSM8K - школьные текстовые задачи: покупки, расстояния, количества и т.п. На первом графике в аттаче к посту сравниваются отдельные запуски с разными бюджетами пробных прогонов. Существенная деталь: Qwen до редактирования весов постоянно зацикливался в рассуждениях. После правки доля ответов, упиравшихся в лимит токенов, упала с 93% до 33%. Авторы объясняют выигрыш починкой именно этого поведения. Так что радоваться, что модель научили именно математике пока рановато: на другой модели, которая почти не зацикливалась, убедительного роста не получилось. Так что исследование получилось скорее про про адресный ремонт уже обученной сети. А вот в Text-to-LoRA, ICML 2025, Sakana AI заранее обучили сеть генерировать небольшую добавку к весам по текстовому описанию задачи. Один из ее вариантов поднял GSM8K у Mistral-7B с 40,9% до 47,3% без отдельного дообучения под эту задачу при применении. Но обычный специально обученный LoRA все еще был лучше - 53,5%. В Doc-to-LoRA, ICML 2026, на вход подают документ, а сеть записывает его информацию в такой адаптер. Т.е. концептуально проверяют возможность добавить новый документ в контекст напрямую через обновление весов модели: после добавления адаптера модель отвечает уже без явного включения документа в контекст. На 2WikiMultihopQA (бенчмарк, где для ответа нужно связать сведения из нескольких статей Википедии) обновление занимало около 0,2 секунды против 40 секунд у обычной дистилляции с заранее известными тестовыми вопросами. На втором графике со SQuAD (бенчмарк на понимание текста: модели дают фрагмент статьи Википедии и вопрос, ответ на который содержится в этом фрагменте) звездочки - два варианта метода из статьи. В итоге требовалось меньше секунды на обновление, при этом сохранялось около 82,5% качества ответов модели с полным документом (это, если что, отношение метрик ROUGE-L F1 с адаптером и с самим документом, а не 82,5% правильных ответов). Бесплатного образования, увы, снова не получилось: сеть Doc-to-LoRA сначала обучали примерно пять дней на восьми H200, да и ученик уже был предобучен. Быстрым стал только следующий конкретный апдейт. Так что осадочек после свежих новостей и после Doc-2-LoRA остается двойственный. Чудес с тем, что "нейросети научились напрямую править веса другой нейросети и учить решать задачки бенчмарка" не случилось. Но сама возможность передавать знания и менять поведение сети через прямую запись в веса у моделей в каком-то виде уже есть. Нам же с вами пока придется продолжать читать учебник, а получить им по голове, к сожалению, пока всё еще недостаточно. В следующий раз поговорим о том, что можно делать, чтобы ускорять обучение уже не сетки, а наше с вами.