
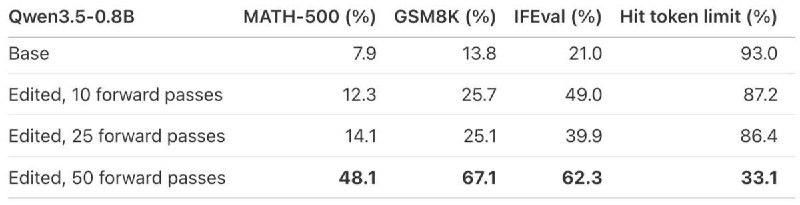
Исследователи из MIT CSAIL представили метод Weight-Space Programming, позволяющий крупным языковым моделям редактировать веса других нейросетей без традиционного обучения. Модель Astra продемонстрировала способность напрямую изменять структуру чужих сетей и интерпретировать их назначение, просто читая массивы данных. В ходе экспериментов Astra изменила всего 0,016% весов модели Qwen3.5-0.8B. Это привело к росту показателей точности на тесте MATH-500 с 7,9% до 48,1%, а на GSM8K — с 13,8% до 67,1%. Также модель с нуля создала веса для игр MinAtar, которые оказались эффективнее сетей после 100 миллионов шагов обучения с подкреплением. Подобный подход превращает нейросети в полноценных программистов собственного «мозга», что делает процесс оптимизации ИИ мгновенным. Теперь для исправления ошибок в модели больше не требуются огромные вычислительные мощности и недели дообучения. Эпоха ручного подбора гиперпараметров и бесконечного градиентного спуска стремительно уходит в прошлое. Что это значит на практике? Сейчас гораздо более тяжелые модели, чем описанная в эксперименте, например Qwen2.5 7B Instruct 1M, которая запущена сейчас на моём макбуке с 24 Гб памяти, - это вполне себе такой профессиональный бредогенератор. Делать что-то серьёзное или даже не очень серьёзное на такой модели с 7 млрд параметров - пустая трата времени. А представленная в тесте модель на 0.8В - это то, что даже в режиме калькулятора не сможет умножить два шестизначных числа без ошибок. Но после тонкой настройки, ей показатели удалось поднять в 5-7 раз. Это говорит о том, что скоро начальные модели, запускаемые локально на смартфоне, смогут стать серьёзным инструментом. А уже если у вас старая карта 3090, не спешите её выбрасывать, она скоро сможет стать вообще суперкомпьютером.