
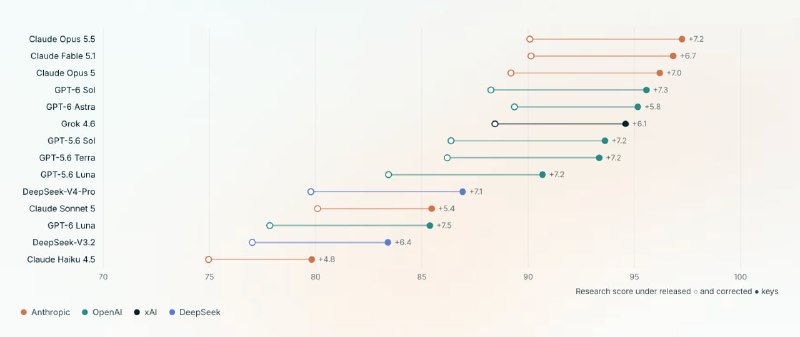
AI отлично анализирует стартапы, но совершенно не умеет выбирать будущих победителей Мы в Mento VC уже давно строим собственную AI-инфраструктуру для поиска и анализа стартапов. И недавно решили проверить, насколько вообще можно доверять современным AI-моделям в задачах венчура. В итоге сделали и публично выпустили собственный бенчмарк — Startup Agent Benchmark (SAB). Мы протестировали 14 моделей от OpenAI, Anthropic, Google и других провайдеров на 960 аналитических задачах и 101 задаче по ранжированию стартапов. Использовали в том числе нашу реальную базу из 8,000 компаний. Несколько интересных выводов: 1. Claude Opus 5.5 — лучший аналитик. Набрал 97.2 балла из 100, хотя разница с ближайшим конкурентом статистически незначима. 2. Все модели галлюцинируют. Даже лучшие в 9-10% случаев придумывали ответы на вопросы, информации для которых не было в предоставленных документах. 3. Разница в стоимости — больше 100 раз. Одна аналитическая задача может стоить от $0.003 до $0.36 в зависимости от модели. При этом дороже далеко не всегда значит лучше. Самое интересное: все 13 моделей проиграли простейшей эвристике в прогнозировании роста стартапов. Обычная сортировка компаний по историческому росту сотрудников оказалась эффективнее AI-прогнозов на горизонте 90-180 дней. Получается любопытная ситуация. AI уже отлично справляется с аналитической работой венчурного фонда (быстро и дешево). Но когда дело доходит до прогнозирования будущего роста компаний, все гораздо сложнее. Для нас это еще одно подтверждение стратегии: максимально автоматизировать поиск и анализ стартапов, но инвестиционные решения пока оставлять на себе. В общем, получилось интересное исследование с интерактивными графиками, рейтингами моделей и подробной методологией. Если работаете с AI-агентами, занимаетесь венчуром или просто интересно, насколько хорошо современные LLM справляются с реальными бизнес-задачами, рекомендую посмотреть — https://mento.vc/sab-bench Лучшие посты | Mento VC Fund II | Стать инвестором