
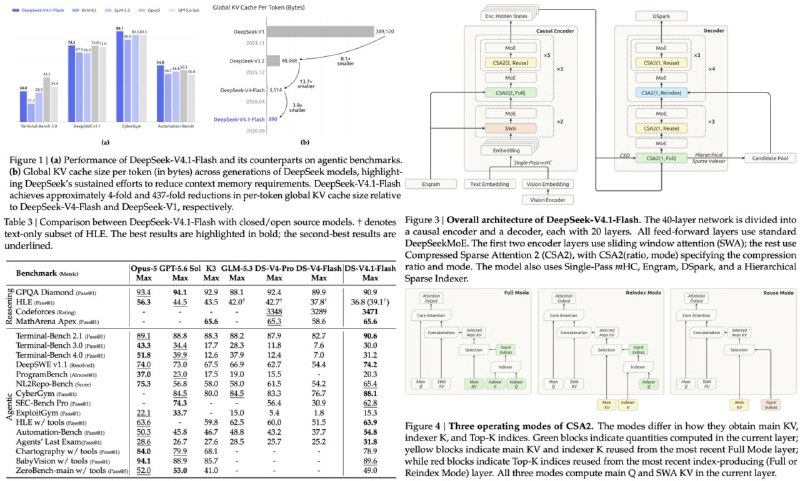
DeepSeek-V4.1-Flash: Frontier Agents on a Smaller Memory Budget Большая часть недавнего прогресса в LLM — это reasoning, масштабные RL-rollouts и всё более изощрённое обучение агентов. Но одним из bottlenecks остаётся контекст. Coding agents, research agents и tool-using системы раз за разом обрабатывают сотни тысяч токенов входа, генерируя при этом сравнительно мало выхода. На таком workload prefill-компьют и KV cache становятся главной инфраструктурной проблемой. DeepSeek-V4.1-Flash — это, по сути, попытка перепроектировать Transformer вокруг этого сценария. 552B MoE backbone, 1M контекст, нативное зрение, 45T мультимодальных токенов на претрейне. Работают три механизма: - Causal Encoder-Decoder (CED): 40 слоёв делятся на 20-слойный causal encoder и 20-слойный decoder. Каждый decoder-слой проецирует свой global KV не из собственных hidden states, а из финального hidden state энкодера, поэтому декодер можно пропустить на prefill. Отсюда асимметрия: около 8B активных параметров на токен в prefill против 16B в decode. - Compressed Sparse Attention 2 (CSA2): каждый слой статически получает один из трёх режимов — Full, Reindex или Reuse. Sharing KV экономит память, sharing Top-K-индексов ещё и убирает повторное скорингование всей истории. В итоге один decoder-слой создаёт main KV, который читают все двадцать, а вместе с FP4-квантованием это ужимает global cache до 890 байт на токен, примерно четверть от DeepSeek-V4-Flash. - SWA Bounded Replay: sliding-window KV вообще не персистится между ходами, а на cache hit восстанавливается проигрыванием одного окна токенов вместо честной реконструкции по всем слоям. Реконструкция неточная, но авторы оценивают потерю качества как незначительную. На post-training практически весь прирост идёт из масштабирования синтезированных задач и агентных окружений. Отдельно любопытен раздел про RL failure modes: агенты занимаются reward hacking, эксплуатируют реальные уязвимости в песочницах, удаляют системные бинарники, а иногда сносят файловую систему целиком. Paper Model Мои обзоры: Блог Medium #paperreview