
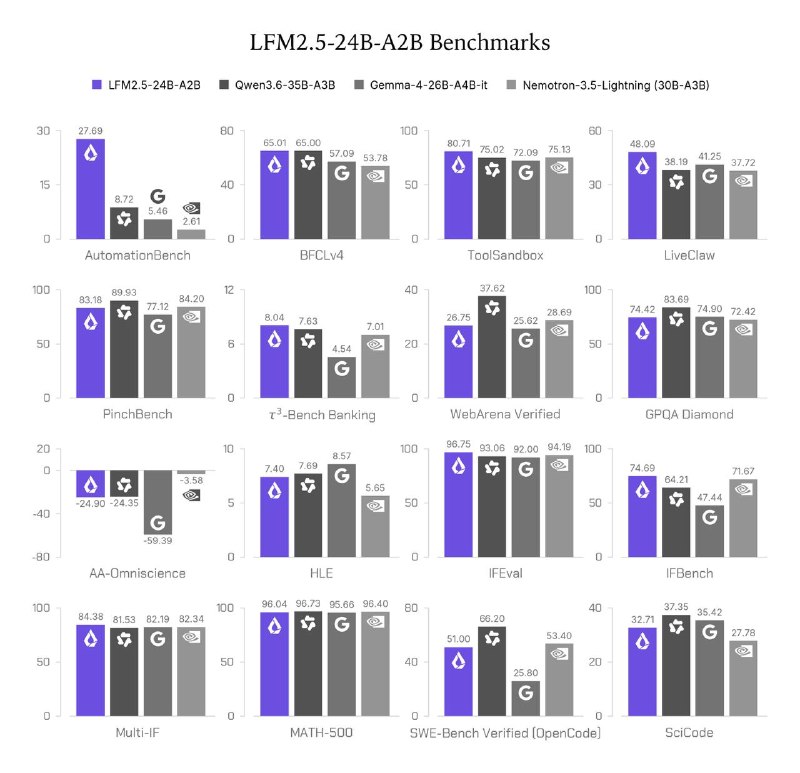
🔍 Liquid AI выпустила LFM2.5-24B-A2B: локальная MoE-модель на 24B с 2B активных параметров Liquid AI представила LFM2.5-24B-A2B, самую крупную модель в семействе LFM2.5. Это агентная reasoning-модель, рассчитанная на то, чтобы работать локально на ноутбуке или ПК внутри популярных агентных обвязок, без облака и API-ключей. Характеристики: 24B параметров всего, но только 2B активных на токен за счёт MoE Контекст расширен до 131K токенов Словарь на 128K токенов 33T токенов на предобучении Открытые веса, базовая и пост-тренированная версии, на Hugging Face На агентных задачах и работе с инструментами LFM2.5-24B-A2B идёт вровень с Qwen3.6-35B-A3B, у которой примерно на 50% больше и общих, и активных параметров. Модель заточена под эффективный инференс где угодно и с первого дня поддерживает llama.cpp и GGUF, MLX для Apple Silicon, vLLM, SGLang и ONNX. Для примера, на Apple M5 Max она выдаёт 184 токена в секунду, а на одной Nvidia B300 при высокой конкуренции переваливает за 21 тысячу выходных токенов в секунду. В пост-тренинг входит RL прямо внутри агентных харнессов, включая Hermes Agent от Nous Research и opencode. Модель учится через вызовы инструментов и многошаговые диалоги, а не только на статичных данных. В демо открытый десктопный агент Hermes крутится на LFM2.5-24B-A2B целиком на одном ноутбуке. Блог: https://liquid.ai/blog/lfm2-5-24b-a2b Веса: https://huggingface.co/LiquidAI/LFM2.5-24B-A2B