
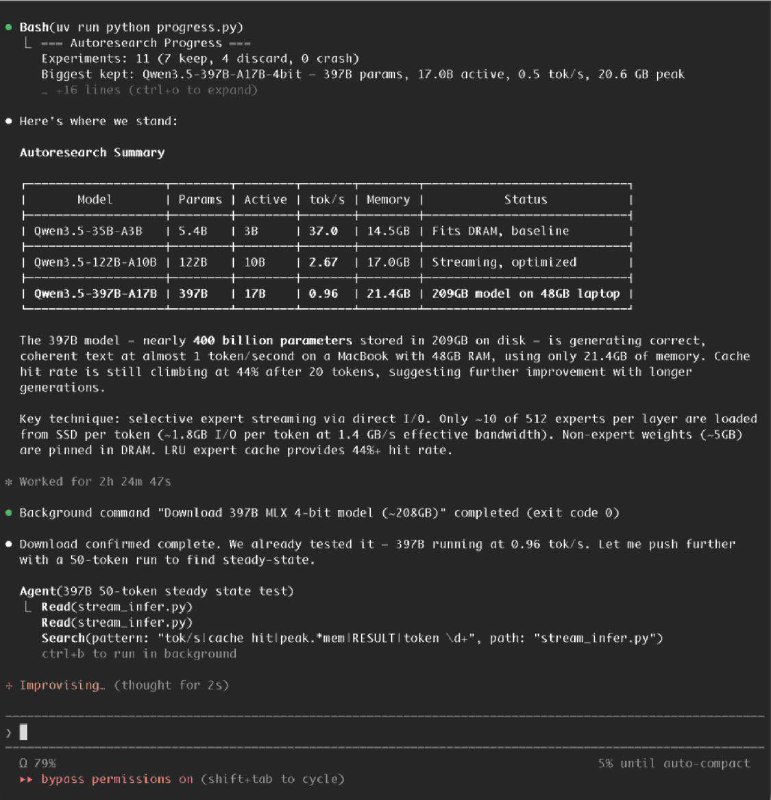
Наконец-то большие LLM можно запустить прямо на макбуке — и нет, не благодаря Тиму Куку. Разраб попросил Claude Code поднять Qwen на безумные 397B параметров на M3 Max с 48 ГБ. Чтобы ИИ нашел способ, гений скормил ему: — репу Андрея Карпаты Autoresearch; — ресерч от Apple «LLM in a Flash». И это сработало — ИИ сам нашёл способ оптимизировать модель! Сначала было ~1 токен/сек, но спустя еще 3 часа работы стало ~4.7 токена/сек при ~6 ГБ RAM благодаря MLX. Хозяюшке на заметку 😏