Исследования AI глазами исследователя
Автор: @snk4tr Сергей Кастрюлин
Subscribers1.3K tracking since 17 Oct
Reach per post (ERR)50.0%650 avg views
Posting0.2/weeklast 12 days ago
Reactions per 1K views130.8❤ ❤🔥 👍
ToolOrchestra: Elevating Intelligence via Efficient Model and Tool Orchestration
[код, веса]
Исследователи из NVIDIA и Университета Гонконга (HKU) поднимают проблему агентного оркестрирования. Современные мультимодальные агенты (например, в Humanity's Last Exam) строятся по принципу монолита: одна огромная LLM (как GPT-4o или Claude) пытается решить задачу самостоятельно, периодически дергая базовые тулы вроде поиска или интерпретатора кода.
Авторы говорят: это не эффективно и дорого. Намного лучше работает другой подход — небольшая (8B) модель-оркестратор, которая управляет целым парком инструментов. В этот набор инструментов входят не только калькуляторы и поиск, но и другие специализированные и общие LLM (от Qwen-Coder до GPT-5).
То есть, маленькая LLM решает, когда задачу можно решить дешевым локальным поиском, а когда нужно позвать GPT-5 или специализированную математическую модель.
Метод
Авторы обучают модель Orchestrator-8B (на базе Qwen3-8B) с помощью метода ToolOrchestra в парадигме Perception-Reasoning-Action.
При этом, если просто взять готовую LLM и попросить её выбрать нужную модель-инструмент (через промпт), она ведет себя предвзято:
➡️Self-enhancement bias: Qwen будет вызывать другие модели Qwen.
➡️Other-enhancement bias: GPT-5 будет в 98% случаев вызывать GPT-5-mini или себя же, игнорируя стоимость и наличие других, не менее подходящих моделей.
Чтобы научить 8B-модель быть хорошим менеджером, её обучают с помощью GRPO. Reward строится не просто на правильности ответа, а как взвешенная сумма трех компонентов:
➡️Outcome: решена ли задача в итоге (судит GPT-5).
➡️Эффективность: штрафы за стоимость вызванных моделей (по реальным API-ценам) и за задержку (latency).
➡️Пользовательские предпочтения: вектор предпочтений, описывающий, насколько пользователю критична цена, приватность (локальный поиск vs web) или скорость.
Для обучения авторы собрали синтетический датасет ToolScale. Пайплайн его создания включает симуляцию баз данных, генерацию API и синтез сложных многошаговых задач с эталонными траекториями решений, валидированными LLM.
Результаты
На Humanity's Last Exam Orchestrator-8B обходит GPT-5 с тулами и огромную Qwen3-235B. На бенчмарке FRAMES (поиск и рассуждения по Wikipedia) выдает 76.3%.
По эффективности (τ-Bench) тоже лучше. Агент успешно решает сложные задачи, используя GPT-5 только в 40% шагов для самых трудных подзадач, а для остального обходясь дешевыми моделями. В итоге стоимость и задержка снижаются в 3 раза по сравнению с использованием только GPT-5.
Модель тестировали на невиданных при обучении тулах (например, Claude Opus 4.1 или новые модели Qwen). Orchestrator-8B успешно адаптировался: читая описания новых моделей, он корректно встраивал их в процесс, снова показывая лучшее соотношение цена/качество.
Отдельно проверили, как модель слушается юзера. Если пользователь пишет "Я хочу избежать API-колов и ограничиться локальным поиском/хостингом", Orchestrator-8B перестраивает логику и почти не обращается к GPT-5 или веб-поиску, справляясь силами локальных моделей.
Вместо вывода
Работа предлагает прагматичный взгляд на развитие AI-агентов. Вместо бесконечного раздувания размеров монолитных моделей, будущее может лежать в разделении труда: легкий, дешевый, но очень умный в менеджменте координатор управляет зоопарком специализированных экспертов.
End-to-End Training for Unified Tokenization and Latent Denoising
[код и веса]
Современные LDM почти всегда двухступенчатые: сначала отдельно учат токенизатор (автоэнкодер), потом замораживают его и сверху учат генератор в зафиксированном латентном пространстве. Это удобно инженерно, но генеративная часть никак не влияет на то, каким получается латентный код и приходится подстраивать генератор под чужое пространство признаков.
UNITE предлагает рассматривать токенизацию и генерацию как одну и ту же задачу вычисления латентов, просто в разных режимах: в одном случае модель видит исходное изображение почти целиком и должна выдать его компактное представление, в другом — стартует с шума и слабых подсказок и должна прийти к тому же типу представления. Важный шаг — один и тот же энкодер используется и как токенизатор, и как генератор в латентном пространстве, а обучающие сигналы от задачи реконструкции и от задачи генерации совместно формуют одно общее пространство признаков.
За счёт этого авторы показывают, что можно обойтись одним обучающим запуском и одной моделью вместо каскада токенизатор + генератор, сохранив почти SOTA качество как по реконструкции, так и по генерации. Анализ промежуточных представлений показывает, что даже без внешних учителей токенизация и генерация естественно выравниваются: внутренние слои модели переиспользуются обеими задачами, а не расходятся в две несвязанные подсистемы.
Интересно, что совместное обучение ведёт себя немного адверсариально: критерии реконструкции и генерации местами конфликтуют, но именно этот конфликт заставляет модель искать латентное пространство, которое одновременно и достаточно информативно для восстановления деталей, и достаточно устойчиво, чтобы по нему было удобно генерировать.
В итоге UNITE показывает, что можно тренировать end-to-end LDM с нуля, не разбивая на два этапа и не привлекая DINO-учителей. Это открывает путь к обучению генеративок в узкоспециализированных областях (робототехника, биология), где нет готовых VAE.
Unified Multimodal Understanding and Generation Models: Advances, Challenges, and Opportunities
Этот обзор — пожалуй, наиболее полный на сегодняшний день источник знаний по мультимодальным генеративкам. В последней, январской ревизии собрали, систематизировали и проанализировали всё то что было сделано в области за последние полтора года.
В обзоре обсуждаются вопросы архитектур, данных и бенчмарков. На основании анализа подсвечиваются проблемы и перспективные направления развития области. Главный вывод — область бурно развивается и у исследователей все еще нет единого мнения о том как строить универсальные генеративки.
Всем интересующимся темой, а также желающим разобраться рекомендуется к ознакомлению.
Beyond Language Modeling: An Exploration of Multimodal Pretraining
[ни кода, ни весов нет]
Команда из FAIR и NYU (LeCun team 👦) представила масштабное эмпирическое исследование по обучению нативных унифицированных мультимодальных моделей (UMM) с нуля. В скоуп работы попадают и VLM и мультимодальные генеративки.
Большинство текущих подходов берут уже готовую LLM и пытаются прикрутить к ней зрение. Авторы же решили ответить на фундаментальный вопрос: как разные архитектурные и датасетные решения влияют на модель, если учить язык и зрение с нуля и одновременно?
В работе используют фреймворк Transfusion (разбор): один трансформер, где для текста считается next-token prediction, а для картинки/видео — Flow Matching.
Визуальные представления
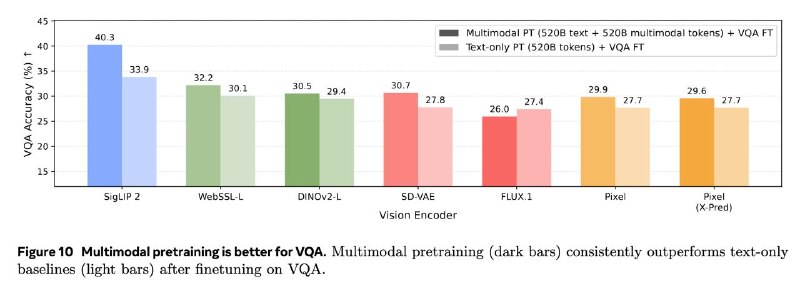
Авторы сравнили спектр энкодеров: VAE (SD-VAE, FLUX.1), семантические (SigLIP 2, DINOv2, WebSSL) и "сырые" пиксели.
RAE (Representation Autoencoders) — победитель. Использование эмбеддингов SigLIP 2 вместо VAE-латентов (как это делается в большинстве UMM) дает лучшие результаты и в понимании (VQA), и в генерации (GenEval, DPGBench). VAE хорош для восстановления пикселей, но теряет семантику, важную для понимания. RAE-подход позволяет использовать один высокоразмерный энкодер для обеих задач, существенно упрощая архитектуру по сравнению с dual-encoder системами как в Janus или BAGEL.
Данные: конкурируют ли модальности?
Главный страх мультимодального претрейна: зрение испортит язык. Второй страх: не испортит, но и не поможет. Что выяснили:
1️⃣ Обучение на сыром видео (без текста) параллельно с текстом улучшает (или не ухудшает) языковую перплексию по сравнению с чисто текстовым бейзлайном.
2️⃣ Деградация языка возникает только при добавлении image-text (I/T) пар (например, MetaCLIP). Авторы доказали, что это не из-за зрения, а из-за сдвига распределения текста - кэпшены сильно отличаются от веб-текста.
3️⃣ Добавление текста к фиксированному бюджету визуальных токенов улучшает качество генерации картинок.
Наблюдения
Способность к world modeling эмерджентна. Добавление общего видео-корпуса к всего 1% in-domain (50B токенов) дает результаты, сравнимые с обучением на 100B токенах только in-domain данных. Более того, модель способна воспринимать free-form текст как управляющие action'ы в zero-shot режиме (например, "get out of the shadow", "take big steps forward").
Архитектура и масштабирование
Вместо стандартного shared Transformer авторы исследовали разделение capacity.
➡️Modality-Specific FFNs: Простое создание двух независимых FFN (для текста и для vision) внутри каждого слоя, при сохранении shared Attention, уже снижает конкуренцию модальностей.
➡️MoE — самая эффективная архитектура. Также интересно, что модель выделяет больше экспертов под текст. При этом для генерации (T2I) и понимания картинки (I2T) активируются одни и те же "визуальные" эксперты.
➡️Scaling Asymmetry (Chinchilla IsoFLOPs): Для плотных (dense) моделей масштабные законы асимметричны. Текст требует сбалансированного роста, а зрение в разы прожорливее к данным. Из-за этой асимметрии невозможно подобрать идеальный оптимальный бюджет для обеих модальностей сразу. Введение MoE сглаживает этот разрыв.
Вывод
Штраф за мультимодальность — это миф дизайна, а не фундаментальное свойство. Используя одно мощное семантическое представление (RAE), независимые или MoE FFN-блоки и правильный микс данных, можно обучить нативную UMM с нуля. Такая модель не только не теряет в языковых навыках, но и естественным образом перенимает свойства World Models для zero-shot планирования навигации в пространстве.
InternVL-U: Democratizing Unified Multimodal Models for Understanding, Reasoning, Generation and Editing
[код и веса]
Возвращаемся к теме мультимодальных генеративных моделей. На очереди противоположность HunyuanImage 3.0 (разбор) — самой большой модели в классе на сегодня. Авторы из Shanghai AI Lab, прародители InternVL (сторожилы помнят какой была царь-VLM до квенов 👴) дообучили FM голову на генерацию/редактирование и представляют свою новую, компактную генеративку всего текстового и визуального.
InternVL-U имеет < 4B параметров (2B VLM backbone + 1.7B generation head). Сравнительно неплохое качество достигнуто за счет огромных усилий по построению пайплайнов сбора разного рода данных. По архитектуре буквально ничего нового, поэтому далее разберем данные, обучение и бенчмаркинг.
Данные
Чтобы модель не просто рисовала красивые картинки, но и была "умной", авторы создали пайплайн синтеза данных, фокусируясь на сложных доменах:
• Reasoning-Centric Synthesis: вместо того чтобы учить модель на парах короткий промпт -> картинка, авторы используют Qwen и GPT-4o чтобы развернуть абстрактный запрос пользователя в пошаговый план (подумать, какие элементы нужны, как их расположить, какой стиль выбрать), и только потом генерировать изображение. Это учит модель рассуждать перед рисованием.
• Text Rendering: специальный пайплайн для text-centric задач — рендеринг текста на фонах и внутри изображений с использованием OCR и layout-aware генерации.
❗️ На этом пункте хочется остановиться отдельно. Во-первых, авторы показывают силу простых пайплайнов рендеринга текста на картинке (T2I) и перерисовывания через Flux-text (I2I). Они позволяют получать данные, качества которых достаточно для обучения моделей, рисующих текст на доске/стекле и т.п. Во-вторых, занятно, что, получив такие данные, даже маленький денойзер (1.7В) вполне способен выучить сложные паттерны генерации/редактирования текста на картинке.
Другие необычне данные, для которых сделали пайплайны:
• Humor & Memes — как будто просто убирают/добавляют текст на мемные картинки в нужное место
• Spatial Rotation — берут несколько кадров во время вращения 3D объектов
• Multi-view CAD — то же самое, только в CAD
• Science — данные для физики, химии (формулы, молекулы) и геометрии с использованием программных инструментов (GeoGebra, SVG, Matplotlib).
Обучение
Учат в три стадии:
1. Head Pre-training: VLM заморожена. Обучается только MMDiT-голова и проекторы на задачах генерации и редактирования (512px).
2. Any-Resolution Continued Pre-training: обучение на произвольных разрешениях (до 1024px) и соотношениях сторон. Для редактирования добавляется явная инъекция VAE-латентов исходного изображения для попиксельной точности.
3. SFT: размораживают всю модель (включая VLM). Обучение идет e2e на смеси данных, включая CoT-данные.
Результаты
• Overall (T2I): InternVL-U (4B) бьет BAGEL (14B) и приближается к Qwen-Image (20B) на GenEval и DPG-Bench.
• Text Rendering (T2I): очень сильные результаты в генерации текста (LongText-Bench, CVTG-2k), особенно на китайском и английском языках, превосходя многие специализированные модели.
• Understanding (I2T): благодаря заморозке VLM на первых этапах и decoupling-стратегии, модель не теряет SOTA-способностей к пониманию (высокие баллы на MME, MMMU).
• Editing (I2I): модель хороша на TextEdit.
Вывод
InternVL-U доказывает, что архитектуру с диффузионной головой можно дотянуть до хороших результатов данными даже при компактных размерах.
edited
One Model, Many Budgets: Elastic Latent Interfaces for Diffusion Transformers
[код есть]
В генерации изображений обычно платишь за пиксели: больше разрешение - больше токенов - больше FLOPS. Сами DiT обрабатывают все токены одинаково, будь то детальная текстура шерсти или просто белый фон. Это неэффективно. Авторы из Rice University и Snap представляют ELIT (Elastic Latent Interface Transformer) — метод, который отвязывает вычислительный бюджет от разрешения картинки и позволяет управлять соотношением качество/скорость.
Идея и метод: Latent Interface
Вместо того чтобы прогонять все пространственные токены через стек DiT блоков, ELIT вводит промежуточный Latent Interface — набор латентных токенов (количество которых K можно менять).
Архитектура
• Short Spatial Head: несколько начальных слоев DiT обрабатывают исходные патчи (spatial tokens).
• Read Layer: слой cross-attention, который засасывает информацию из пространственных токенов в компактный набор латентных токенов (K). Это ключевой момент перераспределения вычислений: attention сам решает, на какие регионы изображения потратить бюджет латентных токенов.
• Latent Core: основной стек трансформерных блоков работает уже в этом сжатом латентном пространстве.
• Write Layer & Tail: обратный cross-attention проецирует обновленные латенты обратно в пространственную сетку для финального декодирования.
Обучение
Чтобы модель работала с любым количеством токенов J <= K, во время обучения случайно выбирается J, и все токены после J-го отбрасываются. Это заставляет модель упорядочивать информацию по важности: первые токены несут глобальную структуру, последующие — детали.На инференсе можно просто выбрать желаемое число J латентных токенов. Хотите быстро? Возьмите мало токенов. Хотите качественно? Возьмите все.
Результаты
ELIT превосходит стандартные DiT, U-ViT и HDiT по соотношению FLOPS/Quality. На ImageNet-512 модель ELIT-DiT-XL улучшает FID на 53% по сравнению с DiT-XL при том же бюджете обучения. Одни и те же веса работают в широком спектре бюджетов инференса. Это дает лучший trade-off, чем просто уменьшение числа шагов сэмплинга.
Поскольку модель может работать в слабом режиме (мало токенов), это открывает возможность для дешевого guidance. Вместо того чтобы прогонять полноценную unconditional модель, можно прогнать ту же модель, но с урезанным числом токенов (скажем, 25%). Это дает эффект Autoguidance, ускоряя генерацию на ~33% и улучшая качество.
Применение к Qwen-Image: Авторы масштабировали метод на 20B MM-DiT (Qwen-Image) и показали, что ELIT позволяет ускорить его в 2.7 раза с минимальной потерей качества, просто урезая число токенов.