Друзья, познакомлю вас со своей замечательной сестрой - Кариной. Она у нас профессиональная актриса и певица - играет главные роли в спектаклях и дает концерты. А еще она занимается подготовкой к публичным выступлениям таких, как мы с вами - программистов, лидов и стартаперов. Я лично привел к ней нескольких своих друзей и они в полном восторге от занятий (уверенность в себе подросла, выступления проходят совсем на другом уровне, работа стала еще успешнее и вот это вот все ). В общем, с чистой совестью пиарю Карину в своем канале и горячо ее рекомендую всем, кто хотел прокачать голос и скилл публичных выступлений. По поводу занятий пишите ей в личку: см. комментарий к посту. Еще, Карина только что запустила свой tg-канал про публичные выступления, так что если тема для вас актуальна или может стать актуальной в будущем, то подписывайтесь смело: @golosmost

AI-Driven Development. Родион Мостовой
Увлекательно рассказываю о моем опыте применения AI в разработке и построении продуктов с LLM под капотом. Связь: @rodion_m_tg Чат: @ai_driven_chat
-
-
edited Забрали Фейбл? Вы расстроились? Я расстроился. Мне очень понравилась новая модель и я уже даже начал планировать пост в с юзкейсами в канал. А ключевые юзкейсы там если кратко - это задачи, с которыми модели предыдущего поколения все еще справляются плохо: продумывание нестандартной архитектуры, поиск запутанных и очень сложных багов, помощь с генерацией действительно качественного контента. Словом, кажется, что у этой модели появился тот самый мифический judgement ("суждение"), о котором писали в Sequoia. Это то, что часто называют вкусом или насмотренностю и то, что предлагалось не делегировать LLMкам. Так вот, все-таки у большинства вайб-кодеров и agentic engineers такие задачки возникают не часто, поэтому подход с usage-based для этой модели меня лично не сильно огорчил - результат бы точно стоил своих денег, с учетом точечного использования. Так забрали или нет? Сейчас обсуждают и переживают о том, что антропики теперь будут проверять паспорт у пользователей и давать доступ только гражданам США. Только вот "проблема" в том, что и это не ограничит людей без американского паспорта от использования Фейбл+ моделей. Цены по API на перепродажу таких моделей просто скакнут немного. Короче, кому надо доступ-то все равно получат. А простым вайб кодеры вроде нас с вами жизнь подусложнят. Так вот, антропики в любом случае обещали доступ к Фейбл после 22-го июня перевести на usage-based - т. е., фактически, на оплату за токены. А когда доступ откроют гражданам США, то довольно быстро и у остальных появится возможность использовать эту замечательную модель, только с оплатой за токены (ага, считайте все тот же usage-based). Раньше санкции на USA-LLM обходили только из подсанкционных стран, теперь (если так пойдет) штаты вынудят на обход и все остальные страны. А вообще, идея ограничивать что-то по национальному или расовому признаку мне крайне неблизка, да и делать так по-моему не очень умно. И, конечно, трудно придумать более мощный PR для Антропик, чем подобные события. @ai_driven | AI-Driven Development: Родион Мостовой.
-
edited Бенчмарки! Новый митап про DeepSWE, SWE-rebench v2 и др Друзья, вы все еще верите бенчмаркам? Я вот все меньше. Наверняка уже все видели DeepSWE бенчмарк - пожалуй, наиболее противоречивый бенчмарк за последнее время, причем с полярными мнениями: для одних это единственный объективный бенчмарк, для других он абсолютно не имеет отношения к реальности. В общем, я подумал, что будет интересно разобраться глубже в современных бенчмарках - обсудить их достоинства и недостатки, чтобы понимать есть ли вообще смысл обращать внимание на SWE бенчмарки в 2026-м. Отдельно разберем обновленный SWE-rebench v2. На митап мы позвали, вероятно, наиболее подкованного человека из русскоязычного пространства - Ибрагима Бадертдинова, он один из ключевых авторов бенчмарка SWE-rebench, который как раз недавно обновили. А еще, Ибрагим автор канала @c0mmit. А неудобные вопросы будет задавать горячо любимый друг нашего канала Максим Этихлид (@etechlead). Будем обсуждать важность harness, утечки, бенчхакинг, важность флоу проекта (AGENTS.md, верификации и т. д.) и, конечно, методологии. Дата и время: 9 июня 14:00 по МСК, 16:00 по Алматы, 13:00 CET, 12:00 по Лондону. Ссылка на регистрацию на встречу. Готовьте свои коварные вопросы, ведь будет уникальная возможность задать их Ибрагиму - автору одного из топовых бенчмарков. — Кстати, у нас было интервью с Ибрагимом, в котором мы разбирали подробно бенчмарк SWE-rebench, поэтому рекомендую к просмотру всем AI-энтузиастам и в качестве подготовки к нашему новому стриму: https://youtu.be/a5jf-kyV12Y @ai_driven | AI-Driven Development: Родион Мостовой.
-
edited 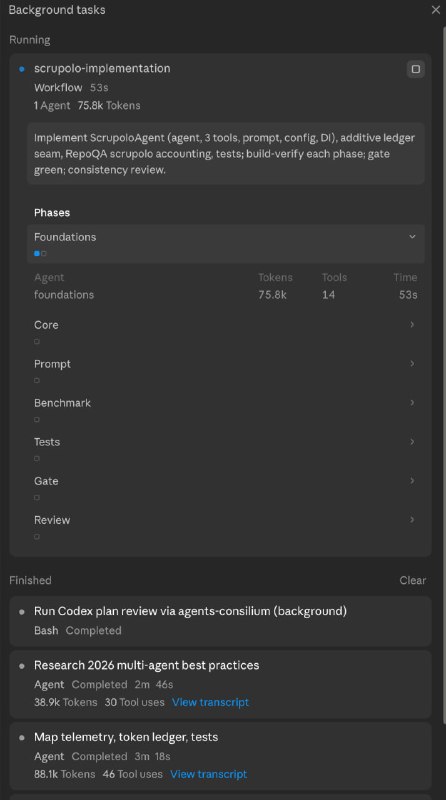
[2/2] Пример промпта для кодинг агента на Июнь 2026 Давай добавим нового агента для супер глубокого и скрупулезного исследования контекста и назовем его `ScrupoloAgent`. У него будет 3 tools: get_ontology, read_file (с обязательным указание диапазона строк при чтении для экономии контекста), ask (вызывает @ContextResearchAgent.cs ). См. @agent-development.md. Идея в том, что этот Scrupulo - фактически техлид-менеджер, который может итеративно задавать любые вопросы к ContextResearchAgent, относящиеся к теме, в тч уточняющие, чтобы предельно глубоко разобраться в теме. У нас уже есть отличный промпт deep режима для этих целей в @codealive-app/src/agents/CodeAlive.Agents/Prompts/codebase/context-research-agent-prompt.liquid , возьми deep промпт в основу для Scrupolo Agent. Scrupolo может вызывать ContextResearchAgent в параллель. Важно, что Scrupolo должен сделать минимум 3 вызова ContextResearchAgent прежде, чем отвечать на вопрос, а финальным шагом Scrupolo должен разрешить все противоречия и неоднозначности через верификацию через четение файлов и дополнительные вызовы ask если нужно; а если какие-то из противоречий достоверно разрешить не удается, то Scrupolo в своем ответе в таких места должен так явно и указать, что "участок/утверждение противоречивое и достоверно разрешить противоречие не удалось". Главным агентом (Scrupulo) пусть будет qwen3.5-397b-a17b max, а для ContextResearchAgent используй qwen3.6-35b-a3b max (в deep режиме). Нужно сначала покрыть этого агента минимальными тестами в CodeAlive.Agents. Затем когда все будет готово прогнать этого агента через бенчмарка RepoQA - при этом важно четко фиксировать токены главного - то, как нужно расширить трейсинг и бенчмарк для грамотного учета токенов, цен и тулов главного агента и субагенов продумай через отдельного субагента на opus max. Таблицу Runs в бенчмарке тоже нужно будет обновить соответствующим образом. В самом конце - запусти opus max субагента провести глубокое ревью, а также убедись, что все консистентно. В основной флоу CodeAlive Scrupolo пока интегрировать не нужно - сейчас нужна только качественная реализация, верификация через тесты и прогон через RepoQA (agent-framework). Начни с глубокого исследования контекста CodeAlive через субагентов + в параллель через /codealive-context-engine на основе кода и примеров выясни как в agent-framework эффективно делать мульти-агентную систему с учетом лучших практик, fault tolerance и тд, можешь даже еще одного агента в интернет отправить изучать актуальный контекст лучших практик по мультиагентным системам в 2026-м. Как только будет готов план, сохрани его в @specs и проведи ревью через Codex GPT 5.5 xhigh и улучши план, затем приступай к реализации. Делай системно, не срезая углов. Если после исследования ко мне останутся вопросы - задавай. Если внимательно вчитаться, немало интересных фишек можно почерпнуть. Ах да, конкретно эту задачу запускаю через Opus 4.8 ultracode. Но в GPT 5.5 high в такой формулировке должно работать не хуже. Ну и примечательно, что еще пол года назад подобный промпт практически не имел бы никакого смысла, в виду своей сложности и отсутствия поддержки субагентов. PS. Кстати, как вам название для нового агента? :) — @ai_driven - AI-Driven Development. Родион Мостовой
-
edited [1/2] Пример промпта для кодинг агента на Июнь 2026 Для контекста Мы доделали новый бенчмарк QA по кодовой базе для CodeAlive, и в нем у нашего context research агента получились на удивление достойные результаты, в которых qwen3.6-35b-a3b сопоставима с Opus 4.8 по точности и полноте ответов по цене в ~30 раз дешевле - все-таки хорошо приготовленный RAG с векторным поиском + узкий агент с правильными тулами дает потрясающие результаты. Интересно, что в определенный момент мы и не думали тягаться по качеству с топовыми агентами, а скорее выбрали стратегию усиления Claude Code, Codex, Cursor и других агентов контекстом через обогащение их контекста по MCP или через скиллы. Теперь же, когда оказалось, что узко-специализированный harness на on-prem моделях, заточенный строго под исследование контекста может тягаться с топовыми агентами и моделями, наши амбиции преумноежелись и мы подумали, почему бы нам на основе нашего агента не реализовать мультиагентную систему, которая будет итеративно вызывать CodeAlive-субагентов до тех пор, пока точно не докопается до истины? Наш бенчмарк показывает, что такая система будет работать точнее, чем популярные кодагенты, собирая действительно полную картину (что особенно важно в крупных enterprise системах), а еще и делать это сильно дешевле. Ведь с точки зрения ROI (а компании обычно именно так измеряют пользу), это означает, что CodeAlive позволит им выполнять ряд задач на небольших моделях по цене в десятки раз дешевле (или даже практически бесплатно на локальных моделях), вообще не теряя в качестве, а где-то даже приобретая. Сказано - сделано, агенты уже трудятся. Собственно, промпт на эту задачу получился на столько примечательным, что я решил им поделиться с вами. Поясню на всякий случай, что в данном случае кодагент разрабатывает другого агента на основе .NET фреймворка agent-framework. Продолжение.
-

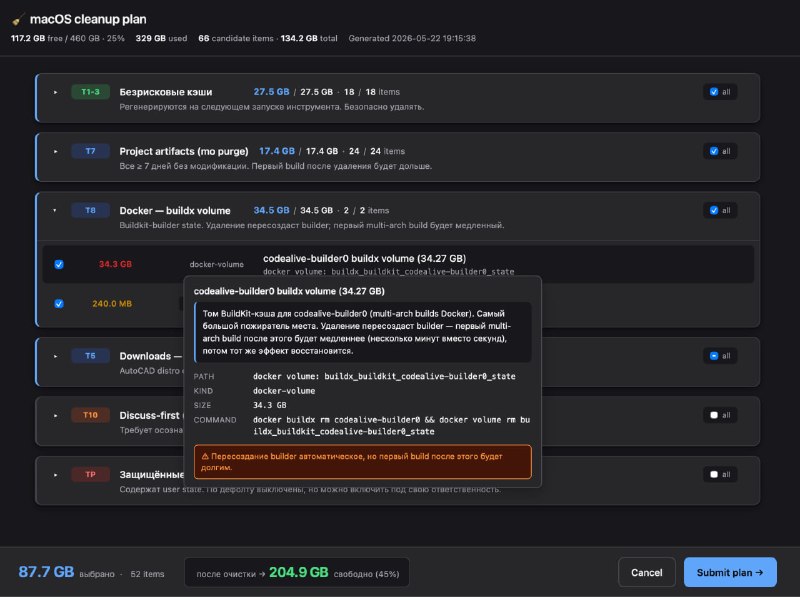

OS Deep Cleaner + Health Checker: новый кейс с кодагентами С чего бы это в канале про AI кодинг я рассказываю об очистке мака и поддержании его в здоровом состоянии? Да все дело в том, что ваш покорный слуга в последнее время весьма активно начал работать в 4-5 параллельных сессий (почти как Борис Черный), а также еще и использовать субагентов. С чем я столкнулся работая в таком режиме? (помимо ментального перегруза) - да банально с тем, что ПК стал перегружаться - ЦП на 100%+, RAM в минусе и т.д., а в некоторые моменты мак и попросту аварийно вырубался с фатальной ошибкой. Так вот, после очередного такого фейла всей системы после перезагрузки я отправил Opus разбираться в реальных причинах такого падения и в том и как его избежать в дальнейшем. Здесь важно отметить, что перед запуском расследования я попросил клода провести исследование в интернете о том, как бы профессиональный инженер из Apple проводил такое расследование - выяснить его подходы и методологию. Исследование выявило несколько проблем, но ключевая в нехватке места на диске для файла подкачки. И вот тут начинается самое интересное. Ранее для периодической чистки диска я использовал Mole - у него несколько режимов работы, но основной просто сканирует кеши инструментов разработки (npm, brew, cargo, gradle, pip и прочее), плюс чистит системные логи и temp-файлы старше недели - это команда mo clean. И есть ещё mo purge, который сканирует уже поумнее - находит dev-проекты по маркер-файлам (package.json, Cargo.toml, *.csproj и т. д.) и предлагает снести node_modules, target, bin/obj и прочее регенерируемое. И изначально я завернул эти команды в скилл, которым периодически проходился по системе. Но в реальности этого, конечно, мало - в системе в самых неожиданных местах появляются папки на десятки гигабайт, которые тихонько лежат на диске до тех, пока кто-нибудь не начнет искать большие файлы/папки каким-нибудь сканом. Почему бы такой скан тоже не завернуть в скилл? А почему бы еще не научить скилл определять разные другие пути в которых может лежать мусор? И вообще, пусть скилл себя ведет как опытный сисадмин - предлагая разных стоящих кандидатов к удалению. И зацените еще в какую красивую HTML-ку агент заворачивает отчет для выбора списка на удаление (на скрине) - есессно, списочек итоговый вы сами определяете (с оптимальными дефолтами, ведь UX наше всё). Предупреждаем беду Ок, уже получилось довольно круто. Но что если мы со всеми этими бесконечными сессиями забыли о том, что нам периодически нужно запускать чистку - в этом случае в какой-то момент опять может случиться маковский BSOD. Тогда почему бы нам не добавить проактивный режим - а именно, вотчер, наблюдающий за системой и сообщающий нам о надвигающихся проблемах по тригеру. Сказано - сделано: LaunchAgent раз в 5 минут проверяет: диск меньше 10%, memory pressure Critical вместе со swap больше 8 ГБ, и появление новых JetsamEvent файлов с тегом vm-compressor-space-shortage (это как раз про мой кейс). При триггере - macOS уведомление через alerter. Отмечу, что у скилла есть неплохой список чувствительных мест, которые трогать не стоит, поэтому он достаточно уверенно сам подсвечивает исключения. Вообще, в итоге получилась на удивление идеальная чистилка, которая еще и понятным языком объясняет значения каждого кандидата. Чистилка на голову выше всего софта для очистки, что я видел раньше. Хоть в продукт заворачивай :) У себя я совершенно безобидно вычистил около 150 гбайт. Ссылка на скилл: https://github.com/CodeAlive-AI/ai-driven-development/tree/main/skills/maintaining-macos-health (звезды сюда, если оказалось полезно). P.S. PR с адаптацией под Windows приветствуется. @ai_driven | AI-Driven Development. Родион Мостовой.
-


Май богат на конференции 23-го мая меня можно будет найти на Beetech 2026 в Алматы. Будем говорить на злободневную тему "AI-разработка в enterprise: риск, контроль и доверие". Хороший повод увидеться с моими подписчиками в Алматы :) Скажу честно, не очень люблю формат панельных дискуссий, т. к. в виду жестких ограничений по времени трудно достаточно погрузиться в тему и добраться до действительно ценных инсайтов. Зато у участников будет возможность поймать меня в кулуарах и позадавать мне вопросы там - я обычно очень охотно отвечаю. Кстати, если будете организовывать конфу и захотите меня позвать - формат Q&A с моим индивидуальным участием залетит лучше всего, проверенно :) — Воркшоп "ИИ операционка для руководителя" на AI Camp Almaty В общем, ребята организовали мощный интенсив для руководителей и владельцев бизнесов и попросили меня рассказать и показать как я автоматизирую бизнес рутину в OpenClaw - опенкло сам проводит для меня регулярные ресерчи, смотрит на метрики продукта, выявляя аномалии, подсказывает возможные партнерства и тд. В общем, с помощью агентов будем секьюрно ставить опенкло в облако и настраивать его. Сам интенсив стартует 20 мая, а мой воркшоп пройдет 21 мая. Кстати, наш друг Костя Доронин будет выступать там же с другим воркшопом 20 мая. Хорошая новость - всем, кто зарегистрируется на мероприятиях из моего канала полагается скидка. * Промокод BEEAIDRIVEN25 на Beetech 2026 дает скидку 25% (действует до 21 мая). * Промокод CODEALIVE на AI Camp Almaty дает скидку 15%. @ai_driven | AI-Driven Development. Родион Мостовой.
-
repost 
На протяжении последних 3 месяцев активной работы с Claude Code Терминалом я постоянно дорабатывал свой Status Line И вот, считаю, что он практически идеален Это одна строка внизу терминала, которая показывает всё, что обычно приходится держать в голове или проверять руками. И многое из того, что интерфейсный клод код не показывает Кому полезно Если вы реально работаете в Claude Code, ведёте проекты в Git и хотите меньше думать о техническом состоянии сессии, а больше о самой задаче Из чего состоит ⤵️⤵️⤵️ ✔️ Модель Сразу видно, на чём работаешь: Opus / Sonnet / Haiku, версия и размер контекста. ✔️ Папка и ветка Git Показывает текущий проект и branch. Умеет делать truncate длинных названий проекта ✔️ Состояние репозитория Modified / added / deleted / renamed / untracked / conflicts — всё в одной компактной строке. Конфликты подсвечиваются красным, потому что это единственное, что реально блокирует коммит. Визуализируется через стандартные гитовские сокращения 3M — 3 files modified 1A — 1 added 1D — 1 deleted 1R — 1 renamed 2? — 2 untracked 1! — 1 conflict ✔️ Ahead / behind относительно origin Надо ли пушить или подтянуть изменения ✔️ Drift между CLAUDE.md / AGENTS.md / GEMINI.md Я использую и Claude Code, и CODEX и GEMINI — у них разные главные контекст-файлы. Мой статуслайн показывает, когда они разъехались. Чтобы все имели одинаковый контекст ✔️ Контекстное окно Це база Показывает, сколько контекста уже занято: бар + токены типа 480k/1M. Есть ранние предупреждения, когда сессия начинает подходить к зоне, где Claude скоро захочет compact. ✔️ Prompt cache Видно cache hit ratio, сколько токенов читается из кэша, сколько записывается, и когда TTL протухнет. Помогает лучше понимать, сколько стоит каждый запрос и была ли инвалидация кеша ✔️ Rate limits 5h и 7d Показывает, сколько лимитов осталось и время до reset Формат сделал плотным, чтобы всё помещалось в одну строку. Если нада, то можно сделать мультистрочный статуслайн Цвета показывают уровень важности: норм / внимание / опасно Плюс внутри несколько доп хуков Ссылка на гитхаб https://github.com/ilia-pluzhnikov/claude-code-statusline
-
Радость же для любитей Claude Code. Установил себе.
-
repost ИИ переписал Bun с Zig на Rust PR: https://github.com/oven-sh/bun/pull/30412 (он настолько большой, что гитхаб его не открывает у меня) Последние несколько дней в чате очень плотно обсуждали последнюю ИИ новость. Один из альтернативных JS рантаймов bun полность переписали с zig на #rust. Переписывали, конечно же, используя исключительно агентов и ИИ (от компании Anthropic) . На все про все ушло 10 дней, тесты прошли, перформанс остался такой же. Звучит красиво? Красиво. Таймлайн истории 1. 2 декабря 2025 года Anthropic покупает bun и всю команду: https://bun.com/blog/bun-joins-anthropic 2. Команда Zig известна своим "No AI Slop" policy (прямо как django-modern-rest), некоторые люди сразу предсказывали конфликт интересов между Bun + Anthropic и Zig 3. 26 апреля 2026 года, команда bun форкает zig и добавляет туда поддержку параллельного семантического анализа https://x.com/bunjavascript/status/2048427636414923250 4. 9 мая открывается тот самый PR 5. 14 мая он успешно смерджен Важные детали А вот тут начинается интересное. - Для начала авторы Zig объяснили, что подход форка с семаналом некорректный, и что они сами работают над данной фичей, скоро она будет доступна: https://ziggit.dev/t/bun-s-zig-fork-got-4x-faster-compilation-times/15183/19 - Билды получились недетерминированные, о чем им и рассказала кор-команда. Тогда форк пришлось закопать, видимо Теперь посмотрим на качество PR. - Качество кода там примерно вот такое: https://github.com/oven-sh/bun/commit/d144fa6e20ab65d55add82ef3241609dcbb04cdc (то есть - никакое) - Файлы в нем даже были неотформатированы встроенным cargo fmt, что делается буквально в каждом Rust проекте: https://github.com/oven-sh/bun/pull/30695 - Ревью не было, потому что внутри PRа +1 009 257, -4 024 и 6000+ коммитов - unsafe в коде встречает 10487 раз (да, там много ffi, но все равно). Для сравнения в uv (кода правда меньше в 2 раза) - всего 73 раза - "Скорость работы осталось такой же" - довольно странный тезис, учитывая что zig и rust оба генерят код через LLVM, часто практически идентичный, заслуги ИИ здесь нет Выводы - Прикольно, что такое вообще можно сделать (с неограниченными токенами) - Как теперь bun будет владеть своей базой кода, кто сможет в ней разобраться и что-то пофиксить - вопрос открытый - Какой смысл во всем действии (кроме очевидного маркетинга) - вопрос открытый - Брать ли теперь bun в прод? Конечно нет Обсуждение: что вы думаете по данному вопросу? Стали бы использовать bun у себя в проекте в новом виде? | Поддержать | YouTube | GitHub | Чат |
-
edited Уже видели, что Антропики переписали bun с Zig на Rust? Тут Никита Соболев интересный разбор этой истории сделал. Вообще, мое почтение ребятам из Bun за смелость такое вмердживать - в PR'е на секундочку +1 009 257 строк и 6000+ коммитов. Я-то думал мои вымученные PR'ы на 10к+ строк - это много, а тут вон чего люди делают. Интересно будет почитать блогпост про этот процесс миграции - ждем.
-
repost Я забыл попросить вопросы к стриму "Каждый токен на счету"! 🙈 Задайте их, пожалуйста, в комментариях к этому посту. Кстати, Сергей, один из участников нашего стрима, опубликовал целую серию статей на Хабре про prefix_cache: 1. Экономика кэширования и особенности провайдеров 2. Самые частые анти-паттерны 3. Кэш в AI-агентах Материалы – огонь. Если прочитать их до стрима, то просмотр станет ещё интереснее. На стриме на практике проверим, как учёт особенностей prefix_cache влияет на расход токенов. Добавить событие в календарь Вопросы для стрима – в комментарии 😊
-
В это воскресенье в 18:00 МСК, 20:00 по Алматы поговорим с ребятами о том, как экономить на LLMках. Приходите. И пишите свои вопросы.
-
edited Safety Hooks моей мечты Наконец-то сделал хуки моей мечты - достаточно безопасные и практически без false-positive. Хуки вымученные, эволюционировали на граблях можно сказать. Собсна, любой, кто проработал с агентами какое-то время отлично знает, что иногда они чудят, удаляя лишнее - папки, докер образы или даже целые базы вместе с инфрой. И их важно вовремя ловить за руку. Хуки - это важнейшая часть работы с кодинг агентами, привносящая в них не только детерменированности, но и безопасности. Соответственно, когда хуков нет совсем или их мало, безопасность хромает - агент может уронить базу, сделать rm rf и тд, а если хуков слишком много , то... вы привыкаете клацать Enter на Allow, уже даже не читая о чем вообще сыр-бор. Поэтому, нужен тонкий баланс и хуками важно закрывать только действительно деструктивные, необратимые или критические действия. Ну, и сразу второй нюанс - для блоков я предпочитаю использовать ask хуки вместо блокирующих, т. к. агенты нынче слишком умные и получив блокирующий хук, наверняка найдет способ обойти ограничение (особенно если прилетел какой-нибудь prompt-injection), тк хуки обычно весьма примитивны. Короче-говоря, с учетом всех этих нюансов я написал свои opiniated-хуки, которые сам использую, они максимально сбалансированны по allow/ask с практически нулевым false positive - благодаря парсингу AST, а не regex'ам, которые обычно в хуках. Частично в основе лежит claude-code-safety-net (спасибо Рефату за наводку) весьма сильно переработанный и дополненный. Внутри: 1. rm — rm/unlink/shred вне cwd, по /etc, $HOME; через sudo, xargs, find -delete, pipe-to-shell. 2. infra — kubectl, docker, terraform, helm, gcp. 3. db — DROP/TRUNCATE/DELETE через psql/mysql; redis-cli FLUSHALL/SHUTDOWN, supabase. 4. paas — Railway, Fly, Heroku, Vercel, Netlify с destructive-глаголами (PocketOS-класс). 5. git — reset --hard, clean -fd, checkout . / restore ., branch -D, stash drop/clear, push -f, push --delete. Ссылка на репо: https://github.com/CodeAlive-AI/ai-driven-development/tree/main/hooks/balanced-safety-hooks - звезды как обычно приветствуются. Быстро ставятся так: curl -fsSL https://raw.githubusercontent.com/CodeAlive-AI/ai-driven-development/main/hooks/balanced-safety-hooks/install-prebuilt.sh | sh Из особенностей - написаны хуки на Go, поэтому выполняются буквально за несколько мс. Ну, и каждый, может поправить их под свои нужды, перекомпилячив бинарник. Еще из интересного - большинство хуков покрыты тестами. Кстати, для простого и корректного управления своими хуками у меня есть отдельный скилл hooks-management, который теперь поддерживает Claude Code, Codex и OpenCode. @ai_driven - AI-Driven Development
-
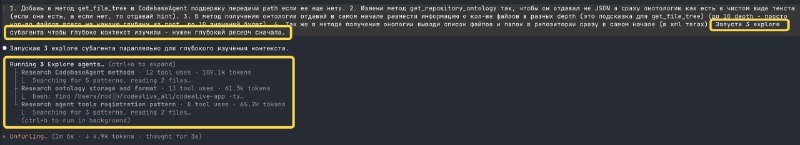
Улучшаем понимание контекста через субагентов Собственно, исследование кода (или чего угодно другого) через субагентов на сегодня один из наиболее полезных кейсов применения этих самых субагентов - для этих целей, кстати, в Claude Code есть встроенные агенты, в т. ч. Explore. Как правило, Claude Code (а с недавних пор еще и Codex) перед тем, как перейти к выполнению задачи запускает одного Explore субагента для сбора контекста. Но его явно бывает недостаточно для полноценного сбора, особенно на больших кодовых базах. К счастью, Claude Code позволяет прямо в запросе указать "запусти 3 сфокусированных субагента для глубого изучения контекста по задаче". Explore агент на Sonnet А если вы понимаете, что вопрос действительно сложный (запутанный), то можно просто попросить агента "запустить explore субагентов на Sonnet" и он так и сделает. Codex В Codex тоже с недавних пор появились субагенты и работают они примерно так же. На эту тему Денис DEKSDEN недавно делал большой обзор в своем канале. — Напомню, что для комфортной работы с агентами в больших кодовых базах могу горячо рекомендовать наш продукт CodeAlive - он дает агентам суперсилу использовать очень качественный семантический поиск, с помощью которого в течение пары сотен мс. агент находит 90%+ релевантной информации, затем быстро добирает то, чего не хватает - экономит и время и токены. Мы, кстати, обновили и MCP и скиллы, а еще вот-вот выкатим обновленный чатик с новым супер-агентом, который быстро и глубоко отвечает даже на самые сложные вопросы по кодовым базам на 1М+ строк кода и по сотням репозиториев сразу - для компаний с тоннами кода и документации просто бомбическая штука. Скорее всего, отдельный стрим сделаем на эту тему чуть позже. @ai_driven
-
repost 
Стрим про кодинг-интервью в эпоху агентов Классические форматы найма разработчиков в свете AI устаревают на глазах. Задачки с условного литкода оценивают навык, который в реальной работе и так редко использовался, да и сам процесс подготовки и проведения таких интервью давно уже превратился в специфический ритуал. Так что некоторые компании уже начали в пилотном режиме проводить AI-assisted coding interview, где кандидату выдаётся агент и задача по работе с реальной кодовой базой. Раньше мы чаще проверяли кандидата на то, может ли он писать код, а теперь всё больше становится интересно другое: как он декомпозирует задачу, ставит её агенту; как отличает хорошее решение от галлюцинаций; ревьюит результат и объясняет, почему сделано именно так. О чём хочется поговорить: ● какие форматы устаревают и какие становятся важнее; ● какие из них теперь покрываются ИИшкой; ● какие задачи в принципе подходят для такого формата; ● какого агента давать кандидату (hot take, что не очень умного :)); ● уровни и критерии оценки. Короче, сегодня стихийно соберемся вместе: ● Коля с канала AI и грабли ● Родион - AI-Driven Development. Родион Мостовой ● Максим - Этихлид ...и поразгоняем на эту тему. 1 мая (сегодня), 15:00 МСК: https://luma.com/r3hyapoy Кидайте ваши вопросы в комменты - постараемся и на них ответить на стриме. #ai #hiring #interview
-
edited Мок-собеседование Agentic Software Engineer (AI Automation) Мне все чаще попадаются новости о том, что кол-во кандидатов на программистские вакансии достигло какого-то аномального пика и этот разрыв продолжает расти, а востребованность обычных классических разработчиков стремительно падает. С другой стороны, появилась совершенно новая должность Agentic Software Engineer - это человек, который перестраивает разработку, да и весь SDLC на AI рельсы. Еще эта должность называется AI Automation Engineer, Agentic Advocate и т. д. - суть одна. Поскольку позиция новая, пока еще не очень понятно как на нее интервьюировать. К счастью, у Коли (автор канал @ai_grably, CTO и консультант) это понимание есть, поэтому мы решили провести первое публичное мок-интервью в рунете на эту позицию. Как обычно, проводим в формате стрима, онлайн. А пока мы все дружно ждем это важное событие, вот интересное чтиво о том, как меняет подходу к интервью инженеров в AI-эпоху: https://sierra.ai/blog/the-ai-native-interview Дата и время: 30 апреля 15:00 МСК, 17:00 Алматы, 13:00 CET. Длительность: 1.5 часа. Регистрация: https://luma.com/mm9dv0im @ai_driven
-
edited Не покупайте дорогие подписки на топовые модели (пост для вашего работодателя) Иначе вы рискуете затерять ваших разработчиков в исследованиях. Инсайт такой - подписки уровня 200$/mo обычно легко позволяют, скажем так, в параллель с основными задачами запускать разного рода эксперименты - когда агент не просто выводит гипотезы, но и запускает проверку каждой гипотезы в поисках наиболее оптимального решения - это может быть как определение оптимального алгоритма (ну например, стратегии чанкинга), так и поиск оптимального промпта/конфигурации системы. А в связке с субагентами это может быть особенно эффективным. Например, в апреле мы апдейтнулись с Claude Max 100$ до Claude Max 200$ (это х4 лимиты от 100) и это позволило мне свободно провести эксперименты по код ревью с новыми моделями (их сейчас вышло как никогда много) и поймать инсайт, что связка из 8 по-своему сфокусированных Qwen 3.6 Plus + DeepSeek 4 Flash ловят больше проблем при код ревью, чем одиночный Opus 4.7 - это при том, что часть проблем в нашем бенчмарке синьерного и даже экспертного уровня. А это, на секундочку, получается минимум 2-х кратная экономия. Но про этот кейс отдельно расскажу. Вообще, AI разработка прямо изобилует экспериментами - потому, что никто не знает как правильно. Больше того, то, что было "правильно" вчера, сегодня уже неактуально и замещено чем-то более эффективным (как в примере с ревью). Именно поэтому в этом дивном новом AI-мире разработчикам важно не только бюджет выделять на эксперименты, но и время - в принципе, компании смело могут легитимизировать 20-30% рабочего времени инженеров на эксперименты с AI - это, опять же, потому что даже один такой успешный эксперимент, может принести пользы больше, чем месяц усердной работы (здесь можно отметить, например, эксперименты по улучшению пайплайна тестов и верификации изменений, которые можно проводить бесконечно), и совсем хорошо когда инженеры хотя бы пару раз в месяц собираются на выделенный звонок и делятся находками и результатами своих экспериментов. В итоге, экономя на топовые подписки вы, возможно, теряете такие инсайты, которые потенциально могут сэкономить вам или вашему бизнесу гораздо больше. И тут я подчеркну, что токенов, доступных разработчику должно быть в избытке, тогда не будет постоянного страха, что из-за какого-либо эксперимента в сторону не хватит квоты на рабочие задачи и появляется свобода на творчество. — @ai_driven
-
Мы в эфире с Валерой: https://www.youtube.com/watch?v=cMRo2CYrRNQ
-
edited Митап с Валерой Ковальским про SGR, GraphRAG по коду и воркфлоу Валеры Ну, в AI индустрии Валеру не знает, наверно, только ленивый. Но на всякий случай: - Head of AI Engineering, автор канала @neuraldeep - Популяризатор SGR подхода (Scheme-Guided Reasoning) и автор популярного фреймворка-реализации SGR https://github.com/vamplabAI/sgr-agent-core (1100+ звезд!) - Автор 10+ опенсорс проектов, включая ру базу скиллов https://neuraldeep.ru - Наверное, один из наиболее востребованных экспертов по RAG и агентным системам в СНГ. Что будет на митапе? В прямом эфире создадим агента по SGR, который собирает связи по кодовой базе для последующего создания GraphRAG. Но самое интересное, что агента мы будем кодить вместе с Валерой по его воркфлоу (а значит, мы узнаем почему в узких кругах Валеру называют "120 минут"). Встречаемся сегодня в 14:00 по МСК онлайн. Ссылка на встречу: https://luma.com/dheyf8hl
- Older posts