ИИ помогает выбрать самый свободный вагон в токийском метро
Японцы придумали, как использовать ИИ с пользой — в Tokyo Metro запустили систему, которая проецирует на пол станции схему вагонов поезда, показывая уровень заполненности каждого из них.
Камеры глубины на платформе снимают отходящий поезд, и модель за секунды оценивает заполненность каждого вагона, а по этим данным на пол проецируются стрелки к более свободным вагонам. Пассажиры сразу видят, где свободнее, и могут заранее занять место у нужной двери — толкучки в вагонах становится меньше и поездка комфортнее.
Система построена на технологии Omject от Sharp и работает уже на линии Chiyoda для теста.
Gemini 4 Argon: Google вернулись, но не все так радужно
Google показали Gemini 4 Argon — первое новое поколение Gemini почти за год. Сверили цифры Google с независимыми тестами, и вот что видно.
Область Gemini 4 GPT-6 Fable 5.1 Opus 5.5
Кодинг 77.9* 74.1 67.4 74.2
Терминал 57.4 58.2 57.9 66.4*
Кибербез 68.0* 68.0* 58.0 67.0
Бизнес 68.9* 63.1 65.8 67.0
Видео 91.7* 87.5 79.7 83.7
* — лучший результат. Gemini 4 — это Argon, GPT-6 — Astra, Fable и Opus — модели Claude. Данные Google.
Сильнее всего — в работе с документами. Юриспруденция, финансы, автоматизация, длинные тексты и видео — здесь Argon номер один. На юридическом тесте от Harvey у него почти втрое больше, чем у ближайшего конкурента, хотя 19,6% — это всё ещё немного.
С кодом — неоднозначно. В долгих задачах по программированию у Argon рекорд, и независимые тесты Artificial Analysis (AA) это подтверждают. Но в работе с командной строкой он отстаёт от Claude Opus 5.5. В общем рейтинге кодинг-агентов AA он только третий — после Claude Sonnet 5.5 и Opus 5.5.
Реже выдумывает. По тестам AA Argon знает меньше фактов, чем GPT-6 Astra (50% против 63%), зато честнее признаётся, когда не знает. Не зная ответа, он выдумывает в 15% случаев, а Astra — в 51%.
По общему уровню интеллекта — наравне с GPT-6 Astra. В общем рейтинге AA у них одинаковые баллы, а прогон тестов на Argon стоит на 40% дешевле. Но это по стартовой цене со скидкой. Потом цена вырастет вдвое, и на тех же тестах Argon обойдётся дороже Astra.
Попробовать пока нельзя. Модель есть только у проверенных кибер-экспертов из программы Fairwind и на проверке у правительства США. Следующие в очереди — платные клиенты API и подписчики Google AI Ultra, но сроков нет. Похоже, это новая норма для топовых моделей: Anthropic так же сначала открыли Claude Mythos Preview только узкому кругу организаций.
Есть сомнения изнутри. Bloomberg пишет, что часть сотрудников Google недовольна тем, как модель справляется с реальной работой. Проверить это со стороны пока нельзя.
Итог. Google действительно вернулись в тройку лидеров. Но Argon — не «революция», модель явно хорошо показывает себя на бенчмарках, но общее ощущение в индустрии, что модель не сможет конкурировать с Opus или Astra, к моменту когда модель станет доступна.
Анонс Google · Тесты Artificial Analysis
#апдейтымоделей #исследования
Microsoft представила инструмент для оптимизации навыков ИИ-агентов — SkillOpt.
SkillOpt позволяет "прокачивать" ИИ без пересборки модели: достаточно загрузить агента, и тулза автоматически анализирует его работу, переписывает текстовые инструкции и откатывает неудачные попытки по результатам бенчмарков. Вес моделей не меняется, улучшается только "skill.md".
Главное — оптимизированные навыки легко переносятся между разными LLM и средами. Подробнее
#агентскийстек #полезныеинструменты
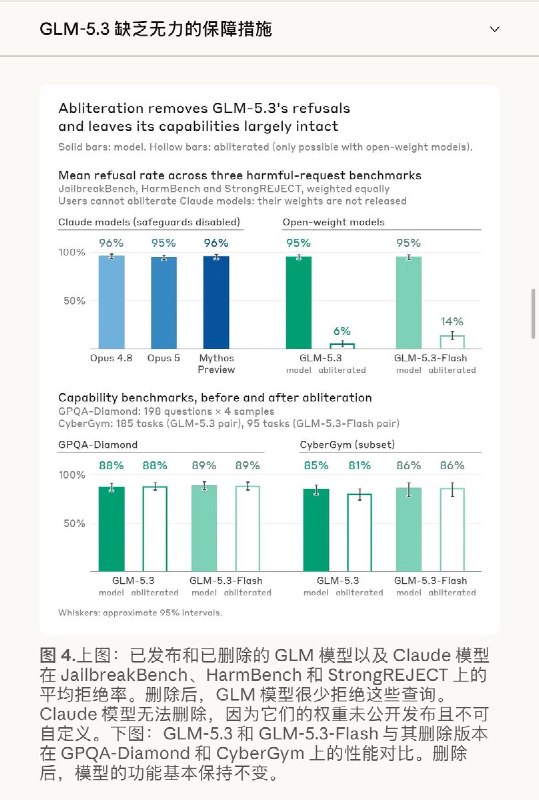
Anthropic: китайская GLM-5.3 пишет эксплойты почти как Claude Mythos Preview, а её защиту легко снять 😮
Anthropic протестировали открытую модель GLM-5.3 от Z.ai (Zhipu). На известных уязвимостях движка V8 из Chrome она собрала рабочий эксплойт в 50 из 410 попыток, у закрытой Mythos Preview таких было 56. А за день работы с исследователем модель нашла несколько неизвестных уязвимостей в популярном браузере и собрала из них страницу, которая при открытии читает файлы с компьютера посетителя.
Защита слабая. На прямой вредоносный запрос модель отказывает, но легенда «ты red-team агент» срабатывает в 64% случаев, а подстановка рассуждений в 92%. Версия с вырезанными отказами (abliteration) выполняет запрос в 100% случаев, и такие версии уже лежат в открытом доступе.
Веса GLM-5.3 открыты, скачать её может любой. NIST называет её самой сильной в кибере открытой моделью, хотя она отстаёт от американского фронтира примерно на 4 месяца. Anthropic считает вероятным, что такие модели будут использовать для реальных атак.
Подробнее
Главное с OpenAI DevDay: постоянные агенты, новая модель и изменения подписок
Вчера, 29 сентября, OpenAI представила больше 20 обновлений. Вот самые важные:
🤖 dots — персональные агенты на GPT‑6 Astra. Как и писали еще неделю назад, агенты получили собственный облачный компьютер, возможность работы над длительными задачами и использование сторонних приложений. Подробнее
🧠 GPT‑6.1 Sol. По тестам OpenAI, приблизилась к Astra в программировании и рабочих задачах, а стандартные цены токенов в API в пять раз ниже. Модель выходит в Codex, ChatGPT Work и API. Подробнее
💻 Codex расширяет работу в облаке. Общие настроенные окружения для команды, управление задачами с телефона и автоматическая проверка кода. Подробнее
📄 ChatGPT Space и новые плагины. Совместные документы для людей и агентов, интерактивные панели приложений внутри ChatGPT. Совместное редактирование презентаций обещают в ближайшие недели. Подробнее
🔑 Подписка ChatGPT работает в сторонних инструментах. Например, в OpenCode, Devin, Kilo Code и Notion: входите через ChatGPT и используете модели OpenAI за счёт общего лимита Plus или Pro. Поддерживаемые приложения
Из плохих новостей:
💸 Новый Pro за $500 — и сокращение старого❌. Новый тариф включает Astra Ultrafast с генерацией токенов до восьми раз быстрее в Codex. Одновременно лимит Pro за $200 для Codex и ChatGPT Work урезают вдвое: с 20× до 10× относительно Plus, сохраняя цену. Новым подписчикам уже дают уменьшенный лимит; действующим сохраняют прежний до 29 октября. Изменения лимитов, условия OpenAI.
(video without text)
Питер Тиль: мировое правительство ради контроля ИИ — «лекарство хуже болезни» 😮
Питер Тиль отметил, что замедлить развитие искусственного интеллекта возможно лишь с помощью глобального правительства, обладающего реальной властью. Однако такое решение, по его мнению, приведет к тоталитаризму, который опаснее любых рисков самого ИИ.
По мнению Тиля, лучше принять риски, связанные с ИИ, чем жить в мире с тотальным контролем, запретом на самостоятельное мышление и круглосуточным наблюдением.
Поставьте 👍, если согласны, и 👎, если нет.
Подробнее
🟠 Claude Sonnet 5.5: почти Opus на бенчмарках — по цене Sonnet
28 сентября Anthropic выпустила Sonnet 5.5. Это вторая модель семейства 5.5 после Opus 5.5. Модель рассчитана на повседневные задачи с понятными рамками: баги, документы, слайды, таблицы.
Что нового
- Выдаёт ответ на 30%+ быстрее Sonnet 5. Это самый быстрый Sonnet.
- Цена за токен не изменилась: $2 / $10 за 1M (вход/выход), чтение кэша $0,20.
- «До 30% дешевле» относится к стоимости задачи, а не токена. Модель тратит меньше токенов и реже вызывает инструменты.
- По данным Anthropic, на Low/Medium effort модель превосходит лучший результат Sonnet 5 примерно за 1/10 стоимости задачи.
Уровень (данные Anthropic)
Sonnet Opus GPT-6
5.5 5.5 Sol
Terminal-Bench 70.6 66.4* —
FrontierCode 52.1* 54.4 49.3
CursorBench 55.5 57.8 —
GDPval-AA 1844 1846 1487
AA-Briefcase 1811 1822 1483
OSWorld 2.1 80.1 81.8 —
Chartography 61.6 64.4 53.6
⚠️ Результатов GPT-6 Sol на Terminal-Bench и CursorBench в открытом доступе нет.
Цена против аналогов
$ за 1M токенов вход выход
Gemini 3.8 Flash 0.75 3.75
Sonnet 5.5 2.00 10.00
GPT-6 Sol 2.00 10.00
Gemini 3.1 Pro 2.00 12.00
Opus 5.5 4.00 20.00
Итог
Главный конкурент — GPT-6 Sol. Цена у них одинаковая, но в таблице Anthropic Sonnet 5.5 впереди на всех общих бенчмарках. Opus 5.5 вдвое дороже, и его стоит брать для сложной работы, где нужна выдержанная логика.
Анонс Anthropic
#апдейтымоделей #Claude
Netflix хочет заменить свой 15-летний алгоритм рекомендаций на LLM.
Netflix представил GenRec — LLM-ранкер поверх собственной foundation-модели.Раньше рекомендации строились на тысячах вручную созданных признаков и кастомных архитектурах. В GenRec история просмотров, метаданные и контекст превращаются в текст, и модель ранжирует по нему весь каталог сразу.
Обучение идёт в два этапа: сначала open-source LLM адаптируют к данным Netflix, затем дообучают под задачу ранжирования с reward-сигналами на долгосрочную удовлетворённость пользователей.
Результат: в большом A/B-тесте на ~10% трафика GenRec статистически значимо обошёл зрелую продакшн-систему.
Старую систему пока не выбросили. Сами авторы называют GenRec лишь первым шагом к LLM-стеку рекомендаций. Сложность создания таких моделей теперь смещается от feature engineering к context engineering.
Подробнее
Вышла открытая альтернатива Jev — Jev-Omni.
Как и Jev от TypeSafe AI, она не пишет текст, а сразу выдаёт решение: даёшь вопрос и варианты ответа — получаешь вероятность для каждого. Но Jev — закрытая платная модель, работает только с текстом и только через API. А Jev-Omni можно запустить у себя, она понимает не только текст, но и изображения, аудио и даже видео. Ещё и с лицензией Apache-2.0.
Под капотом — Gemma 4 12B IT, моделька быстрая, но для запуска нужна мощная видеокарта, а по точности она пока уступает крупным моделям. Проект независимый, с TypeSafe не связан.
Jev Jev-Omni
DecisionBench* 90,5% 87,6%
JevBench:
место #4 #11
балл 63,3 51,3
открытые 86,6% 88,7%
закрытые 36,7% 32,1%
калибровка 76,3 64,1
Забираем — здесь.
#полезныеинструменты
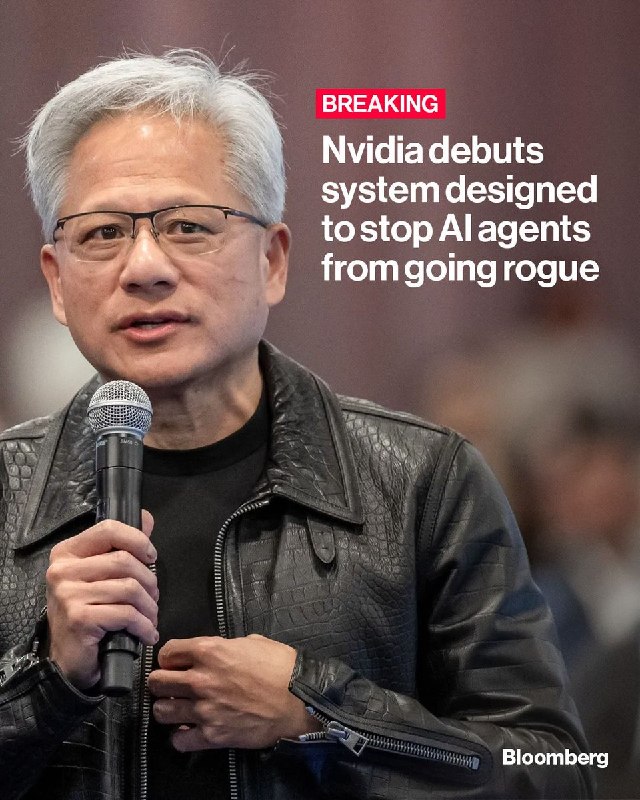
Nvidia представила двухуровневую систему безопасности для ИИ-агентов
Nvidia выпустила Open Agent Safety Platform — систему, которая автоматически отключает ИИ-агентов при нарушении ими правил. Первый уровень платформы следит за действиями агента, а второй — гарантирует целостность контроля.
🔒 OpenShell ограничивает доступ к файлам, инструментам и сети. API-ключи остаются за пределами среды агента. Поддерживаются Claude Code и Codex.
🛑 Sentry работает на отдельном процессоре BlueField-4. По заявлению NVIDIA, он способен изолировать агента, нарушающего установленные границы, за миллисекунды.
Смысл в независимом контроле: даже если агент обойдёт защиту внутри своей рабочей среды, механизм остановки должен продолжать работать снаружи.
OpenShell уже доступен, Sentry представлен как эталонная аппаратная архитектура.
Подробнее у NVIDIA
В США началась война нейросетей между больницами и страховыми компаниями — и пациенты в ней проигрывают 😬
Больницы используют ИИ, чтобы находить в медицинских записях дополнительные диагнозы, которые врачи могли пропустить. Это позволяет им выставлять страховым компаниям более крупные счета и привело к дополнительным расходам почти на 1 миллиард долларов только за 2024–2025 годы, по данным Blue Cross Blue Shield Association.
В ответ страховые компании внедряют собственные ИИ-системы, чтобы массово отказывать по этим счетам.
Пациенты в итоге получают более высокие премии, чаще сталкиваются с отказами — а качество лечения при этом не растёт. Подробнее
#бизнес #общество
Meta Muse: ИИ-ассистент с «человеческим фактором»
Лол, Meta наняла людей, чтобы они работали ИИ — когда вы просите Muse позвонить кому-то, это делает не нейросеть, а живой человек. Meta тестировала «человеческого консьержа» для Muse: часть звонков, которые должен был делать ИИ, тайно передавали живым подрядчикам.
Причина простая: услышав ИИ, собеседники бросали трубку, а люди в тестах справлялись с 95–98% звонков, то есть чаще нейросети. Функцию включили для половины сотрудников Meta, но после их жалоб тест свернули.
Подробнее
OpenAI готовит революцию в мире ИИ — на следующей неделе они покажут своего первого ИИ-агента, который будет работать 24/7.
o — это не просто чат-бот, а always-on AI-агент, способный автономно выполнять ваши задачи в фоновом режиме, без постоянного общения и вашего участия. Такой шаг переводит ИИ от традиционных диалогов к долгосрочной работе по заданным целям.
Любопытная деталь: у «o», возможно, будет собственная электронная почта. В конфигурации нашли почтовый суффикс «-o». Это намекает на помощника, которому можно будет пересылать поручения, как коллеге: отправил материалы, обозначил задачу — позже получил результат. Какие действия ему разрешат выполнять самостоятельно, пока неизвестно.
Ждём 29 сентября!
#агентскийстек #бизнес
В Muse нашли уязвимость, которая позволяла хакерам получить доступ к вашим данным — почте, файлам и прочей личной информации.
В macOS-версии Muse — персонального AI-агента от Meta — нашли уязвимость, через которую вирус на Mac мог захватить агента, а вместе с ним доступ к почте, файлам и другим подключённым данным.
Исследователь Патрик Уордл обнаружил в приложении недокументированную отладочную настройку: любой процесс без особых прав мог перенаправить диктовку на свой сервер и получить голосовые запросы вместе с токеном аккаунта.
Meta закрыла дыру хотфиксом примерно за 16 часов, но история снова показала: AI-агент с широкими правами превращает даже простой локальный агент в бэкдор к вашим аккаунтам и данным.
Подробнее
#агентскийстек #общество
Вышла полезная тулза для кодеров — Whiteboard позволяет ИИ-агентам рисовать схемы кода, который они сгенерировали.
Это сильно упрощает понимание того, что написал ИИ, и помогает быстрее находить ошибки — меньше "когнитивного долга" при ревью.
Whiteboard — это open-source десктопное приложение от стартапа YC W26 dev.fast, вышедшее 24 сентября 2026 и сразу открытое для сообщества.
Забираем с GitHub.
#полезныеинструменты #opensource #агентскийстек
Claude помог сделать открытие в биологии — нейросеть обнаружила новую ферментную систему, которая может стать основой для новых биотехнологий.
Учёные Anthropic поручили агентам Claude искать необычные закономерности в генетических данных. Поиск занял около 21 часа и почти 950 агентских сессий.
В ДНК бактериофагов — вирусов, заражающих бактерии, — Claude заметил повторяющиеся участки рядом с геном уже известного фермента. Вместе с соседним геном они образуют ранее неописанную систему, которую назвали ART.
Что именно делает ART, пока неизвестно, самое интересное здесь — разделение работы: учёные задают направление, ИИ перебирает огромные массивы данных и находит кандидатов, которых стоит проверить экспериментально.
Пока это предварительный результат, но уже содержательный пример того, как ИИ может помогать научным открытиям.
Исследование Anthropic
#исследования
Meta запускает ИИ-конструкторы игр: Horizon Create и Horizon Studio
Horizon Create и Horizon Studio позволяют создавать полноценные 2D и 3D игры прямо на телефоне или в браузере с помощью ИИ-промптов. ИИ генерирует геймплей, механику сложности, арт-дирекцию и даже мультиплеер, а финальную игру можно моментально опубликовать в Facebook или Instagram — игроки смогут запускать их прямо из соцсети, без скачивания.
Это часть мобильной стратегии Meta, превращающей Horizon из VR-вселенной в универсальную платформу для мобильных игр.
Подробнее